知识图谱完全指南——从原理到AI应用实战
📝
知识图谱(Knowledge Graph)是一种以图结构组织和表示知识的技术,通过实体、关系和属性的三元组形式,构建起人类可理解、机器可处理的知识网络。从Google的搜索优化到企业级AI应用,知识图谱正在成为智能系统的核心基础设施。
核心要点
•
知识图谱本质:以三元组(实体-关系-实体)形式组织的语义知识网络
•
核心优势:支持复杂关系推理、语义理解、知识发现
•
构建流程:实体识别 → 关系抽取 → 知识融合 → 图存储
•
主流工具:Neo4j、Amazon Neptune、TigerGraph
•
AI应用:增强RAG、智能问答、推荐系统、语义搜索
什么是知识图谱
知识图谱是一种结构化的语义知识库,它使用图的形式来表示实体之间的关系。其核心是**三元组(Triple)**结构:(主体, 谓词, 客体) 或 (Subject, Predicate, Object)。
三元组结构详解
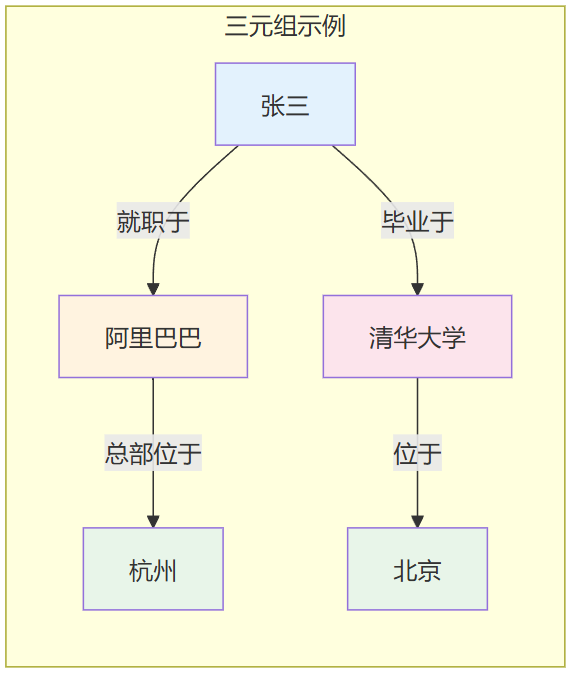
三元组组成要素:
#CwUkRBiXaUuM text { white-space: pre; }#CwUkRBiXaUuM .fb0 { stroke: var(--N900-FG, 0.15); }#CwUkRBiXaUuM .fb0 {stroke: rgba(31,35,41, 0.15)}#CwUkRBiXaUuM .fx0 { stroke-miterlimit: 10; }#CwUkRBiXaUuM .fx0 {stroke-miterlimit: 10}#CwUkRBiXaUuM .fa1 { fill: rgb(187, 191, 196); }#CwUkRBiXaUuM .fa1 {fill: rgb(187, 191, 196)}#CwUkRBiXaUuM .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#CwUkRBiXaUuM .fx1 {font-style: normal}#CwUkRBiXaUuM .fx2 { text-anchor: middle; }#CwUkRBiXaUuM .fx2 {text-anchor: middle}#CwUkRBiXaUuM .fx3 { dominant-baseline: central; }#CwUkRBiXaUuM .fx3 {dominant-baseline: central}#CwUkRBiXaUuM .fx4 { stroke: none; }#CwUkRBiXaUuM .fx4 {stroke: none}#CwUkRBiXaUuM .fc0 { fill: var(--text-caption); }#CwUkRBiXaUuM .fc0 {fill: #646a73}#CwUkRBiXaUuM .fa2 { fill: var(--text-link-disabled); }#CwUkRBiXaUuM .fa2 {fill: rgb(187, 191, 196)}#CwUkRBiXaUuM .fa3 { fill: rgb(246, 248, 250); }#CwUkRBiXaUuM .fa3 {fill: rgb(246, 248, 250)}#CwUkRBiXaUuM .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#CwUkRBiXaUuM .fx5 {font-style: normal}#CwUkRBiXaUuM .fx6 { text-anchor: start; }#CwUkRBiXaUuM .fx6 {text-anchor: start}#CwUkRBiXaUuM .fx7 { dominant-baseline: alphabetic; }#CwUkRBiXaUuM .fx7 {dominant-baseline: alphabetic}#CwUkRBiXaUuM .fc1 { fill: rgb(51, 51, 51); }#CwUkRBiXaUuM .fc1 {fill: rgb(51, 51, 51)}#CwUkRBiXaUuM .fx8 { font: 700 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#CwUkRBiXaUuM .fx8 {font-style: normal}#CwUkRBiXaUuM .fb1 { fill: var(--N900-FG, 0.15); }#CwUkRBiXaUuM .fb1 {fill: rgba(31,35,41, 0.15)}#CwUkRBiXaUuM .fb2 { fill: rgb(225, 228, 232); }#CwUkRBiXaUuM .fb2 {fill: rgb(225, 228, 232)}#CwUkRBiXaUuM .fa4 { fill: var(--bg-body); }#CwUkRBiXaUuM .fa4 {fill: #fff}ABC1234要素说明现实世界中的对象实体之间的联系实体的特征描述示例人物、公司、地点、产品就职于、位于、创建了年龄、成立时间、市值实体(Entity)关系(Relation)属性(Attribute)
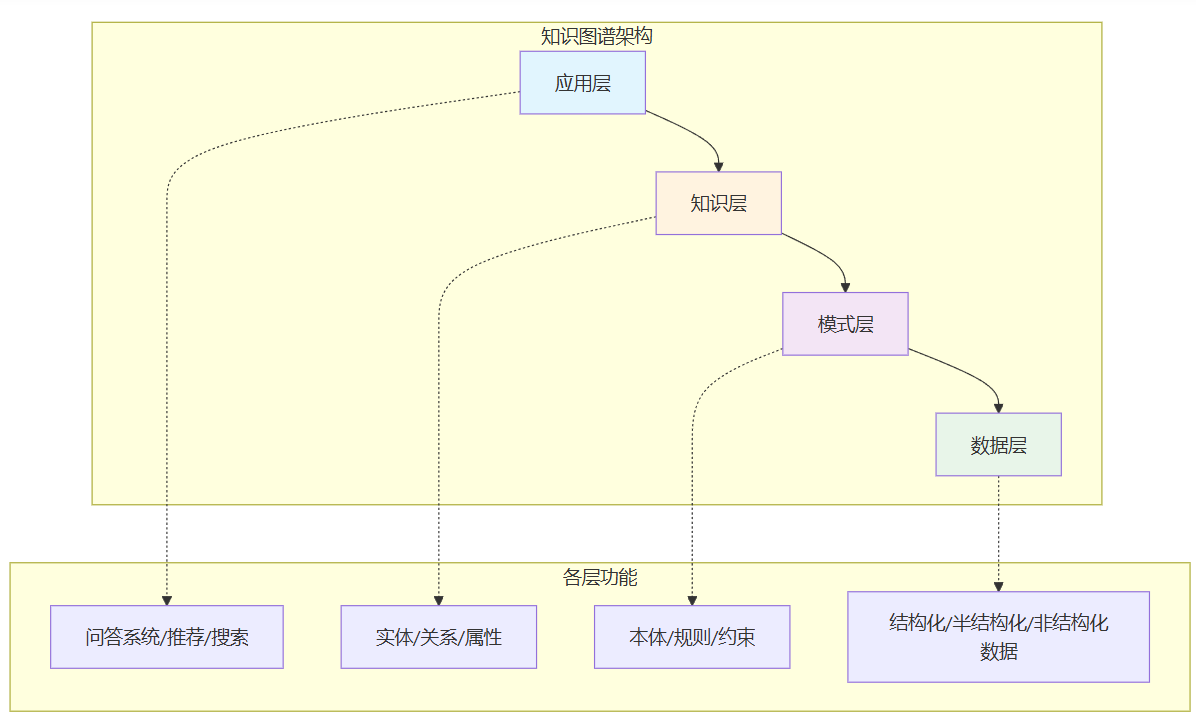
知识图谱的层次结构
知识图谱 vs 关系数据库
知识图谱和关系数据库都是数据存储方案,但设计理念和适用场景有本质区别。
详细对比
查询对比示例
场景:查找"张三的同事的朋友"
关系数据库(SQL):
代码块
SQL
SELECT DISTINCT f.name
FROM employees e1
JOIN employees e2 ON e1.company_id = e2.company_id
JOIN friendships fs ON e2.id = fs.person_id
JOIN persons f ON fs.friend_id = f.id
知识图谱(Cypher):
代码块
Plain Text
MATCH (zhang:Person {name: '张三'})-[:WORKS_AT]->(:Company)<-[:WORKS_AT]-(colleague)-[:FRIEND_OF]->(friend)
RETURN DISTINCT friend.name
知识图谱的查询更直观,性能在多跳关系场景下优势明显。
知识图谱构建流程
构建知识图谱是一个系统工程,主要包含以下关键步骤:
实体识别(Named Entity Recognition)
实体识别是从文本中识别出具有特定意义的实体,如人名、地名、机构名等。
代码块
Python
import spacy
from transformers import pipeline
nlp = spacy.load("zh_core_web_sm")
def extract_entities_spacy(text):
"""使用spaCy进行实体识别"""
doc = nlp(text)
entities = []
for ent in doc.ents:
关系抽取(Relation Extraction)
关系抽取是识别实体之间的语义关系。
代码块
Python
from transformers import AutoTokenizer, AutoModelForSequenceClassification
知识融合(Knowledge Fusion)
知识融合解决不同来源知识的整合问题,包括实体对齐和实体消歧。
图数据库详解
图数据库是存储和查询知识图谱的核心基础设施。
主流图数据库对比
Neo4j基础操作
代码块
Plain Text
// 创建节点
CREATE (p:Person {name: '张三', age: 30, title: '工程师'})
CREATE (c:Company {name: '阿里巴巴', industry: '互联网', founded: 1999})
// 创建关系
MATCH (p:Person {name: '张三'}), (c:Company {name: '阿里巴巴'})
CREATE (p)-[:WORKS_AT {since: 2020, role: '高级工程师'}]->(c)
知识图谱在AI中的应用
知识图谱与AI的结合正在创造新的应用范式,特别是在增强大语言模型能力方面。
应用场景概览
增强RAG系统
传统RAG基于向量相似度检索,知识图谱可以提供结构化的上下文信息。
代码块
Python
class KnowledgeGraphRAG:
def __init__(self, neo4j_driver, llm):
self.driver = neo4j_driver
智能问答系统(KBQA)
知识库问答系统可以回答需要多跳推理的复杂问题。
代码块
Python
class KBQASystem:
def __init__(self, neo4j_driver, llm):
self.driver = neo4j_driver
self.llm = llm
def parse_question(self, question):
"""使用LLM解析问题,生成Cypher查询"""
推荐系统
知识图谱可以提供丰富的语义信息,提升推荐的可解释性。
代码块
Python
def knowledge_aware_recommendation(user_id, neo4j_driver, top_k=10):
"""基于知识图谱的推荐"""
query = """
MATCH (u:User {id: $user_id})-[:PURCHASED]->(p:Product)-[:BELONGS_TO]->(c:Category)
MATCH (c)<-[:BELONGS_TO]-(recommended:Product)
WHERE NOT (u)-[:PURCHASED]->(recommended)
WITH recommended, count(*) as score
ORDER BY score DESC
LIMIT $top_k
RETURN recommended.name, recommended.description, score
GraphRAG技术详解
GraphRAG是微软提出的新一代RAG技术,通过构建知识图谱来增强检索和生成效果。
GraphRAG vs 传统RAG
GraphRAG工作流程
GraphRAG实现示例
代码块
Python
from neo4j import GraphDatabase
from openai import OpenAI
class GraphRAGSystem:
def __init__(self, neo4j_uri, neo4j_auth, openai_api_key):
self.driver = GraphDatabase.driver(neo4j_uri, auth=neo4j_auth)
self.client = OpenAI(api_key=openai_api_key)
代码实战
完整的知识图谱构建与查询系统
代码块
Python
from neo4j import GraphDatabase
from openai import OpenAI
import json
from typing import List, Dict, Anyclass KnowledgeGraphSystem:
"""完整的知识图谱系统实现"""def __init__(self, neo4j_uri: str, neo4j_user: str, neo4j_password: str, openai_api_key: str):
self.driver = GraphDatabase.driver(neo4j_uri, auth=(neo4j_user, neo4j_password))
self.client = OpenAI(api_key=openai_api_key)
def process_document(self, document: str) -> Dict[str, Any]:
"""处理文档,抽取知识"""
prompt = f"""
分析以下文档,抽取所有实体和它们之间的关系。
文档:
{document}
常见问题
知识图谱和本体(Ontology)有什么区别?
本体是知识图谱的模式层,定义了实体类型、关系类型和约束规则。知识图谱是本体的实例化,包含具体的实体和关系数据。可以理解为:本体是"类定义",知识图谱是"对象实例"。
如何处理知识图谱中的数据质量问题?
实体消歧:使用上下文信息区分同名实体
关系验证:通过规则或模型验证关系的正确性
时效性管理:为知识添加时间戳,定期更新
来源追溯:记录知识来源,支持可信度评估
冲突解决:建立知识冲突检测和解决机制
知识图谱的规模如何评估?
主要指标包括:
•
实体数量:图中节点的总数
•
关系数量:图中边的总数
•
实体类型数:不同类型实体的种类
•
关系类型数:不同类型关系的种类
•
平均度数:每个节点的平均连接数
•
图密度:实际边数与可能边数的比值
GraphRAG相比传统RAG有哪些优势?
全局理解能力:通过社区摘要理解整体主题
结构化推理:利用图结构进行多跳推理
可解释性:可以展示推理路径
知识一致性:避免检索片段之间的矛盾
复杂问题处理:更好地处理需要综合分析的问题
如何选择合适的图数据库?
考虑因素:
数据规模:小规模选Neo4j,大规模选TigerGraph或JanusGraph
查询复杂度:复杂图算法选TigerGraph
云部署需求:AWS生态选Neptune
开发效率:快速原型选Neo4j
成本预算:开源方案选Neo4j Community或JanusGraph
总结
知识图谱是连接数据与智能的桥梁,它通过结构化的方式组织知识,使机器能够理解和推理复杂的语义关系。
关键要点回顾
✅ 知识图谱 = 实体 + 关系 + 属性的三元组网络
✅ 相比关系数据库:更适合复杂关系查询和语义推理
✅ 构建流程:实体识别 → 关系抽取 → 知识融合 → 图存储
✅ AI应用:增强RAG、智能问答、推荐系统、语义搜索
✅ GraphRAG:结合知识图谱的新一代RAG技术