语义搜索完全指南——从原理到实战构建智能搜索系统
📈
语义搜索正在彻底改变我们获取信息的方式。从Google搜索的智能理解到电商平台的精准推荐,从企业知识库的智能问答到RAG系统的上下文检索,语义搜索技术已经渗透到我们数字生活的方方面面。本文将带你深入理解语义搜索的核心原理,并手把手教你构建一个高质量的语义搜索系统。
核心摘要
•
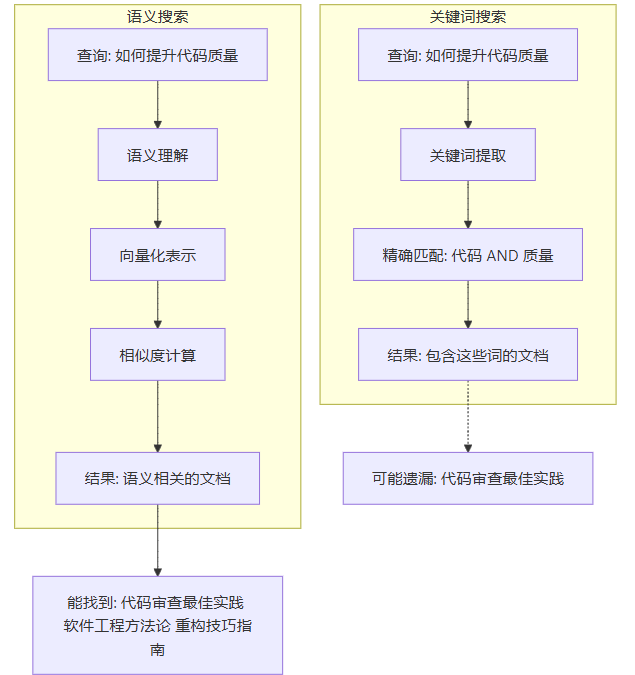
语义搜索基于语义理解而非关键词匹配,能够理解查询意图和上下文含义
•
核心技术:Embedding模型将文本转换为向量,通过向量相似度实现语义匹配
•
嵌入模型选择:通用场景用all-MiniLM-L6-v2,中文场景用BGE系列,高精度用OpenAI text-embedding-3
•
搜索策略:纯语义搜索适合问答场景,混合搜索(语义+关键词)适合通用搜索
•
性能优化:向量数据库索引、查询缓存、分块策略是关键
什么是语义搜索
语义搜索(Semantic Search)是一种基于自然语言理解的搜索技术,它不仅匹配关键词,更能理解查询的真实意图和上下文含义。
语义搜索 vs 关键词搜索
#wVCPrTBmwTNI text { white-space: pre; }#wVCPrTBmwTNI .fb0 { stroke: var(--N900-FG, 0.15); }#wVCPrTBmwTNI .fb0 {stroke: rgba(31,35,41, 0.15)}#wVCPrTBmwTNI .fx0 { stroke-miterlimit: 10; }#wVCPrTBmwTNI .fx0 {stroke-miterlimit: 10}#wVCPrTBmwTNI .fa1 { fill: rgb(187, 191, 196); }#wVCPrTBmwTNI .fa1 {fill: rgb(187, 191, 196)}#wVCPrTBmwTNI .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#wVCPrTBmwTNI .fx1 {font-style: normal}#wVCPrTBmwTNI .fx2 { text-anchor: middle; }#wVCPrTBmwTNI .fx2 {text-anchor: middle}#wVCPrTBmwTNI .fx3 { dominant-baseline: central; }#wVCPrTBmwTNI .fx3 {dominant-baseline: central}#wVCPrTBmwTNI .fx4 { stroke: none; }#wVCPrTBmwTNI .fx4 {stroke: none}#wVCPrTBmwTNI .fc0 { fill: var(--text-caption); }#wVCPrTBmwTNI .fc0 {fill: #646a73}#wVCPrTBmwTNI .fa2 { fill: var(--text-link-disabled); }#wVCPrTBmwTNI .fa2 {fill: rgb(187, 191, 196)}#wVCPrTBmwTNI .fa3 { fill: rgb(246, 248, 250); }#wVCPrTBmwTNI .fa3 {fill: rgb(246, 248, 250)}#wVCPrTBmwTNI .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#wVCPrTBmwTNI .fx5 {font-style: normal}#wVCPrTBmwTNI .fx6 { text-anchor: start; }#wVCPrTBmwTNI .fx6 {text-anchor: start}#wVCPrTBmwTNI .fx7 { dominant-baseline: alphabetic; }#wVCPrTBmwTNI .fx7 {dominant-baseline: alphabetic}#wVCPrTBmwTNI .fc1 { fill: rgb(51, 51, 51); }#wVCPrTBmwTNI .fc1 {fill: rgb(51, 51, 51)}#wVCPrTBmwTNI .fb1 { fill: var(--N900-FG, 0.15); }#wVCPrTBmwTNI .fb1 {fill: rgba(31,35,41, 0.15)}#wVCPrTBmwTNI .fb2 { fill: rgb(225, 228, 232); }#wVCPrTBmwTNI .fb2 {fill: rgb(225, 228, 232)}#wVCPrTBmwTNI .fa4 { fill: var(--bg-body); }#wVCPrTBmwTNI .fa4 {fill: #fff}ABC1234567对比维度匹配方式同义词处理查询理解长尾查询实现复杂度计算资源关键词搜索精确词汇匹配需要手动配置字面意思效果差低低语义搜索语义相似度匹配自动理解深层意图效果好中等较高
语义搜索能解决什么问题
问题1:同义词和近义词
用户搜索"汽车",关键词搜索找不到包含"轿车"、"机动车"的文档。语义搜索能理解这些词的语义关联。
问题2:查询意图理解
用户搜索"Python处理Excel",真实意图可能是寻找pandas或openpyxl的使用教程,而不仅仅是包含这些关键词的文档。
问题3:长尾查询
用户搜索"为什么我的程序运行很慢",这种自然语言查询在关键词搜索中几乎无法得到好的结果。
语义搜索的工作原理
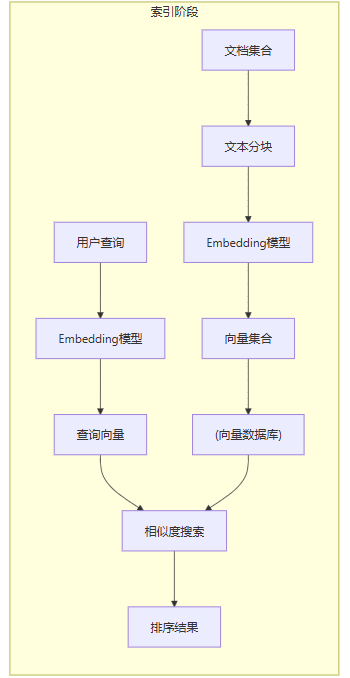
语义搜索的核心是将文本转换为向量表示,然后通过向量相似度来衡量语义相关性。
核心流程
关键步骤详解
文本向量化(Embedding)
Embedding模型将文本映射到高维向量空间,语义相似的文本在向量空间中距离更近。
向量相似度计算
最常用的相似度度量是余弦相似度,它计算两个向量夹角的余弦值。
代码块
Python
import numpy as np
from numpy.linalg import norm
def cosine_similarity(vec1, vec2):
return np.dot(vec1, vec2) / (norm(vec1) * norm(vec2))
similarity_01 = cosine_similarity(embeddings[0], embeddings[1])
similarity_02 = cosine_similarity(embeddings[0], embeddings[2])
print(f"语义搜索(中) vs 语义搜索(英): {similarity_01:.4f}")
print(f"语义搜索 vs 天气: {similarity_02:.4f}")
向量索引与检索
为了在大规模数据中快速检索,需要使用专门的向量索引算法(如HNSW、IVF)。
嵌入模型选择指南
选择合适的嵌入模型是构建高质量语义搜索系统的关键。
主流嵌入模型对比
模型选择决策树
本地模型 vs API模型
向量相似度计算详解
余弦相似度
余弦相似度是语义搜索中最常用的度量方式,它关注向量的方向而非大小。
代码块
Python
import numpy as np
from numpy.linalg import norm
def cosine_similarity(vec1, vec2):
dot_product = np.dot(vec1, vec2)
norm_product = norm(vec1) * norm(vec2)
return dot_product / norm_product
def batch_cosine_similarity(query_vec, doc_vecs):
欧氏距离
欧氏距离计算向量空间中两点的直线距离,距离越小表示越相似。
代码块
Python
def euclidean_distance(vec1, vec2):
return np.sqrt(np.sum((vec1 - vec2) ** 2))
def euclidean_to_similarity(distance, scale=1.0):
return 1 / (1 + distance * scale)
点积(内积)
当向量已归一化时,点积等价于余弦相似度,计算更快。
代码块
Python
def dot_product_similarity(vec1, vec2):
return np.dot(vec1, vec2)
def normalize_vectors(vectors):
norms = norm(vectors, axis=1, keepdims=True)
return vectors / norms
选择哪种度量方式
语义搜索 vs 全文搜索 vs 混合搜索
三种搜索方式对比
混合搜索实现
代码块
Python
from sentence_transformers import SentenceTransformer
from rank_bm25 import BM25Okapi
import numpy as np
class HybridSearch:
构建语义搜索系统实战
完整的语义搜索系统
代码块
Python
from sentence_transformers import SentenceTransformer
import chromadb
from chromadb.utils import embedding_functions
import numpy as np
from typing import List, Dictclass SemanticSearchEngine:
def __init__(self, model_name='BAAI/bge-base-zh-v1.5', persist_dir='./search_db'):
self.model = SentenceTransformer(model_name)
self.client = chromadb.PersistentClient(path=persist_dir)
self.embedding_fn = embedding_functions.SentenceTransformerEmbeddingFunction(
model_name=model_name
)
self.collection = self.client.get_or_create_collection(
name="documents",
文本分块策略
对于长文档,需要先进行分块再索引。
代码块
Python
from typing import Listclass TextChunker:
def __init__(self, chunk_size=500, chunk_overlap=50):
self.chunk_size = chunk_size
self.chunk_overlap = chunk_overlap
def chunk_by_size(self, text: str) -> List[str]:
优化语义搜索的技巧
查询优化
代码块
Python
class QueryOptimizer:
def __init__(self, model):
self.model = model
def expand_query(self, query: str, expansions: List[str]) -> str:
return f"{query} {' '.join(expansions)}"def rewrite_query(self, query: str) -> str:
rewrites = {
"怎么": "如何",
"咋": "怎样",
"啥": "什么"
}
for old, new in rewrites.items():
结果重排序
代码块
Python
class ResultReranker:
def __init__(self, cross_encoder_model='cross-encoder/ms-marco-MiniLM-L-6-v2'):
from sentence_transformers import CrossEncoder
self.cross_encoder = CrossEncoder(cross_encoder_model)
def rerank(self, query: str, results: List[Dict], top_k: int = 5) -> List[Dict]:
pairs = [[query, r['content']] for r in results]
scores = self.cross_encoder.predict(pairs)
for i, score in enumerate(scores):
results[i]['rerank_score'] = float(score)
缓存策略
代码块
Python
from functools import lru_cache
import hashlib
class SearchCache:
def __init__(self, max_size=1000):
self.cache = {}
self.max_size = max_size
def _hash_query(self, query: str) -> str:
return hashlib.md5(query.encode()).hexdigest()
def get(self, query: str):
key = self._hash_query(query)
常见问题
语义搜索和向量搜索是一回事吗?
向量搜索是语义搜索的技术实现方式。语义搜索是目标(理解语义进行检索),向量搜索是手段(通过向量相似度实现)。语义搜索通常基于向量搜索,但也可能结合其他技术如知识图谱。
如何评估语义搜索的效果?
常用评估指标包括:1)召回率(Recall@K):相关文档被检索到的比例;2)精确率(Precision@K):返回结果中相关文档的比例;3)MRR(Mean Reciprocal Rank):第一个相关结果排名的倒数;4)NDCG:考虑排序位置的综合指标。建议构建标注数据集进行定量评估。
语义搜索适合所有场景吗?
不是。以下场景关键词搜索可能更合适:1)精确查找(如订单号、产品编码);2)代码搜索(需要精确匹配语法);3)专业术语检索(术语有固定写法)。最佳实践是使用混合搜索,结合两者优势。
如何处理语义搜索中的冷启动问题?
冷启动指新文档或新领域缺乏训练数据的情况。解决方案:1)使用预训练的通用嵌入模型;2)在领域数据上微调模型;3)结合关键词搜索作为兜底;4)利用用户反馈持续优化。
语义搜索的延迟如何优化?
优化策略包括:1)使用轻量级嵌入模型(如all-MiniLM-L6-v2);2)向量数据库索引优化(调整HNSW参数);3)查询结果缓存;4)批量处理请求;5)使用GPU加速嵌入计算;6)预计算热门查询的结果。
总结
语义搜索是构建智能信息检索系统的核心技术。通过将文本转换为向量表示,我们能够实现真正理解用户意图的搜索体验。
关键要点回顾
✅ 语义搜索基于向量相似度,能理解同义词和查询意图
✅ 嵌入模型选择需要考虑语言、性能和成本的平衡
✅ 混合搜索结合关键词和语义搜索,适合通用场景
✅ 文本分块、查询优化、结果重排序是提升质量的关键
✅ 向量数据库是大规模语义搜索的必要组件