RAG进阶教程:从Naive RAG到GraphRAG的工程化演进
🤔
在 AI 应用开发中,RAG(检索增强生成)已经成为解决大模型“幻觉”和知识更新滞后的标配方案。然而,随着业务复杂度的提升,仅仅把文档切块存入向量数据库的 Naive RAG (朴素 RAG) 正在暴露出严重的局限性。
本文将带你跳出简单的向量比对,深入探讨 RAG 的工程化演进之路,并重点解析下一代检索范式:GraphRAG (基于图的检索增强生成)。
为什么 Naive RAG 会“迷失在文档海”?
在 Naive RAG 架构中,核心逻辑是 Chunking -> Embedding -> Vector Search -> Generation。这种模式在处理“事实提取类”问题(如:“公司去年的营收是多少?”)时表现优异。
但当面临以下挑战时,Naive RAG 往往束手无策:
跨文档的全局推理:例如“总结 A 部门和 B 部门在 Q3 季度的战略协同点”。由于 A 和 B 的信息分布在不同的文档块中,它们在向量空间中的距离可能很远,导致 Top-K 召回时无法同时命中。
术语歧义与语义冲突:同一个词(如“Apple”)在不同的文档块中可能指代水果,也可能指代公司。单纯的 Embedding 难以在没有全局上下文的情况下进行消歧。
“大海捞针”困境:当召回的文档块数量增多时,LLM 会面临严重的“中间丢失(Lost in the Middle)”效应。
为了解决这些问题,业界开始将目光投向了知识图谱(Knowledge Graph)。
GraphRAG:为向量插上“逻辑的翅膀”
GraphRAG 的核心思想是:在文档入库阶段,不只是进行简单的物理切块,而是利用 LLM 从文本中提取出 实体(Entities) 和 关系(Relationships),构建出一张全局的知识图谱。
2.1 核心原理解析
在 GraphRAG 中,检索过程发生了根本性的改变:
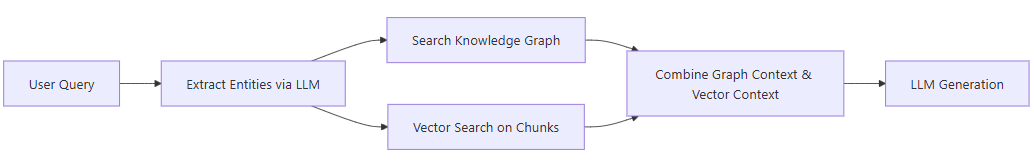
实体抽取 (Entity Extraction):将非结构化文本转化为结构化的三元组(如 [QubitTool, belongs_to, AI Tool Ecosystem])。
社区检测 (Community Detection):使用图算法(如 Leiden 算法)将图谱划分为不同的“社区”,并为每个社区生成层级摘要(Hierarchical Summaries)。
混合检索 (Hybrid Search):在查询时,既通过向量检索匹配具体的文本块,又通过图谱检索召回相关的实体关系和社区摘要。
实战:构建轻量级 GraphRAG 管道
下面我们将展示如何使用 LLM 进行简单的实体关系抽取,这是构建 GraphRAG 的第一步。
3.1 定义实体抽取的 Prompt
为了让 LLM 稳定地输出结构化数据,我们需要精心设计 Prompt,并配合文本编码转换工具确保中英文混合输入时的编码正确性。
代码块
Python
const extractionPrompt = `
你是一个专业的信息抽取引擎。请从以下文本中提取所有的实体及其关系。
输出格式必须是 JSON 数组,每个元素包含:
{
"head": "源实体",
"head_type": "实体类型(如: 人物, 组织, 概念)",
"relation": "关系(如: 投资, 属于, 创始人)",
"tail": "目标实体",
"tail_type": "实体类型"
}
文本内容:
3.2 向量查询与图谱查询的融合
在查询阶段,我们需要将向量数据库召回的文本片段与图数据库召回的邻居节点进行融合拼接。
代码块
JavaScript
async function hybridSearch(query) {
// 1. 向量检索获取相关文档块const vectorResults = await vectorDB.search(query, { topK: 3 });
// 2. 从 query 中提取核心实体const entities = await llm.extractEntities(query);
// 3. 图数据库检索获取实体的 1-hop 或 2-hop 关系const graphResults = await graphDB.query(`
MATCH (n)-[r]-(m)
WHERE n.name IN $entities
RETURN n, r, m
`, { entities });
// 4. 上下文组装const context = `
常见问题 (FAQ)
Q: 构建 GraphRAG 的成本是不是很高?
A: 是的。GraphRAG 在构建索引阶段需要频繁调用 LLM 进行实体抽取,成本通常是 Naive RAG 的数倍。建议仅在需要处理复杂逻辑推理、全局总结或对准确率要求极高的业务场景中使用。
Q: 如何处理图谱中提取出的重复实体?
A: 实体消歧(Entity Resolution)是构建图谱的关键。通常可以通过计算实体名称的Hash 散列值并结合语义相似度来进行合并。
Q: 什么时候不建议使用 GraphRAG?
A: 如果你的应用场景主要是简单的“QA 问答”(如:查询某员工的联系方式、查找特定 API 的参数),Naive RAG 配合良好的 Rerank 模型已经足够,引入图谱反而会增加系统延迟和复杂度。
总结
从 Naive RAG 到 GraphRAG 的演进,标志着 AI 检索技术从“寻找相似片段”向“理解全局逻辑”的跨越。通过将向量的模糊匹配与图谱的精确关系相结合,我们可以构建出更强大、更不易产生幻觉的 AI 知识库系统。