RAG检索增强生成完全指南——让AI更智能的关键技术
🎧
大语言模型(LLM)虽然强大,但存在知识截止日期、幻觉问题和领域知识不足等局限。RAG(Retrieval-Augmented Generation,检索增强生成)技术通过将外部知识库与LLM结合,有效解决了这些问题,成为构建企业级AI应用的核心技术。
核心要点
•
RAG本质:检索相关文档 + 增强LLM上下文 = 更准确的生成结果
•
核心组件:检索器(Retriever)+ 生成器(Generator)
•
关键技术:向量嵌入(Embedding)、语义搜索、上下文注入
•
主要优势:实时知识更新、减少幻觉、可追溯来源、成本更低
•
适用场景:企业知识库问答、文档智能检索、客服机器人、专业领域助手
什么是RAG
RAG(Retrieval-Augmented Generation)是一种将信息检索与文本生成相结合的AI技术架构。它的核心思想是:在LLM生成回答之前,先从外部知识库中检索相关信息,将这些信息作为上下文提供给模型,从而生成更准确、更有依据的回答。
RAG解决的核心问题
#pNhlzUxbIqQN text { white-space: pre; }#pNhlzUxbIqQN .fb0 { stroke: var(--N900-FG, 0.15); }#pNhlzUxbIqQN .fb0 {stroke: rgba(31,35,41, 0.15)}#pNhlzUxbIqQN .fx0 { stroke-miterlimit: 10; }#pNhlzUxbIqQN .fx0 {stroke-miterlimit: 10}#pNhlzUxbIqQN .fa1 { fill: rgb(187, 191, 196); }#pNhlzUxbIqQN .fa1 {fill: rgb(187, 191, 196)}#pNhlzUxbIqQN .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#pNhlzUxbIqQN .fx1 {font-style: normal}#pNhlzUxbIqQN .fx2 { text-anchor: middle; }#pNhlzUxbIqQN .fx2 {text-anchor: middle}#pNhlzUxbIqQN .fx3 { dominant-baseline: central; }#pNhlzUxbIqQN .fx3 {dominant-baseline: central}#pNhlzUxbIqQN .fx4 { stroke: none; }#pNhlzUxbIqQN .fx4 {stroke: none}#pNhlzUxbIqQN .fc0 { fill: var(--text-caption); }#pNhlzUxbIqQN .fc0 {fill: #646a73}#pNhlzUxbIqQN .fa2 { fill: var(--text-link-disabled); }#pNhlzUxbIqQN .fa2 {fill: rgb(187, 191, 196)}#pNhlzUxbIqQN .fa3 { fill: rgb(246, 248, 250); }#pNhlzUxbIqQN .fa3 {fill: rgb(246, 248, 250)}#pNhlzUxbIqQN .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#pNhlzUxbIqQN .fx5 {font-style: normal}#pNhlzUxbIqQN .fx6 { text-anchor: start; }#pNhlzUxbIqQN .fx6 {text-anchor: start}#pNhlzUxbIqQN .fx7 { dominant-baseline: alphabetic; }#pNhlzUxbIqQN .fx7 {dominant-baseline: alphabetic}#pNhlzUxbIqQN .fc1 { fill: rgb(51, 51, 51); }#pNhlzUxbIqQN .fc1 {fill: rgb(51, 51, 51)}#pNhlzUxbIqQN .fx8 { font: 700 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#pNhlzUxbIqQN .fx8 {font-style: normal}#pNhlzUxbIqQN .fb1 { fill: var(--N900-FG, 0.15); }#pNhlzUxbIqQN .fb1 {fill: rgba(31,35,41, 0.15)}#pNhlzUxbIqQN .fb2 { fill: rgb(225, 228, 232); }#pNhlzUxbIqQN .fb2 {fill: rgb(225, 228, 232)}#pNhlzUxbIqQN .fa4 { fill: var(--bg-body); }#pNhlzUxbIqQN .fa4 {fill: #fff}ABC123456问题传统LLM训练数据有时效性可能编造不存在的事实通用知识,专业性不足无法验证信息来源需要重新训练模型RAG方案实时检索最新信息基于真实文档生成接入专业知识库提供引用来源仅需更新知识库知识截止幻觉问题领域知识可追溯性更新成本
RAG的工作原理

RAG核心架构
一个完整的RAG系统由两大核心模块组成:检索器(Retriever)和生成器(Generator)。
系统架构图
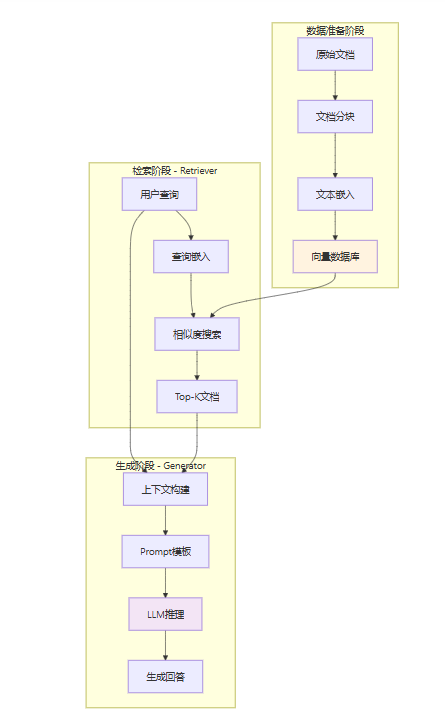
检索器(Retriever)
检索器负责从知识库中找到与用户查询最相关的文档片段。
检索方法对比:
#kSqKIdrbUfJv text { white-space: pre; }#kSqKIdrbUfJv .fb0 { stroke: var(--N900-FG, 0.15); }#kSqKIdrbUfJv .fb0 {stroke: rgba(31,35,41, 0.15)}#kSqKIdrbUfJv .fx0 { stroke-miterlimit: 10; }#kSqKIdrbUfJv .fx0 {stroke-miterlimit: 10}#kSqKIdrbUfJv .fa1 { fill: rgb(187, 191, 196); }#kSqKIdrbUfJv .fa1 {fill: rgb(187, 191, 196)}#kSqKIdrbUfJv .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#kSqKIdrbUfJv .fx1 {font-style: normal}#kSqKIdrbUfJv .fx2 { text-anchor: middle; }#kSqKIdrbUfJv .fx2 {text-anchor: middle}#kSqKIdrbUfJv .fx3 { dominant-baseline: central; }#kSqKIdrbUfJv .fx3 {dominant-baseline: central}#kSqKIdrbUfJv .fx4 { stroke: none; }#kSqKIdrbUfJv .fx4 {stroke: none}#kSqKIdrbUfJv .fc0 { fill: var(--text-caption); }#kSqKIdrbUfJv .fc0 {fill: #646a73}#kSqKIdrbUfJv .fa2 { fill: var(--text-link-disabled); }#kSqKIdrbUfJv .fa2 {fill: rgb(187, 191, 196)}#kSqKIdrbUfJv .fa3 { fill: rgb(246, 248, 250); }#kSqKIdrbUfJv .fa3 {fill: rgb(246, 248, 250)}#kSqKIdrbUfJv .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#kSqKIdrbUfJv .fx5 {font-style: normal}#kSqKIdrbUfJv .fx6 { text-anchor: start; }#kSqKIdrbUfJv .fx6 {text-anchor: start}#kSqKIdrbUfJv .fx7 { dominant-baseline: alphabetic; }#kSqKIdrbUfJv .fx7 {dominant-baseline: alphabetic}#kSqKIdrbUfJv .fc1 { fill: rgb(51, 51, 51); }#kSqKIdrbUfJv .fc1 {fill: rgb(51, 51, 51)}#kSqKIdrbUfJv .fx8 { font: 700 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#kSqKIdrbUfJv .fx8 {font-style: normal}#kSqKIdrbUfJv .fb1 { fill: var(--N900-FG, 0.15); }#kSqKIdrbUfJv .fb1 {fill: rgba(31,35,41, 0.15)}#kSqKIdrbUfJv .fb2 { fill: rgb(225, 228, 232); }#kSqKIdrbUfJv .fb2 {fill: rgb(225, 228, 232)}#kSqKIdrbUfJv .fa4 { fill: var(--bg-body); }#kSqKIdrbUfJv .fa4 {fill: #fff}ABCD1234方法原理关键词匹配向量相似度结合两者优点速度快、可解释语义理解强效果最佳缺点无法理解语义需要嵌入模型实现复杂稀疏检索(BM25)密集检索(Dense)混合检索(Hybrid)
生成器(Generator)
生成器基于检索到的上下文和用户问题,生成最终回答。
代码块
Python
prompt_template = """
基于以下参考信息回答用户问题。如果参考信息中没有相关内容,请明确说明。
参考信息:
{context}
用户问题:{question}
回答:
"""
向量数据库详解
向量数据库是RAG系统的核心基础设施,负责存储和检索文档的向量表示。
向量嵌入原理
向量嵌入(Embedding)将文本转换为高维向量空间中的点,语义相似的文本在向量空间中距离更近。
主流向量数据库对比
相似度计算方法
代码块
Python
import numpy as np
def cosine_similarity(vec1, vec2):
"""余弦相似度:最常用的方法"""return np.dot(vec1, vec2) / (np.linalg.norm(vec1) * np.linalg.norm(vec2))
def euclidean_distance(vec1, vec2):
"""欧氏距离:距离越小越相似"""return np.linalg.norm(vec1 - vec2)
def dot_product(vec1, vec2):
"""点积:向量已归一化时等价于余弦相似度"""return np.dot(vec1, vec2)
RAG vs 微调对比
RAG和微调(Fine-tuning)是增强LLM能力的两种主要方法,各有优劣。
详细对比
表格加载中...
选择建议
RAG实现步骤
步骤1:文档准备与分块
文档分块是RAG的关键步骤,分块策略直接影响检索效果。
代码块
Python
from langchain.text_splitter import RecursiveCharacterTextSplitter
def split_documents(documents, chunk_size=500, chunk_overlap=50):
"""
文档分块策略
- chunk_size: 每块大小,建议300-1000字符
- chunk_overlap: 重叠部分,保持上下文连贯
"""
splitter = RecursiveCharacterTextSplitter(
chunk_size=chunk_size,
chunk_overlap=chunk_overlap,
separators=["\n\n", "\n", "。", "!", "?", ";", " "]
)
分块策略建议:
步骤2:向量嵌入
代码块
Python
from langchain.embeddings import OpenAIEmbeddings, HuggingFaceEmbeddings
openai_embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
步骤3:向量存储
代码块
Python
from langchain.vectorstores import Chroma
vectorstore = Chroma.from_documents(
documents=chunks,
embedding=embeddings,
persist_directory="./chroma_db"
)
步骤4:检索与生成
代码块
Python
from langchain.chains import RetrievalQA
from langchain_openai import ChatOpenAI
llm = ChatOpenAI(model="gpt-4-turbo", temperature=0)
qa_chain = RetrievalQA.from_chain_type(
llm=llm,
chain_type="stuff",
retriever=vectorstore.as_retriever(search_kwargs={"k": 5}),
return_source_documents=True
)
result = qa_chain.invoke({"query": "什么是RAG技术?"})
print(result["result"])
Python代码实战
完整RAG系统实现
代码块
Python
import os
from typing import List, Dict, Anyfrom langchain.document_loaders import DirectoryLoader, TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import OpenAIEmbeddings
from langchain.vectorstores import Chroma
from langchain_openai import ChatOpenAI
from langchain.prompts import PromptTemplate
from langchain.chains import RetrievalQA
class RAGSystem:
"""完整的RAG系统实现"""def __init__(
self,
embedding_model: str = "text-embedding-3-small",
llm_model: str = "gpt-4-turbo",
persist_directory: str = "./rag_db"):
self.embeddings = OpenAIEmbeddings(model=embedding_model)
高级检索策略实现
代码块
Python
from langchain.retrievers import ContextualCompressionRetriever
from langchain.retrievers.document_compressors import LLMChainExtractor
class AdvancedRAGSystem(RAGSystem):
"""高级RAG系统:支持多种检索策略"""def setup_hybrid_retriever(self, k: int = 5):
"""混合检索:结合语义搜索和关键词搜索"""from langchain.retrievers import BM25Retriever, EnsembleRetriever
RAG最佳实践
文档预处理优化
•
清洗数据:去除噪声、格式化文本
•
元数据增强:添加来源、时间、类别等信息
•
结构化处理:保留标题、段落等结构信息
检索策略优化
提示工程优化
代码块
Python
optimized_prompt = """
你是{domain}领域的专家助手。
## 任务
评估与监控
关键指标:
•
检索准确率:Top-K文档的相关性
•
回答质量:准确性、完整性、流畅性
•
延迟:端到端响应时间
•
成本:API调用和存储成本
常见问题
RAG和传统搜索引擎有什么区别?
传统搜索引擎返回文档列表,用户需要自己阅读和总结;RAG系统则直接生成综合性回答,并可以进行推理和总结。RAG结合了检索的精确性和LLM的生成能力。
如何处理RAG中的幻觉问题?
使用明确的提示词要求模型只基于检索内容回答
实现答案验证机制,检查生成内容与源文档的一致性
要求模型在不确定时明确表示
提供引用来源,方便用户验证
RAG系统的检索效果不好怎么办?
优化文档分块策略,调整chunk_size
尝试不同的嵌入模型
使用混合检索策略
添加重排序步骤
优化查询预处理
RAG适合处理多语言内容吗?
是的,但需要注意:
使用支持多语言的嵌入模型
考虑跨语言检索需求
可能需要语言检测和翻译模块
如何降低RAG系统的成本?
使用本地嵌入模型(如BGE、M3E)
实现缓存机制,避免重复计算
优化检索数量,减少上下文长度
使用更经济的LLM模型处理简单查询
总结
RAG技术是构建智能AI应用的关键技术,它有效解决了LLM的知识局限性问题,让AI系统能够基于最新、最准确的信息生成回答。
关键要点回顾
✅ RAG = 检索(Retrieval)+ 增强(Augmented)+ 生成(Generation)
✅ 核心组件:向量数据库 + 嵌入模型 + LLM
✅ 相比微调:更新成本低、可追溯、无需标注数据
✅ 关键优化:分块策略、检索策略、提示工程
✅ 适用场景:知识库问答、文档检索、智能客服