AI 搜索引擎架构解析:从 Perplexity 到垂直领域 AI 搜索
🔎
搜索正在经历自 Google 诞生以来最深刻的范式变革。以 Perplexity AI、SearchGPT 为代表的新一代 AI 搜索引擎,将传统网页检索与大语言模型(LLM)驱动的答案合成融为一体,用户不再需要在十几个蓝色链接中翻找信息,而是直接获得一段带引用来源的完整答案。本文将深入剖析 AI 搜索引擎的核心架构——从查询理解到多源检索,从来源排序到答案合成——并提供完整的代码实现方案和垂直领域落地策略。
核心要点
•
架构范式:AI 搜索引擎的核心是一条"查询理解 → 多源检索 → 来源排序 → 答案合成 → 追问探索"的 RAG 管线
•
关键技术:查询改写(Query Rewriting)、并行多源检索、基于 LLM 的来源评估与去重、流式答案合成与内联引用
•
产品格局:Perplexity 以学术级引用闻名,SearchGPT 依托 OpenAI 生态,Gemini 深度整合 Google 索引,各有差异化优势
•
垂直机会:通用 AI 搜索解决广度问题,垂直领域 AI 搜索(法律、医疗、代码)通过专业知识库和领域模型提供深度答案
•
开发门槛降低:借助 Tavily、LangChain、LlamaIndex 等工具,开发者可以在一个下午内搭建 AI 搜索原型
AI 搜索引擎的崛起
从"十个蓝色链接"到直接答案
过去 25 年,搜索引擎的交互模式几乎没有改变:输入关键词 → 获得一页排序的链接 → 逐个点击翻阅。用户完成一次信息需求,平均需要点击 3-5 个链接、花费 5-10 分钟。
2024-2025 年,AI 搜索引擎彻底打破了这一范式。RAG(检索增强生成) 技术让搜索引擎能够在检索网页信息的同时,利用 LLM 将多个来源的关键内容合成为一段连贯、完整、带引用的答案。用户提出问题后,直接看到"答案"而非"链接列表"。
这一变革背后的技术推手包括三个层面:
LLM 能力的跃升:GPT-4o、Claude 3.5、Gemini 等模型具备了处理长上下文(128K+ tokens)的能力,可以同时"消化"数十篇网页内容
语义搜索 的成熟:向量数据库 和 Embedding 模型使得基于语义的检索匹配成为可能,摆脱了纯关键词匹配的局限
搜索 API 的开放:Bing、Google、Brave 等搜索引擎开放了 API,使得 AI 搜索系统可以站在传统搜索的"肩膀上"获取网页结果
AI 搜索的市场格局
截至 2026 年,AI 搜索市场已经形成多级竞争格局:
#EBPzqRuVWWfL text { white-space: pre; }#EBPzqRuVWWfL .fb0 { stroke: var(--N900-FG, 0.15); }#EBPzqRuVWWfL .fb0 {stroke: rgba(31,35,41, 0.15)}#EBPzqRuVWWfL .fx0 { stroke-miterlimit: 10; }#EBPzqRuVWWfL .fx0 {stroke-miterlimit: 10}#EBPzqRuVWWfL .fa1 { fill: rgb(187, 191, 196); }#EBPzqRuVWWfL .fa1 {fill: rgb(187, 191, 196)}#EBPzqRuVWWfL .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#EBPzqRuVWWfL .fx1 {font-style: normal}#EBPzqRuVWWfL .fx2 { text-anchor: middle; }#EBPzqRuVWWfL .fx2 {text-anchor: middle}#EBPzqRuVWWfL .fx3 { dominant-baseline: central; }#EBPzqRuVWWfL .fx3 {dominant-baseline: central}#EBPzqRuVWWfL .fx4 { stroke: none; }#EBPzqRuVWWfL .fx4 {stroke: none}#EBPzqRuVWWfL .fc0 { fill: var(--text-caption); }#EBPzqRuVWWfL .fc0 {fill: #646a73}#EBPzqRuVWWfL .fa2 { fill: var(--text-link-disabled); }#EBPzqRuVWWfL .fa2 {fill: rgb(187, 191, 196)}#EBPzqRuVWWfL .fa3 { fill: rgb(246, 248, 250); }#EBPzqRuVWWfL .fa3 {fill: rgb(246, 248, 250)}#EBPzqRuVWWfL .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#EBPzqRuVWWfL .fx5 {font-style: normal}#EBPzqRuVWWfL .fx6 { text-anchor: start; }#EBPzqRuVWWfL .fx6 {text-anchor: start}#EBPzqRuVWWfL .fx7 { dominant-baseline: alphabetic; }#EBPzqRuVWWfL .fx7 {dominant-baseline: alphabetic}#EBPzqRuVWWfL .fc1 { fill: rgb(51, 51, 51); }#EBPzqRuVWWfL .fc1 {fill: rgb(51, 51, 51)}#EBPzqRuVWWfL .fb1 { fill: var(--N900-FG, 0.15); }#EBPzqRuVWWfL .fb1 {fill: rgba(31,35,41, 0.15)}#EBPzqRuVWWfL .fb2 { fill: rgb(225, 228, 232); }#EBPzqRuVWWfL .fb2 {fill: rgb(225, 228, 232)}#EBPzqRuVWWfL .fa4 { fill: var(--bg-body); }#EBPzqRuVWWfL .fa4 {fill: #fff}ABC12345层级通用 AI 搜索AI 增强传统搜索垂直领域 AI 搜索开发者工具代表产品Perplexity、SearchGPT、GeminiGoogle AI Overview、Bing CopilotConsensus(学术)、Harvey(法律)、Phind(代码)Tavily、Exa、You.com API核心策略替代/增强传统搜索引擎在传统搜索结果中嵌入 AI 答案聚焦特定领域,提供专业级答案提供 AI 搜索能力的 API 和 SDK
核心架构:AI 搜索管线
一个现代 AI 搜索引擎的核心是一条精心设计的多阶段管线(Pipeline)。以下是其完整架构:
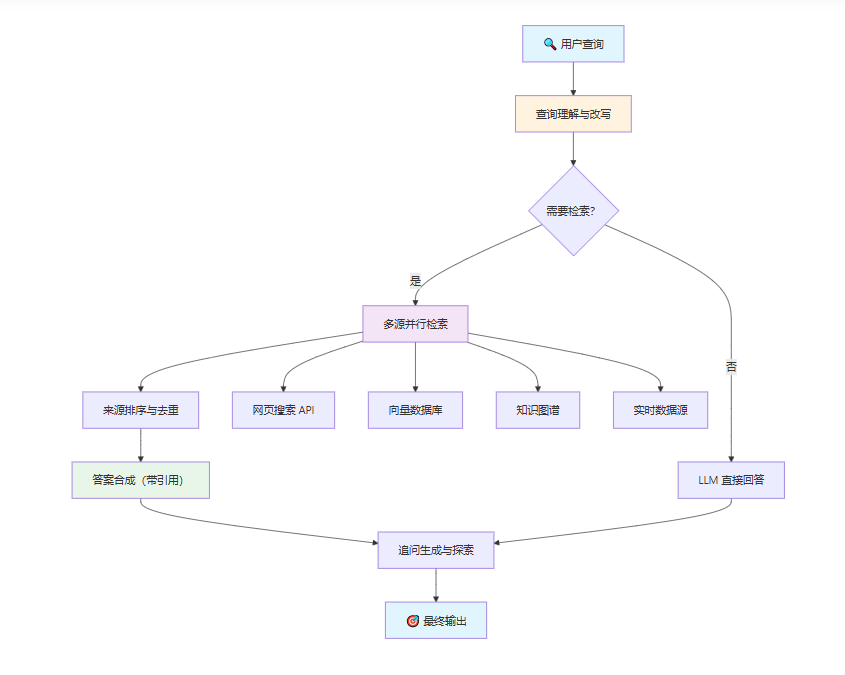
第一步:查询理解
查询理解是 AI 搜索管线的"大脑",决定了后续所有步骤的方向。它包含三个核心子任务:
意图分类(Intent Classification):将用户查询分为事实查询、比较分析、操作指南、观点探索等类型。不同类型的查询需要不同的检索策略和答案格式。
查询改写(Query Rewriting):用户输入的自然语言查询往往不适合直接用于检索。AI 搜索引擎会使用 LLM 将其改写为多个搜索友好的子查询:
code
代码块
Plain Text
原始查询: "Perplexity 是怎么做到的"
改写结果:
→ "Perplexity AI architecture technical design"
→ "Perplexity search engine RAG pipeline"
→ "How does Perplexity AI generate answers with citations"
时效性判断:对于"最新 iPhone 价格"这类查询,系统需要优先使用实时搜索 API;对于"量子计算的基本原理"这类查询,则可以依赖缓存的知识库。
AI 搜索引擎与传统搜索引擎最大的架构差异在于多源并行检索。系统不再依赖单一搜索索引,而是同时从多个数据源拉取信息:
第二步:多源检索
多源检索通过并行执行显著降低了端到端延迟。一个设计良好的系统可以在 200-500ms 内完成所有数据源的检索。
第三步:来源排序与去重
从多个数据源返回的结果往往有大量重复和噪声。来源排序模块执行以下操作:
去重(Deduplication):基于 URL 和内容相似度去除重复来源
相关性评分:使用 Cross-Encoder 或 LLM-as-Judge 对每个来源与查询的相关性评分
权威性评估:根据域名权威度、内容新鲜度、引用数量等信号评估来源质量
多样性保障:确保最终选择的来源覆盖不同视角,避免信息回音室
这一步的输出通常是 5-10 个高质量、去重后的来源,它们将作为 LLM 答案合成的上下文。
第四步:答案合成
答案合成是 AI 搜索的核心创新——将检索到的多个来源"编织"成一段连贯、准确、带内联引用的答案。这本质上是一个受约束的 RAG 生成任务:
code
代码块
Plain Text
系统提示词(简化版):
你是一个 AI 搜索引擎。基于以下检索到的来源,生成一段全面的答案。
规则:
1. 每个事实性陈述必须标注来源编号 [1], [2] 等
2. 如果来源之间存在矛盾,明确指出分歧
3. 不要编造来源中没有的信息
4. 以 Markdown 格式输出,包含适当的标题和列表
来源:
现代 AI 搜索引擎普遍采用流式输出(Streaming),答案逐字出现,极大提升了感知速度。
第五步:追问与探索
AI 搜索不是一次性交互,而是一个探索过程。在生成初始答案后,系统会基于当前查询和答案,自动生成 3-5 个追问建议(Follow-up Questions),引导用户深入探索。
这些追问建议通常由一个独立的 LLM 调用生成,其 prompt 会要求从不同角度(更深入、更广泛、更实际、更前沿)提出问题。
深度剖析:Perplexity 的工作原理
Perplexity AI 是当前最具代表性的 AI 搜索引擎。基于公开的技术博客和逆向分析,其架构可以概括为以下流程:
Perplexity 的几个关键技术选择:
自建索引 + 搜索 API 双轨制:Perplexity 不仅调用外部搜索 API,还维护了自己的网页爬取和索引系统,用于补充搜索 API 无法覆盖的长尾内容
多模型协同:查询理解使用轻量模型(低延迟),答案合成使用重量级模型(高质量),追问生成使用中等模型(平衡成本)
引用粒度精细化:不是简单地标注来源 URL,而是精确到段落甚至句子级别的引用定位
Pro Search 多轮推理:对复杂查询,Perplexity Pro 会执行多轮检索-推理循环,类似于 Agentic RAG 的自适应模式
AI 搜索引擎对比
动手构建你的 AI 搜索引擎
理解了架构原理,接下来让我们动手构建一个简化版的 AI 搜索引擎。
Python 实现
以下使用 LangChain + Tavily 搜索 API 实现一个完整的 AI 搜索管线:
代码块
Python
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
import asyncio
import httpx
# ========== 第一步:查询改写 ==========
query_rewriter = ChatOpenAI(model="gpt-4o-mini", temperature=0)
rewrite_prompt = ChatPromptTemplate.from_messages([
("system", """将用户的搜索查询改写为 3 个更精确的子查询。
输出格式:每行一个子查询,不要编号。"""),
("user", "{query}")
])
rewrite_chain = rewrite_prompt | query_rewriter | StrOutputParser()
JavaScript/TypeScript 实现
使用 Node.js 实现相同的 AI 搜索管线:
javascript
代码块
JavaScript
import OpenAI from "openai";
const openai = new OpenAI();
const TAVILY_API_KEY = process.env.TAVILY_API_KEY;
垂直领域 AI 搜索:行业专属应用
通用 AI 搜索引擎解决的是"广度"问题,而垂直领域 AI 搜索解决的是"深度"问题。通过整合行业专属知识库和领域微调模型,垂直 AI 搜索能提供远超通用搜索的专业答案质量。
垂直 AI 搜索与通用 AI 搜索的架构差异
典型垂直场景
法律 AI 搜索:检索法规条文、判例案例、学术论文,生成带法条引用的法律分析意见。关键挑战是引用的精确性和时效性。
医疗 AI 搜索:基于 PubMed、临床指南等权威医学数据库,生成循证医学级别的答案。需要严格的幻觉控制和免责声明。
代码 AI 搜索:如 Phind、Devv 等产品,基于 GitHub、Stack Overflow、官方文档等数据源,针对编程问题提供可执行的代码答案。
学术 AI 搜索:如 Consensus,专门检索学术论文并合成研究共识,适用于文献综述和研究趋势分析。
对 SEO 与内容策略的影响
AI 搜索引擎正在重塑内容消费的方式,这对 SEO 和内容策略产生了深远影响:
从"排名优化"到"被引用优化":在传统 SEO 中,目标是让页面出现在搜索结果的前几位。在 AI 搜索时代,目标变成了让内容被 AI 引擎选为引用来源。这意味着内容需要更加权威、结构化、事实密集。
结构化内容更容易被检索:AI 搜索引擎在处理结构化内容(清晰的标题层级、FAQ 段落、表格、定义列表)时效率更高。使用 Schema.org 标记和清晰的语义结构可以显著提高被引用的概率。
原创研究和第一手数据成为稀缺资源:AI 搜索引擎会优先引用包含原创数据、独立研究、专家观点的内容。纯搬运和改写内容的价值将大幅下降。
长尾查询成为新战场:AI 搜索引擎擅长回答复杂的长尾问题,这些问题在传统搜索中往往得不到好的答案。针对长尾查询创建深度内容是新的增长机会。
最佳实践
在设计和构建 AI 搜索系统时,以下五条最佳实践值得遵循:
查询改写是最高 ROI 的优化点。一个好的查询改写模块能将检索质量提升 30-50%。投入精力设计 few-shot 示例和领域感知的改写策略。
并行检索 + 异步架构是延迟控制的关键。AI 搜索管线中最大的延迟来源是网络 I/O。使用 asyncio(Python)或 Promise.all(JavaScript)并行化所有检索请求,将端到端延迟控制在 2-5 秒内。
引用质量决定用户信任。AI 搜索引擎的核心价值主张是"有据可查的答案"。如果引用不准确、链接失效或来源不权威,用户信任将迅速崩塌。投入资源建设来源验证和引用提取系统。
分级模型策略平衡成本与质量。查询理解和追问生成使用低成本小模型,答案合成使用高质量大模型。这种分级策略可以在不牺牲质量的前提下降低 60-70% 的 LLM 调用成本。
设计"可解释"的搜索体验。展示搜索过程(正在检索哪些来源、找到了多少结果、使用了哪些来源)能显著提升用户的信任感和满意度。Perplexity 的"来源面板"就是一个优秀的设计范例。
常见问题 (FAQ)
AI 搜索引擎是如何工作的?
AI 搜索引擎将网页检索与 LLM 驱动的答案合成相结合。系统首先解析用户查询并进行意图分类和改写,然后通过传统搜索 API 和 向量数据库 并行检索相关来源,对来源进行排序和去重后,使用大语言模型合成一段带内联引用的综合答案,最后生成追问建议引导用户深入探索。
AI 搜索和传统搜索有什么本质区别?
传统搜索引擎返回一组排序的链接列表,用户需要自行点击、阅读和综合信息。AI 搜索引擎则理解查询意图,从多个来源检索信息,并直接生成一段带引用的完整答案。核心差异在于:传统搜索的输出是"信息的索引",AI 搜索的输出是"信息本身"。
Perplexity AI 是怎么工作的?
Perplexity 使用多步管线架构:首先进行查询理解与改写,将用户问题分解为多个搜索子查询;然后并行调用 Bing API 和自建索引进行网页检索;接着对结果进行去重、排序和权威性评估;最后使用 LLM(如 GPT-4o、Claude)合成带精确引用的答案,并生成追问建议支持深度探索。其 Pro Search 模式还支持多轮推理和自适应检索。
自己构建 AI 搜索引擎需要哪些组件?
核心组件包括:用于网页检索的搜索 API(如 Tavily、Bing API)、用于 语义搜索 匹配的向量数据库、用于答案合成的 LLM、以及引用提取和验证系统。LangChain、LlamaIndex 等框架提供了现成的模块,Tavily 等专为 AI Agent 设计的搜索 API 进一步降低了开发门槛。一个最小可用原型可以在数小时内搭建完成。
垂直领域 AI 搜索有哪些优势?
垂直领域 AI 搜索在专业性、准确性和引用精度上远超通用 AI 搜索。它通过整合行业专属数据库(如法律法规库、医学论文库、代码仓库)、使用领域微调模型、以及实施严格的幻觉控制策略,能够提供专家级别的深度答案。在法律、医疗等高风险领域,这种专业级准确性是不可替代的。
总结
AI 搜索引擎正在从"搜索"走向"回答",从"链接列表"走向"知识合成"。其核心架构——查询理解、多源检索、来源排序、答案合成、追问探索——构成了一条精密的 RAG 管线,将传统搜索引擎的信息检索能力与 LLM 的语言理解和生成能力无缝融合。
对于开发者而言,这是一个充满机会的领域。借助 Tavily、LangChain 等工具,你可以在短时间内构建一个功能完备的 AI 搜索原型。而垂直领域 AI 搜索——在法律、医疗、代码、学术等专业场景——可能是更大的商业机会,因为这些场景对答案的准确性和引用的精确性有更高要求,通用 AI 搜索难以覆盖。
无论你是想理解 Perplexity 背后的技术,还是想构建自己的 AI 搜索系统,掌握本文介绍的五步管线架构都是关键的第一步。