多模态 RAG 实战:如何对图片、PDF 和文本进行统一检索
📻
多模态 RAG (Multimodal RAG) 允许 AI 同时跨文本、图像、图表和复杂的 PDF 进行检索与推理。通过利用联合嵌入空间(如 CLIP)或视觉优先的文档检索架构(如 ColPali),并结合 GPT-4o 或 Claude 3.5 Sonnet 等视觉语言模型 (VLM),你可以构建不丢失任何关键视觉上下文的企业级搜索引擎。
核心要点
•
视觉上下文至关重要:标准 RAG 会在解析时丢失表格、图表和空间排版关系,而多模态 RAG 能将其完整保留。
•
统一嵌入空间:像 CLIP 这样的模型能将文本查询和图像数据映射到完全相同的多维向量空间中。
•
视觉优先的数据接入:诸如 ColPali 的新架构将文档页面直接视为图像,绕过了容易出错的 OCR(光学字符识别)步骤。
•
VLM 生成:检索到的多模态上下文必须输入到能够同时理解多种模态的视觉语言模型中。
什么是多模态 RAG?
多模态 RAG 是一种 AI 架构,它将传统的纯文本检索扩展到了多种数据类型(最常见的是文本和图像的结合)。
在标准的 RAG 管道中,文档通常会被解析、剥离所有格式,并被切分为纯文本块 (Chunks)。这个过程会不可逆地破坏包含在图表、信息图、复杂表格排版中的关键视觉信息。
多模态 RAG 通过确保视觉数据与文本一起被索引、检索并发送给大模型(特别是视觉语言模型,VLM),解决了这一痛点。它让 AI 能够回答类似 "图 3 中的趋势线反映了 Q4 营收的什么情况?" 这样的复杂问题。
多模态 RAG 是如何工作的?
要处理多种模态,系统需要弥合文本与视觉数据之间的语义鸿沟。业界通常采用两种主流的架构方案:
架构 1:统一嵌入空间 (CLIP/SigLIP)
在这种方案中,单一的嵌入模型会将图像和文本编码到完全相同的多维向量空间中。
数据接入:图像通过图像编码器,文本通过文本编码器,两者输出维度兼容的向量。
检索:用户输入文本查询。文本被向量化后,标准的向量数据库(如 Milvus 或 Pinecone)执行最近邻 (KNN) 搜索,返回最相关的图像或文本块。
生成:检索到的图像和文本上下文被发送到 VLM(如 GPT-4o),以生成最终答案。
架构 2:图生文总结 (Image Captioning)
如果你的向量数据库或嵌入模型不支持多模态向量:
数据接入:使用 VLM 为每张图片/图表生成极其详细的文本描述(Caption)。
嵌入:使用标准的文本嵌入模型对生成的文本描述进行向量化。
检索:用户的查询匹配到文本描述,该描述的元数据中包含指向原始原始图片的链接 (URI)。
生成:原始图片及其文本上下文被一同发送到 VLM 进行最终推理。
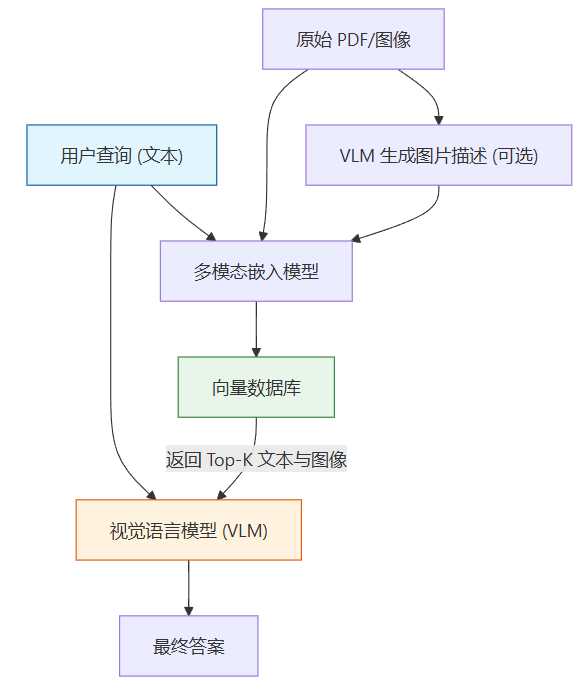
多模态 RAG 实战指南
下面我们将使用 Python、chromadb 向量数据库以及 OpenAI 的 API,演示如何基于 OpenCLIP 实现统一的多模态检索。
代码示例:Python 多模态统一检索
代码块
Python
import chromadb
from chromadb.utils.embedding_functions import OpenCLIPEmbeddingFunction
from openai import OpenAI
import base64
# 1. 初始化多模态向量数据库
client = chromadb.Client()
# 使用 OpenCLIP 将图像和文本映射到同一向量空间
embedding_function = OpenCLIPEmbeddingFunction()
collection = client.create_collection(
name="multimodal_docs",
embedding_function=embedding_function
)
# 2. 写入数据(同时包含文本和本地图片路径)
collection.add(
ids=["doc1", "img1"],
documents=["Q3 的企业级销售推动了 15% 的营收增长。", None],
uris=[None, "/path/to/q3_revenue_chart.png"], # URI 指向本地图片
metadatas=[{"type": "text"}, {"type": "image"}]
)
# 3. 使用纯文本查询检索图片
results = collection.query(
query_texts=["给我看 Q3 的营收增长图表"],
n_results=1
)
image_path = results['uris'][0][0]
print("检索到的文档路径:", image_path)
# 预期输出: 检索到的文档路径: /path/to/q3_revenue_chart.png# 4. 使用 VLM (GPT-4o) 生成最终回答with open(image_path, "rb") as image_file:
base64_image = base64.b64encode(image_file.read()).decode('utf-8')
oai_client = OpenAI()
response = oai_client.chat.completions.create(
model="gpt-4o",
messages=[
{
"role": "user",
"content": [
{"type": "text", "text": "分析这张图表,总结其增长趋势。"},
{"type": "image_url", "image_url": {"url": f"data:image/png;base64,{base64_image}"}}
],
}
]
)
print("VLM 回答:", response.choices[0].message.content)
🔧 立即体验:在构建 RAG 管道时,常常需要处理海量 JSON 数据。使用免费的 JSON 格式化工具 在线美化和验证你的 API 响应。
高级技巧:ColPali 视觉文档检索
传统的 PDF 解析依赖于 OCR(光学字符识别)或诸如 pdf2image、Unstructured 等版面解析工具。这些流程不仅缓慢、脆弱,还经常会把复杂的多栏排版搅乱。
ColPali(Vision-Language Model for Document Retrieval)代表了一种范式转移:视觉后期交互检索 (Late Interaction Vision Retrieval)。
ColPali 不再提取文本,而是将整个 PDF 页面视为一张完整的图片。它使用视觉 Transformer(如 PaliGemma)将视觉版面、文本和图表同时编码为多向量表示。当用户查询时,ColPali 执行"后期交互"(类似于 ColBERT),直接将查询的 Token 向量与文档图片的视觉补丁 (Patches) 进行逐一匹配。
为什么 ColPali 具有革命性:
零 OCR:完全绕过文本提取,消除了识别错误。
保留版面布局:基于视觉位置,天生理解表格结构、侧边栏和插图说明。
极速处理:将页面作为图像摄入往往比运行复杂的版面分析流水线更稳健、更快速。
最佳实践
将图像描述 (Captioning) 作为降级方案 — 如果你的数据库不支持多模态向量,务必在数据摄入时使用 VLM 为图片生成高密度的详细描述,然后对这段文本进行向量化。
保留图像分辨率 — 当图表被过度缩放时,GPT-4o 等 VLM 的识别能力会显著下降。确保你的管道将高分辨率图像传递给生成步骤。
保持文本上下文完整 — 从 PDF 中提取图像时,务必连同图像周围的 200 个词("图像上下文")一起提取,并将其与图像一起发送给 VLM。脱离了上下文的孤立图像往往充满歧义。
使用多模态基准进行评估 — 标准的 RAG 评估指标(如 RAGAS)偏向于文本。确保你在包含图表和表格的基准测试集上验证检索到的图像质量。
⚠️ 常见错误:
•
将 base64 图像直接存入向量数据库元数据中 → 正确做法:将图像存储在 S3 桶或本地存储中,仅在向量数据库的元数据中保存其 URL/URI。
•
忽略图像的宽高比 → 正确做法:确保你的嵌入模型和 VLM 能够优雅地处理非正方形图像,或者使用填充 (Padding) 而非拉伸。
常见问题 (FAQ)
Q1: 我可以直接用标准文本嵌入模型做多模态 RAG 吗?
不能直接使用。标准文本嵌入(如 text-embedding-3-small)无法处理图像字节流。你必须使用多模态嵌入模型(如 CLIP),或者先用 VLM 将图片转化为详细的文字描述,然后再对该描述进行文本向量化。
Q2: CLIP 和 ColPali 的主要区别是什么?
CLIP 为一张图像创建一个单一的全局向量,非常适合通用图像搜索(如"找一张狗的照片")。而 ColPali 会为文档页面的不同区块创建多个向量,这使它能够在包含密集文本和表格的复杂 PDF 页面上执行极高粒度的版面感知搜索。
Q3: 多模态 RAG 管道的成本更高吗?
是的。将高分辨率图像传递给 VLM 消耗的 Token 远高于纯文本。为了优化成本,请对纯文本查询使用标准文本检索,仅在查询明确需要视觉数据或图表时,才触发多模态检索和 VLM 生成。
总结
多模态 RAG 填合了基于文本的逻辑推理与视觉丰富的现实世界之间的鸿沟。通过利用 CLIP 这样的统一嵌入或 ColPali 等视觉优先架构,企业级 AI 系统终于能够以处理纯文本般的高保真度,去解析和推理复杂的 PDF、图表与数据大屏。