Memory三种记忆策略全解析
为什么需要 Memory 管理?
要实现"记忆",唯一的方法是把历史对话放进 messages 数据传给它。但问题来了:
•
上下文窗口有限:GPT-4o 是 128K tokens,图片、工具调用、系统 prompt 会吃掉大量空间
•
Token 费用是实打实的:每次都带上 100 轮历史,费用直接乘以历史长度
•
信息密度不均:第 1 轮说的"我叫小明"比第 98 轮的废话重要得多,但朴素截断会把它一起丢掉
三种记忆策略
LangChain.js 提供了三种主流 Memory 方案:
#hUCMHENpvFvJ text { white-space: pre; }#hUCMHENpvFvJ .fb0 { stroke: var(--N900-FG, 0.15); }#hUCMHENpvFvJ .fb0 {stroke: rgba(31,35,41, 0.15)}#hUCMHENpvFvJ .fx0 { stroke-miterlimit: 10; }#hUCMHENpvFvJ .fx0 {stroke-miterlimit: 10}#hUCMHENpvFvJ .fa1 { fill: rgb(187, 191, 196); }#hUCMHENpvFvJ .fa1 {fill: rgb(187, 191, 196)}#hUCMHENpvFvJ .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#hUCMHENpvFvJ .fx1 {font-style: normal}#hUCMHENpvFvJ .fx2 { text-anchor: middle; }#hUCMHENpvFvJ .fx2 {text-anchor: middle}#hUCMHENpvFvJ .fx3 { dominant-baseline: central; }#hUCMHENpvFvJ .fx3 {dominant-baseline: central}#hUCMHENpvFvJ .fx4 { stroke: none; }#hUCMHENpvFvJ .fx4 {stroke: none}#hUCMHENpvFvJ .fc0 { fill: var(--text-caption); }#hUCMHENpvFvJ .fc0 {fill: #646a73}#hUCMHENpvFvJ .fa2 { fill: var(--text-link-disabled); }#hUCMHENpvFvJ .fa2 {fill: rgb(187, 191, 196)}#hUCMHENpvFvJ .fa3 { fill: rgb(247, 247, 247); }#hUCMHENpvFvJ .fa3 {fill: rgb(247, 247, 247)}#hUCMHENpvFvJ .fx5 { font: 700 18px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#hUCMHENpvFvJ .fx5 {font-style: normal}#hUCMHENpvFvJ .fx6 { text-anchor: start; }#hUCMHENpvFvJ .fx6 {text-anchor: start}#hUCMHENpvFvJ .fx7 { dominant-baseline: alphabetic; }#hUCMHENpvFvJ .fx7 {dominant-baseline: alphabetic}#hUCMHENpvFvJ .fc1 { fill: rgb(72, 112, 172); }#hUCMHENpvFvJ .fc1 {fill: rgb(72, 112, 172)}#hUCMHENpvFvJ .fx8 { font: 700 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#hUCMHENpvFvJ .fx8 {font-style: normal}#hUCMHENpvFvJ .fx9 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#hUCMHENpvFvJ .fx9 {font-style: normal}#hUCMHENpvFvJ .fc2 { fill: rgb(0, 0, 0); }#hUCMHENpvFvJ .fc2 {fill: rgb(0, 0, 0)}#hUCMHENpvFvJ .fb1 { fill: var(--N900-FG, 0.15); }#hUCMHENpvFvJ .fb1 {fill: rgba(31,35,41, 0.15)}#hUCMHENpvFvJ .fb2 { fill: rgb(217, 223, 228); }#hUCMHENpvFvJ .fb2 {fill: rgb(217, 223, 228)}#hUCMHENpvFvJ .fa4 { fill: var(--bg-body); }#hUCMHENpvFvJ .fa4 {fill: #fff}ABC1234策略一句话定义类比窗口截断摘要总结向量检索只保留最近 N 轮对话将历史压缩成一段摘要历史存入向量库,按需检索相关片段鱼的记忆——只记得最近的事会议纪要——把几小时的会议浓缩成一页笔记本+搜索——记住所有,按需翻出来
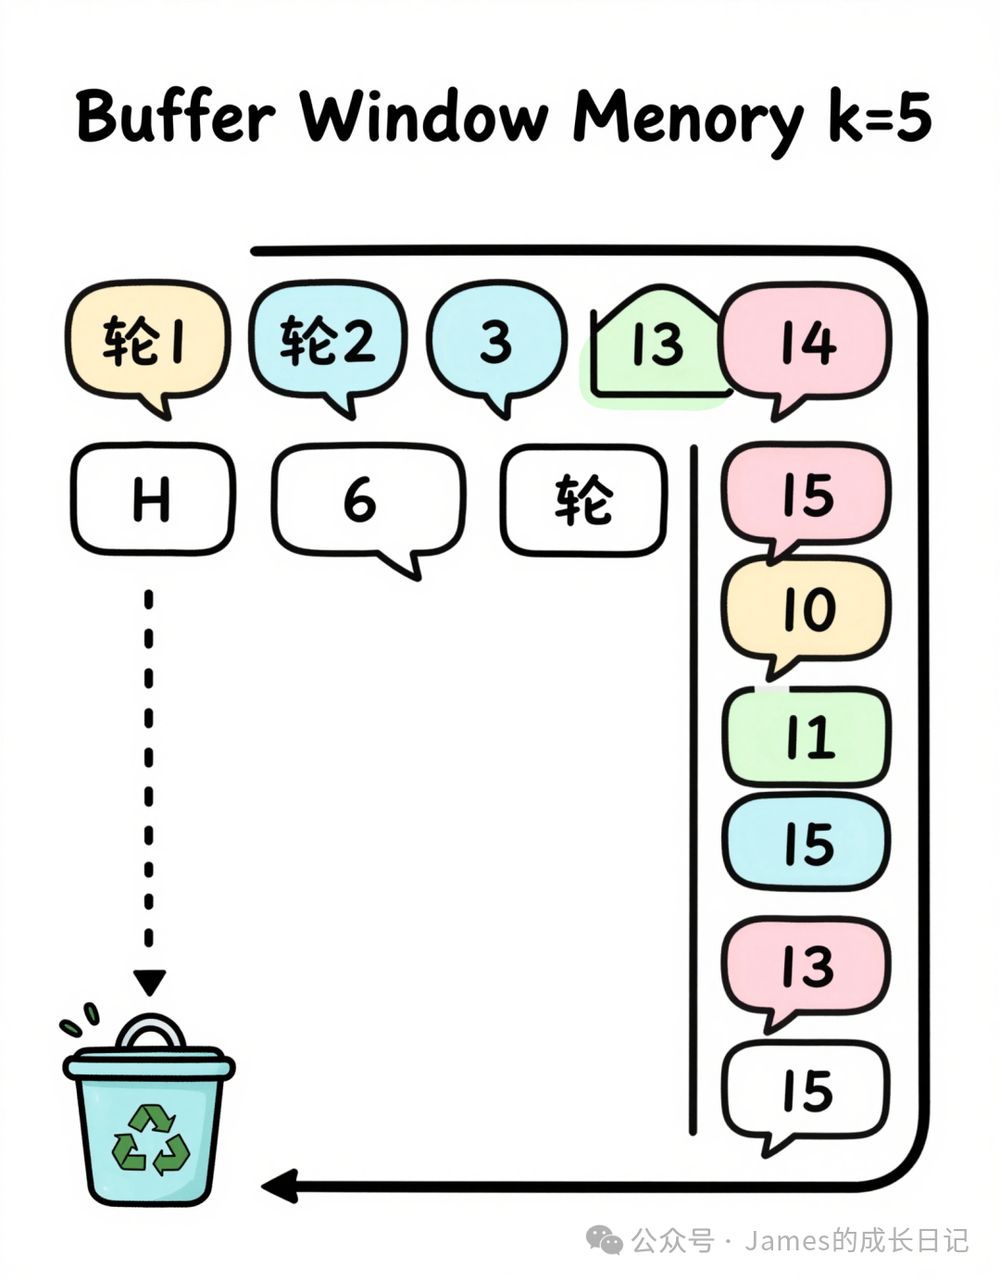
一、窗口截断(Buffer Window Memory)
只保留最近 K 轮对话,更早的直接丢弃。适合闲聊类、上下文不需要跨越太远的场景。
代码块
Plain Text
import { ChatOpenAI } from"@langchain/openai";
import { ConversationChain } from"langchain/chains";
import { BufferWindowMemory } from"langchain/memory";
import { ChatPromptTemplate, MessagesPlaceholder } from"@langchain/core/prompts";
const model = newChatOpenAI({ modelName: "gpt-4o-mini", temperature: 0.7 });
const memory = newBufferWindowMemory({
k: 5, // 保留最近 5 轮
returnMessages: true, // ChatModel 必须设为 true
memoryKey: "chat_history",
});
二、摘要总结(Summary Memory)
让 LLM 把旧对话压缩成摘要,新对话继续追加。历史信息不丢失,代价是额外的 LLM 调用。适合长对话、需要保留早期用户背景的场景。
代码块
Plain Text
import { ChatOpenAI } from"@langchain/openai";
import { ConversationSummaryBufferMemory } from"langchain/memory";
import { ConversationChain } from"langchain/chains";
import { ChatPromptTemplate, MessagesPlaceholder } from"@langchain/core/prompts";
const cheapModel = newChatOpenAI({ modelName: "gpt-4o-mini", temperature: 0 });
const smartModel = newChatOpenAI({ modelName: "gpt-4o" });
// 混合版:近期保留原文,历史压缩成摘要
三、向量检索(VectorStore Memory)
把每一轮对话存入向量数据库,每次对话用当前输入做语义检索,找出最相关的历史片段塞进上下文。适合超长对话和知识密集型问答。
代码块
Plain Text
import { ChatOpenAI, OpenAIEmbeddings } from"@langchain/openai";
import { VectorStoreRetrieverMemory } from"langchain/memory";
生产环境可以无缝替换为持久化向量库:
代码块
Plain Text
import { Milvus } from"@langchain/community/vectorstores/milvus";
const milvusStore = awaitMilvus.fromExistingCollection(
选型对比:什么场景用哪种?
选型决策树:
•
对话轮数 < 10 轮 → 窗口截断(最简单)
•
对话轮数 > 10 轮,且上下文连贯性重要 → 摘要总结(用混合版 SummaryBuffer)
•
对话轮数极长 / 需要精准回溯 → 向量检索
•
追求极致效果 → 摘要 + 向量检索组合
常见坑
坑1:returnMessages 忘了设 true
代码块
Plain Text
// ❌ 返回字符串,ChatModel 不认识
const memory = new BufferWindowMemory({ k: 5 });
// ✅ 返回 Message 对象,适配 ChatModel
const memory = new BufferWindowMemory({ k: 5, returnMessages: true });
坑2:memoryKey 和 Prompt 占位符不一致
代码块
Plain Text
// ❌ memory 用 "history",Prompt 用 "chat_history",直接报错
const memory = new ConversationSummaryMemory({ memoryKey: "history" });
坑3:摘要 Memory 的额外 LLM 调用计入费用
摘要每次对话后都会触发一次 LLM。高频场景下费用不可忽视。建议摘要专用小模型,并设合理的 maxTokenLimit 避免频繁压缩。
坑4:向量检索结果不够稳定
向量检索是语义相似度,不是精确匹配。用户说"你之前说的第 3 点"时,检索结果可能召回语义相近但并非第 3 点的内容。对"明确引用历史"的意图,可结合时间戳/序号做精确检索。
坑5:多用户场景 Memory 没做隔离
代码块
Plain Text
可收藏清单 ✅
选型:
•
对话 < 10 轮 → BufferWindowMemory
•
需要保留早期信息 → ConversationSummaryBufferMemory(混合版)
•
超长对话 / 知识问答 → VectorStoreRetrieverMemory
代码规范:
•
ChatModel 场景,returnMessages: true 必须设
•
memoryKey 与 Prompt 占位符严格对齐
•
摘要 Memory 的 LLM 单独指定便宜模型
•
多用户按 userId / sessionId 隔离 Memory 实例
性能与成本:
•
maxTokenLimit 设合理值控制摘要频率
•
向量检索的 k 值 3~5 条通常够用
•
生产向量库选持久化方案(Milvus、Pinecone)
调试技巧:
•
memory.loadMemoryVariables({}) 随时查看 Memory 内容
•
verbose: true 查看完整 LLM 调用链路
总结
这篇从头到尾拆解了 LangChain 三种 Memory 策略:
•
窗口截断:实现最简单,只保留最近 K 轮,适合轻量级闲聊场景
•
摘要总结:用 LLM 压缩历史,信息不丢失,混合版(SummaryBuffer)是长对话首选
•
向量检索:语义召回历史片段,适合超长对话和知识密集型问答,生产级方案
•
选型核心:轮数少用截断,轮数多用摘要,轮数极长且需精准回溯用向量检索
•
关键细节:returnMessages、memoryKey 对齐、多用户隔离,三个坑几乎人人踩过