Agent 的8种“记忆系统”
01 顺序记忆
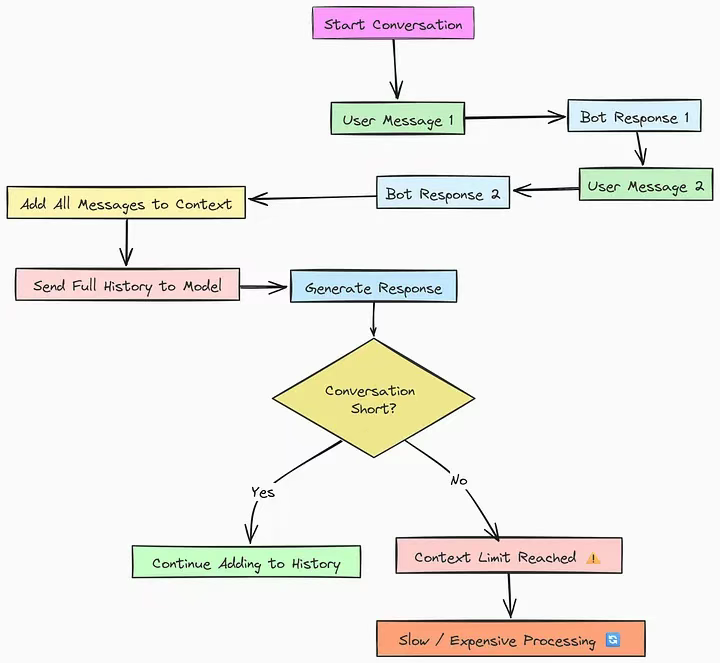
顺序记忆是最基础、最简单的,也是许多开发人员常用的方法。它是最早管理对话历史的方法之一,早期的聊天机器人经常使用这种方法。
📌
这种方法需要将每条新消息添加到运行日志中,并每次将整个对话反馈给模型。它会创建一个线性记忆链,保存迄今为止所说的所有内容。
50%
50%
顺序记忆的工作原理如下:
📌
用户开始与 AI 代理对话。
代理响应。
此用户与 AI 的交互(一个“轮次”)被保存为单个文本块。
对于下一轮,代理将获取整个历史记录(第 1 轮 + 第 2 轮 + 第 3 轮……)并将其与新的用户查询相结合。
这一大段文本被发送到 LLM 以生成下一个响应。
虽然顺序记忆的方法很容易实现,但它有一个主要缺点:代理的对话越长,tokens 成本就越高,所以这种方法相当昂贵。
02滑动窗口
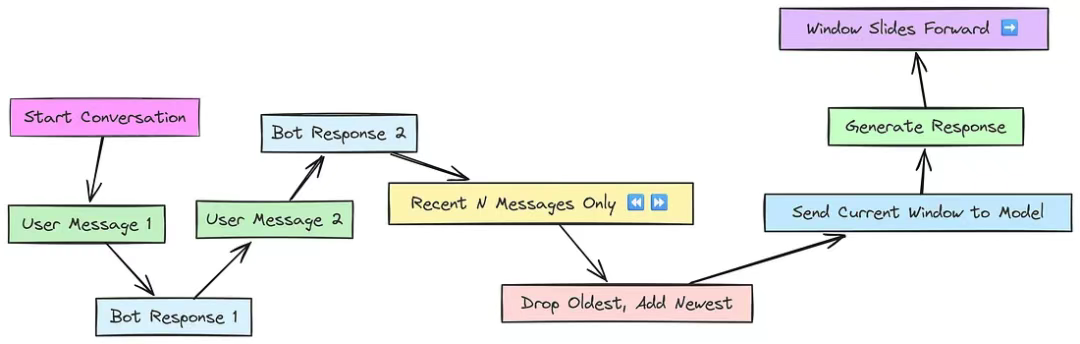
为了避免上下文过大的问题,滑动窗口应运而生。滑动窗口不需要记住所有以前的消息,而只需要记住一定数量的最近消息的上下文。
50%
50%
📌
代理不会保留整个对话历史记录,而是仅保留最近的 N 条消息作为上下文。随着新消息的到来,最旧的消息将被丢弃,窗口将向前滑动。
过程很简单:
📌
定义一个固定的窗口大小,比如 N=2轮。
前两轮填满窗口。
当第三轮发生时,第一轮被推出窗口以腾出空间。
发送到 LLM 的上下文只是当前窗口内的内容。
滑动窗口显著减少了 tokens 数量,但缺点也很明显:如果用户引用早期信息,则可能会丢失重要的上下文。
📌
滑动窗口是一个需要考虑的关键因素,应该根据正在构建的 AI 代理的特定类型进行定制。
03 基于摘要的优化
顺序记忆方法存在巨大的上下文问题,而滑动窗口方法则有可能丢失重要的上下文。
📌
因此,需要一种方法,通过压缩上下文而不丢失基本信息来解决这两个问题。这可以通过基于总结摘要来实现。
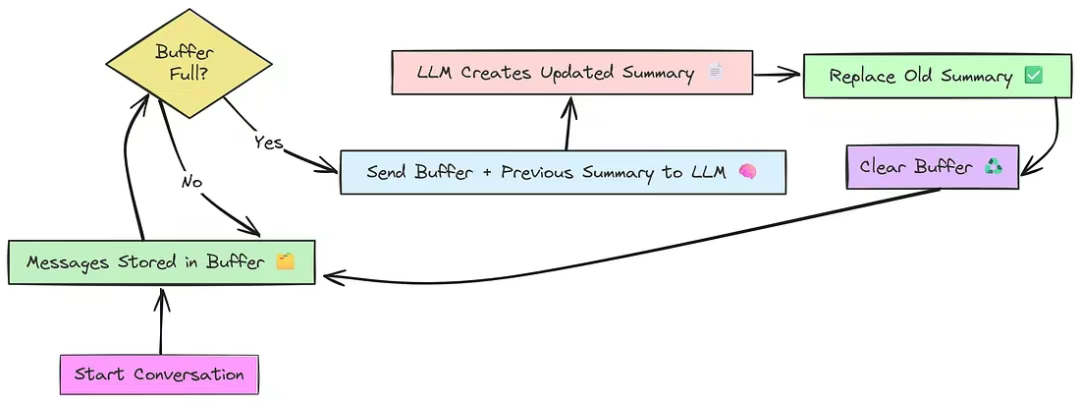
该策略不是简单地删除旧消息,而是定期使用 LLM 本身来创建对话的运行摘要。它的工作原理是这样的:
📌
最近的消息存储在称为“缓冲区”的临时存储区域中。
一旦此缓冲区达到一定大小("阈值"),代理暂停并触发特殊操作。
它将缓冲区的内容连同先前的摘要发送给LLM,并给出特定指令:“创建一个包含这些最近消息的新的、更新的摘要”。
LLM生成一个新的、合并的摘要。这个新摘要替换旧摘要,缓冲区被清除。
摘要总结方法的核心目标是在保留重要信息的同时节省 tokens 消耗。为了使该方式真正有效,摘要提示需要精心设计,以确保它们捕捉到最重要的细节。
📌
摘要总结方法的缺点是,随着对话轮次的持续增长,关键信息在摘要过程中仍然可能丢失,答案质量和准确性可能会显着下降,甚至降至零。
例如,如果用户的对话达到 40 回合,并包含数字或事实详细信息(例如资产负债表数据),则之前的关键信息(如第 4 轮对话中提到的总销售额)可能不再出现在摘要中。
这凸显了创建一个专门负责核查 LLM 回复事实的子代理的重要性。这样的子代理可以验证事实的准确性,并有助于使整个智能体更加可靠和强大。
04 压缩和整合记忆
摘要是一种管理长对话的好方法,但如果想再激进地压缩 token 用量,这时就轮到“压缩与整合记忆”登场了——它堪称摘要的“加强版”。
📌
该过程很简单:
📌
在每次对话轮次(用户输入 + AI 响应)后,代理会将此文本发送到 LLM。
它使用特定的提示,要求 LLM 像 “数据压缩引擎” 一样运行。
LLM 的任务是将回合重写为一个单一的基本陈述,去除所有对话中的废话,如问候、礼貌和填充词。
然后,这个高度压缩的事实被存储在一个简单的列表中。
代理的记忆变成了一个精简、高效的核心事实列表,它甚至可以比叙述性摘要的 tokens 使用更具效率。
📌
这种策略在减少 tokens 数量的同时保留核心事实方面非常有效。对于在紧张的 tokens 预算下需要长期事实回忆的应用程序来说,这是一个不错的选择。
然而,对于严重依赖细微差别和个性的对话来说,这种激进的压缩可能过于过分。
05 基于检索的内存
这是许多 AI 代理用例中使用的最强大的策略:基于 RAG 的 AI 代理。之前的方法减少了 token 的使用,但可能会丢失相关上下文。然而,RAG 则不同,它根据当前用户查询检索相关上下文。
📌
上下文存储在 数据库,嵌入模型通过将文本转换为矢量表示来提高检索效率,从而发挥着至关重要的作用。
基于 RAG 的内存的工作流程是这样的:
📌
每次发生新的交互时,它不仅存储在列表中,还作为“文档”保存在专门的数据库中。我们还生成此文档含义的数字表示形式,称为嵌入向量,并将其存储。
当用户发送新消息时,代理首先将此新消息也转换为嵌入向量。
然后,它使用此查询嵌入向量对存储在其内存数据库中的所有文档嵌入向量执行相似性搜索。
系统检索语义最相关的前 k 个文档(例如,过去最相似的 3 个对话回合)。
最后,只有这些高度相关的检索到的文档才会被注入 LLM 的上下文窗口中。
嵌入模型和向量存储数据库的选择在这里起着至关重要的作用。优化该数据库是确保快速准确检索的另一个重要步骤。
然而,缺点是这种方法的实施比看起来更复杂。随着数据库的变大,AI 代理的复杂性显着增加。可能需要并行查询处理和其他优化技术来保持性能。尽管存在这些挑战,这种方法仍然是优化人工智能代理的行业标准。
06 内存增强 Transformers
除了这些核心战略之外,人工智能系统还在实施更复杂的方法,突破可能的界限。
可以通过一个例子来理解这种技术。
📌
想象一个普通的人工智能,就像一个只有一个小记事本的学生。
他们一次只能写一点点。因此,在漫长的测试中,必须擦除旧笔记,为新笔记腾出空间。
现在,记忆增强的 Transformers 就像给那个学生一堆便签。记事本仍然处理当前的工作,但便签可以帮助他们保存之前的关键信息。
它的运行过程是这样的:
📌
对最近的聊天使用滑动窗口记忆。
每次对话后,使用 LLM 充当 “事实提取器”。 它将分析对话并决定它是否包含核心事实、偏好或决定。
如果找到重要事实,则将其作为“记忆标记”存储在单独的列表中。
提供给代理的最终上下文是最近的聊天窗口和所有持久记忆标记的组合。
这种方法可以以更好的方式在更大的数据集上进行深入评估,因为这里使用的 Transformer 模型需要许多保密解决方案。这种方法可能是更好的选择。
由于需要额外的 LLM 来提取事实,这是一种更复杂、更昂贵的策略,但它能够在长时间、不断变化的对话中保留关键信息,这使得它在构建真正可靠和智能的个人助理方面非常强大。
07 多任务的分层优化
到目前为止,我们将内存视为一个单一系统。但是,如果我们能够构建一个更像人类思考的智能体,为不同的目的提供不同类型的记忆呢?
📌
这就是分层记忆背后的理念。这是一种复合策略,将多种更简单的记忆类型组合成一个分层系统,为我们的智能体创造一个更复杂、更有条理的思维。
想想人类是如何记住事情的:
📌
•
工作记忆:有人对你说的最后几句话。它很快,但转瞬即逝。
分层方法的工作原理是这样的:
📌
首先将用户消息捕获到工作记忆中。
然后检查信息是否足够重要,可以提升到长期记忆。
之后,提升的内容将存储在检索内存中以备将来使用。
对于新查询,它会在长期记忆中搜索相关上下文。
最后,它将相关记忆注入上下文中以产生更好的响应。
基于该方法的代理会组合不同的记忆类型,它利用快速的工作记忆保持对话流畅,同时在需要时准确查询深层长期记忆,从而在被询问时取回关键的用户 ID。这种混合方法是构建复杂代理的强大模式。
08 基于知识图谱的优化
到目前为止,我们的记忆已将信息存储为文本块,无论是完整的对话、摘要还是检索到的文档。但是,如果我们可以教我们的代理理解不同信息之间的关系呢?这是我们在基于图形的记忆方面取得的飞跃。
该策略超越了存储非结构化文本,而是将信息表示为知识图谱。
知识图谱包括:
📌
•
节点(实体):指对话中的“事物”,例如人物(Clara)、公司(FutureScape)或概念(Project Odyssey)。
•
边(关系):描述节点之间如何关联的连接,例如 works_for(就职于)、is_based_in(位于)或 manages(负责)。
最终得到的是一种结构化的、网状的记忆形式。智能体不再简单地记录“Clara 就职于 FutureScape”这条事实,而是把这一关联存成一条连接:(Clara) --[works_for]--> (FutureScape)。
这对于回答需要推理连接的复杂查询非常强大,主要挑战是从非结构化对话中填充图表。
为此,我们可以使用一种强大的技术: 使用 LLM 本身作为工具从文本中提取结构化 (主语、关系、宾语) 三元组。回答问题时,查找查询中的实体,返回其所有已知关系。
📌
比如,用户先后说“Clara 在 FutureScape 工作”“FutureScape 位于柏林”“Clara 负责项目 Odyssey”。当问“Clara 的项目是什么?”时,系统能推理出“Odyssey”并给出完整关系链。
这种方式为建立知识渊博的专家代理打开了大门。
09 类似操作系统的记忆管理
如果我们可以为我们的代理构建一个像计算机中的内存一样工作的记忆系统会怎样?这个高级概念直接借鉴了计算机的作系统 (OS) 管理 RAM 和硬盘的方式。
📌
•
RAM(随机存取存储器): 这是计算机用于活动程序的超快内存。它很贵,而且你没有很多。对于代理来说,LLM 的上下文窗口是它的 RAM——它访问速度很快,但大小非常有限。
此记忆策略的工作原理是在这两个层之间智能地移动信息:
📌
活跃内存 (RAM): 最近的对话轮次保存在这里,保存在一个小型快速访问缓冲区中。
被动内存(磁盘):当活跃内存已满时,最旧的信息被移出,存入长期的被动存储区,这个过程称为“换出”。
缺页中断:当用户提出的问题需要的信息不在活跃内存时,就会发生“缺页中断”。
这是一个概念上强大的模型,它让系统能够拥有几乎无限的记忆容量,同时仍保持活跃上下文的小巧与高速。
如何选择最佳的方法?
这九种不同的记忆优化策略,从简单到高度复杂。没有单一的“最佳”策略,正确的选择是在代理的需求、预算和工程资源之间取得平衡。
📌
•
简单、短命的机器人:顺序存储或滑动窗口最合适,实现简单,足以完成任务。
•
长期、创意性的对话:摘要式是理想选择,可在不暴增 token 的前提下保持整体连贯。
•
需要精确、长期记忆的代理:基于检索的记忆已成行业标准,它强大、可扩展,是大多数 RAG 应用的基石。
•
高可靠性的个人助理:记忆增强或分层记忆能稳妥地把关键事实从闲聊中剥离出来。
•
专家系统与知识库:知识图谱记忆在数据点之间的关联推理上无可匹敌。
生产环境中最强大的代理往往采用混合方案,将多种技术结合。可以构建一套分层系统,让长期记忆同时包含向量数据库与知识图谱。
关键在于先弄清楚:代理需要记住什么、记住多久、精度要求多高。掌握这些记忆策略后,就能超越简单的聊天机器人,开始打造真正会学习、会记忆、并随着时间不断进化的智能体。