Agent Memory 到底怎么做?从方案到落地完整拆解
Agent Memory 不是"把历史对话塞进向量库",它是一套上下文管理机制:什么信息值得留下、怎么组织、什么时候取出来、取出来后怎么影响 Agent 的推理和行动。
💡
简单记忆:文件记忆 + 显式规则 + 结构化 item + 混合检索 + 定期压缩
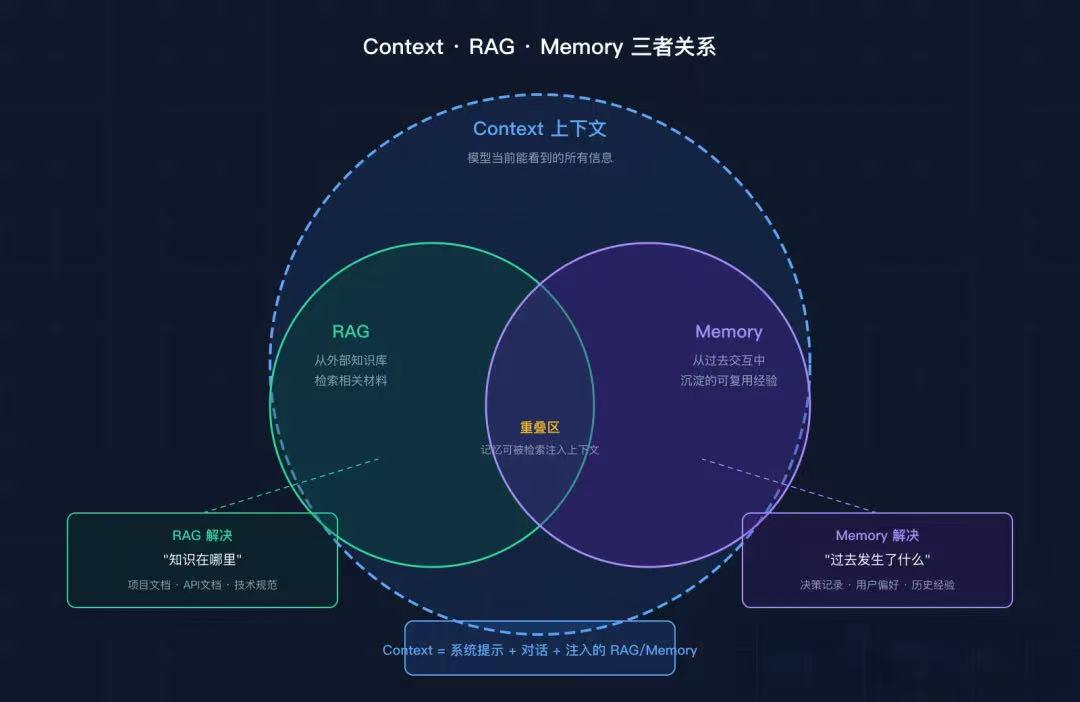
Memory 不是 RAG
上下文是模型当前能看到的信息。
RAG 是从外部知识库里找相关材料。
Memory 是 Agent 从过去交互、任务和用户反馈中沉淀出来的可复用经验。
😀
Agent Memory 其实就是对 context 的精细管理。记忆不是孤立的东西,它要跟具体业务问题走。很多方法做着做着就扩展成 RAG 平台或 Agent 框架的一部分,已经偏离了 Memory 本身。
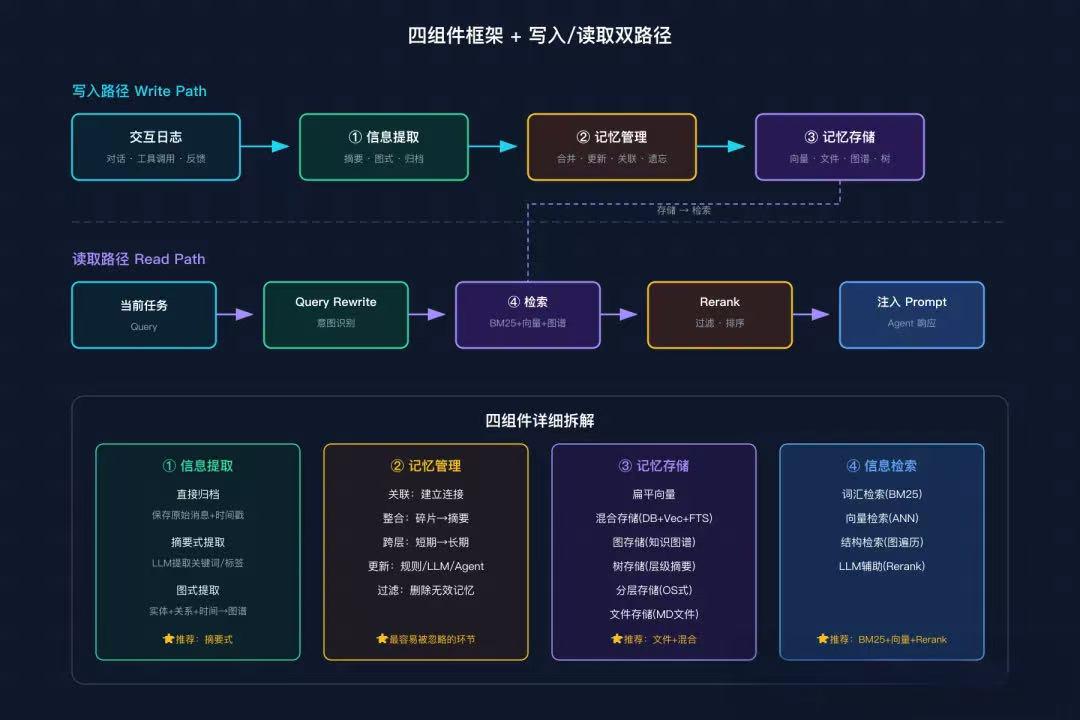
四组件框架:所有方案都逃不开这四件事
信息提取:从交互中判断什么值得记
记忆管理:对已有记忆做合并、更新、关联、遗忘
记忆存储:决定用什么结构保存
信息检索:在需要时把相关记忆找回来
写入路径和读取路径是两条不同的流:
写入:交互日志 → 提取 → 更新/合并/遗忘 → 存储
读取:当前任务 → 查询重写/意图检测 → 检索 → 重排/过滤 → 注入上下文 → Agent 响应
很多系统的问题出在哪呢?只做了存储和检索,没有认真做提取和管理。结果记忆越积越多,越来越像一个塞满垃圾的向量库。我自己第一版就犯了这个错。
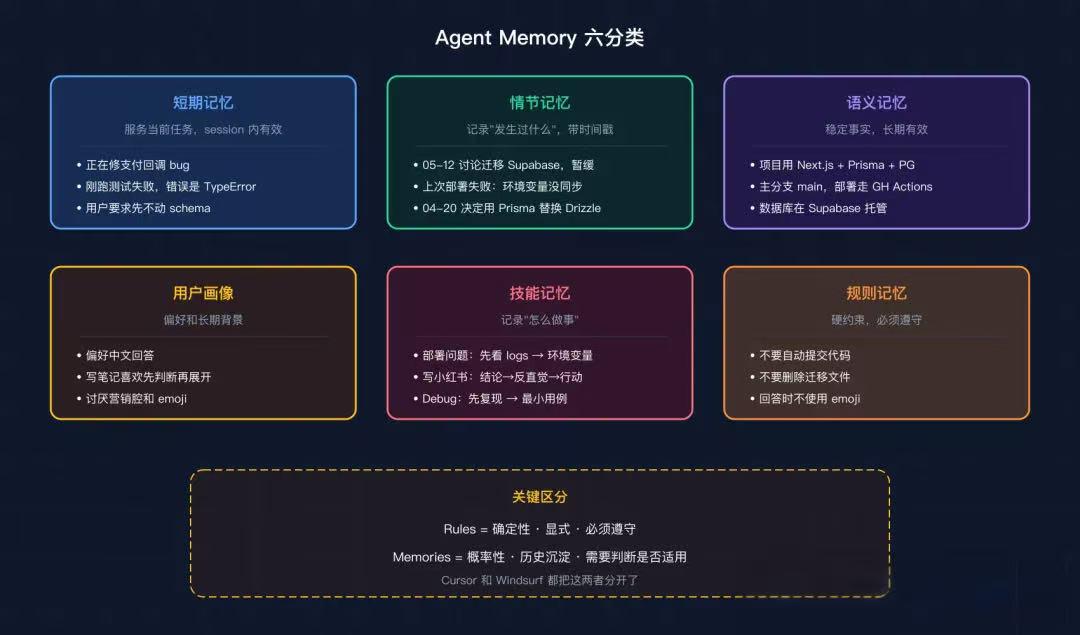
记忆应该分六类
不要把所有历史都叫 Memory。实际工程里,至少得分清楚六种东西。
短期记忆服务当前任务。"现在正在修支付回调 bug。""刚跑测试失败,错误是 TypeError。"只在当前 session 内有效。
情节记忆记录发生过什么。"2026-05-12 讨论过迁移 Supabase,因为 RLS 复杂度暂缓。""上次部署失败是因为环境变量没同步到 preview environment。"带时间、事件和决策。
语义记忆记录稳定事实。"项目用 Next.js + Prisma + PostgreSQL。""主分支叫 main,部署走 GitHub Actions。"
用户画像记录偏好。"用户偏好中文回答。""写笔记喜欢先给判断再展开。"ChatGPT 把 Memory 分成 saved memories 和 chat history 两种,用户可在设置中管理。
技能记忆记录怎么做事。"处理 Vercel 部署问题时,先看 build logs,再看环境变量,再看 Node 版本。"
规则记忆比偏好更硬。"不要自动提交代码。""不要删除迁移文件。"AGENTS.md、CLAUDE.md、.cursor/rules 都属于这类。
😀
Rules 是确定性的、必须遵守。Memories 是概率性的、需要判断是否适用。
信息提取:三种路线
信息提取是 Memory 系统的入口。问题很直接:从原始对话、工具结果、用户行为里,哪些东西值得进入记忆系统?
直接归档最简单,保存原始消息加时间戳。优点是信息完整,缺点是噪声大、存储膨胀、检索成本高。MemoryBank 和 MemGPT 偏这一类。
摘要式提取用 LLM 从一轮或多轮对话中提取摘要、关键词、标签。A-MEM 会为新记忆生成包含上下文描述、关键词和标签的综合笔记,并通过动态链接构建知识网络。Mem0 也是从持续对话中动态提取显著信息。摘要式提取适合大多数工程场景,在完整性和成本之间比较平衡。
图式提取用 LLM 抽取实体、关系、时间,构建知识图谱。Zep/Graphiti 就是典型代表,动态综合非结构化对话和结构化业务数据,同时保留历史关系。适合企业关系数据、CRM、多跳推理。但图式提取有天然问题:三元组化会损失语义。一句话里的语气、犹豫、上下文暗示,很难变成"主语-谓语-宾语"。
记忆管理:五类操作
信息进入系统后,不应该只是被保存。管理操作可以拆成五类:
关联:在相关记忆之间建立连接。"用户喜欢简洁回答""用户写技术笔记""用户讨厌营销腔",这三条单独看是散的,一起看能更好指导写作风格。A-MEM 通过动态链接建立记忆网络,Zep 通过实体图谱建立关联。
整合:把碎片化记忆合并成更稳定的摘要。多次对话里用户都说"不喜欢太油腻的表达",系统可以整合成一条:"用户偏好自然、克制、判断明确的中文表达。"这类记忆比多条散落原文更好用。
跨层转换:把短期记忆迁移成长期记忆。MemoryOS 采用短/中/长三层架构,短期到中期按 FIFO 迁移,中期到长期结合访问频率和最近性评分。关键是:不是所有东西都应该一步进入长期记忆。
更新有三种范式:
#mRuOUuQimBWU text{white-space:pre}.fb0{stroke:var(--N900-FG, 0.15)}.fx0{stroke-miterlimit:10}.fa1{fill:#bbbfc4}.fx1{font:normal 400 12px MonospacedNumber,LarkHackSafariFont,LarkEmojiFont,LarkChineseQuote,-apple-system,BlinkMacSystemFont,Helvetica Neue,Tahoma,PingFang SC,Microsoft Yahei,Arial,Hiragino Sans GB,sans-serif,Apple Color Emoji,Segoe UI Emoji,Segoe UI Symbol,Noto Color Emoji}.fx2{text-anchor:middle}.fx3{dominant-baseline:central}.fx4{stroke:none}.fc0{fill:var(--text-caption)}.fa2{fill:var(--text-link-disabled)}.fa3{fill:#e1eaff}.fx5{font:700 normal 18px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"}.fx6{text-anchor:start}.fx7{dominant-baseline:alphabetic}.fc1{fill:rgb(63, 63, 63)}.fx8{font:400 normal 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"}.fb1{fill:var(--N900-FG, 0.15)}.fb2{fill:rgb(223, 223, 223)}.fa4{fill:var(--bg-body)}ABCD1234更新方式做法优点缺点规则驱动LLM 驱动Agent 驱动按时间衰减、访问频率更新用模型判断合并、改写、冲突Agent 自己调用工具决定写/改/删可控、便宜灵活自主性强僵硬成本高、不稳定最难调试
过滤就是删除或降权无效记忆:过期信息、重复信息、低价值信息、错误信息、当前 scope 不适用的信息。如果没有过滤机制,Memory 系统会越用越脏。
记忆存储:五种结构
扁平向量存储最常见。把 memory item 做 embedding,放进 FAISS / Qdrant / Milvus / pgvector,按语义相似度检索。简单成熟,但关系推理弱、时间推理弱、精确匹配弱。
混合存储在生产里更常见。数据库存正文和元数据(事实源),向量索引做语义召回,全文索引做 BM25/FTS,图索引做实体关系。不要让向量库成为唯一事实源,否则更新、删除、审计会很麻烦。
图存储适合实体关系和时间变化。Zep/Graphiti 就是典型,因为企业知识经常动态变化:客户状态、交易进展、组织关系、历史决策。传统 RAG 适合静态文档,企业 Agent 需要持续整合对话和业务数据。
树存储是 MemTree 的思路。叶子节点保存细节,上层节点保存抽象摘要。既保留原始信息,又能在高层做概念召回。但维护成本高,对话越长,插入时需要更新路径上的摘要。
分层存储是 MemGPT、MemoryOS、MemOS 的方向。Active Context → Short-term → Mid-term → Long-term → Archive。来自操作系统的思路:上下文窗口像内存(贵、小),外部存储像磁盘(大、便宜),需要调度。
文件存储是工业界最常用的。MEMORY.md、USER.md、rules 文件。简单、可读、可版本控制。
信息检索:混合检索 + 排序公式
检索阶段四种范式:
表格加载中...
😀
生产系统里通常是混合流程:
当前任务 → 意图识别/Query Rewrite → BM25 召回 + 向量召回 + 图谱扩展 → 候选合并 → Rerank → 过滤过期/冲突/低置信 → 注入 Prompt
模拟排序公式:
这个公式不是固定的。 Coding Agent 要提高 lexical_match 权重(函数名、错误码很重要)。个人助理提高 recency 权重。企业系统提高 graph relevance 和 temporal validity 权重。
10 种学术方案组件矩阵
这张表的核心信息:多数方案不是在"有没有 Memory"上差异,而是在记忆的组织方式和更新机制上差异。
工业界怎么做?五个实践
ChatGPT:产品化个人记忆
ChatGPT Memory 重点不是做开发者可编程的记忆数据库,而是产品级个性化。
官方文档里,Memory 有两个设置:Reference saved memories(用户明确让 ChatGPT 记住的信息)和 Reference chat history(参考过去聊天改善未来回答)。它走的路线偏"把相关 memory 拼进 context,让模型自己消化",不是复杂 RAG 检索。
😀
重点是:用户可控、个性化、跨会话体验、偏好和稳定事实、可以关闭/管理/删除。
Claude Memory Tool:把存储交给开发者
Claude API 的 Memory Tool 官方文档说,Claude 可以通过 /memories 目录在会话之间存储和取回信息。启用后,Claude 会在开始任务前检查记忆目录,可以创建、读取、更新、删除该目录下的文件。
这个工具是 client-side 的:Claude 发起工具调用,应用程序在本地执行,开发者控制记忆存在哪里、怎么存。
😀
核心价值是 just-in-time context retrieval:不预先加载所有信息,而是把学到的东西存在 memory 里,需要时再取回来。对长期运行 Agent 很重要:跨 session 项目上下文、从历史决策中学习、构建长期知识库、重复工作流的持续改进。
Letta(MemGPT 延续):分层记忆 + Sleep-time Compute
MemGPT 的核心来自操作系统:有限上下文窗口相当于 RAM,外部存储相当于 disk,Agent 需要学会把信息换入换出。Letta 进一步提出 memory blocks,把上下文窗口拆成有标签的区块(persona、human、task state),可被 API 读取、更新、删除,可在多个 Agent 之间共享。
另一个重要概念是 Sleep-time Compute。官方博客解释:sleep-time compute 是让 Agent 在空闲时间处理信息、形成新连接、重写 memory state,而不是只在对话时处理。
😀
在线对话时 Agent 要快;记忆整理时 Agent 要认真。这两个目标冲突,Sleep-time 把它们解耦了。适合个人助理、长期项目 Agent、代码库反思、多 Agent 共享知识、需要持续改进的工作流。
Hermes:文件记忆 + 插件记忆
Hermes 的设计很克制。内置 persistent memory 核心是 MEMORY.md 和 USER.md。如果需要更深的持久记忆,可以启用外部 memory provider 插件(Honcho、Mem0、Hindsight 等)。外部 provider 是 additive,不替代内置 memory。
😀
这是一个二层架构:
第一层内置文件记忆(简单、稳定、可读);
第二层外部 provider(语义搜索、知识图谱、自动事实提取)。
几个现实的设计决策:
•
MEMORY.md 和 USER.md 有容量边界,满了后 Agent 会整合条目
•
session 中写入磁盘的 memory 不会立刻出现在系统提示词里,要等下次 session 启动才快照进去
•
prompt cache 很重要,不能每轮都打破缓存
•
外部 provider 是增强,不是基础依赖
Cursor/Windsurf:Rules + Memories 分层
Coding Agent 的 Memory 和通用聊天 Agent 不一样。它面对的是代码库、文件、终端、错误、项目规范。很多"记忆"其实是规则和约定。
•
Cursor 把 Rules 定位为 persistent instructions,包括 Project、Team、User Rules 和 AGENTS.md。
•
Windsurf 的 Cascade 则明确有 Memories 和 Rules 两套机制:Memories 用于跨对话共享和持久化上下文,可由 Cascade 自动生成;Rules 是用户手动定义的全局、工作区或系统级规则。
😀
在 Coding Agent 里,rules 通常比 memories 更重要。 项目规范、代码风格、禁止操作、测试命令,最好显式写下来,不要让 Agent 从对话中"猜"。
写入协议:什么时候该记?
只有在以下情况写入长期记忆:
用户明确要求记住
信息会在未来多次影响任务表现
信息是稳定偏好、项目事实、长期限制、重要决策或可复用流程
信息有明确来源,不是临时情绪、一次性草稿或不确定猜测
写入前必须判断:
•
是否已经存在相似记忆?
•
是否和旧记忆冲突?
•
是否只属于当前项目(scope)?
•
是否应该设置过期时间?
•
是否需要用户确认?
•
是否涉及敏感信息?
不要写入:
•
API key、密码、token 等敏感信息
•
一次性任务细节、未确认的猜测、大段原文
•
很快变化的信息(除非带上时间戳和有效期)
检索协议:什么时候该查记忆?
在以下情况先检索记忆:
用户提到"之前""上次""我们当时""继续"
当前任务涉及长期项目、个人偏好、历史决策
需要恢复未完成任务
需要避免重复踩坑
当前问题和某个已知项目、客户、代码库相关
回答会受到用户偏好或项目规则影响
检索后:
•
只注入最相关的 3-8 条、优先使用同一 scope 的记忆
•
新记忆优先于旧记忆、高置信记忆优先于低置信记忆
•
如果存在冲突,明确标出冲突,不要擅自合并
不同场景怎么选型?
个人助理
推荐:Saved memory + User profile + 少量可检索历史 + 用户可见可删。不推荐一上来做图谱。重点是边界和控制权。
Coding Agent
推荐:Rules + Memory 分层、AGENTS.md / CLAUDE.md / .cursor/rules、代码库索引、会话日志检索、技能记忆、错误和决策记录。不推荐把所有代码历史都当成 memory。重点是项目规则、代码事实、可复用流程。
Research Agent
推荐:RAG + citation store、Research log、Hypothesis memory、Decision memory、Source credibility metadata、长期主题摘要。可以考虑图谱,但要保留原始来源。重点是证据链,不是用户画像。
企业 Agent
推荐:Temporal knowledge graph、CRM/ticket/document integration、Entity resolution、Access control、Audit log、Memory expiration。Zep/Graphiti 这类时间知识图谱适合企业动态知识,处理结构化业务数据和非结构化对话,保留历史关系。重点是权限、时间、实体关系和审计。
长期陪伴/角色 Agent
推荐:短/中/长期分层、情节记忆、用户偏好、主题摘要、遗忘曲线、情绪和关系事件时间线。但要非常注意心理安全和隐私边界。
七个常见坑
坑一:把 Memory 做成无限上下文。 更多历史不等于更好。过多无关信息会让模型被噪声干扰,推理质量反而下降。我试过把最近 50 轮对话全塞进去,效果反而变差。
坑二:只用向量库。 向量检索对语义相似有效,但对精确匹配不稳定。代码里的函数名、错误码、文件路径、版本号,都需要 BM25/FTS 精确匹配。我现在是混合检索,向量负责语义,BM25 负责精确。
坑三:没有 scope。 全局偏好、项目事实、临时状态混在一起,会造成记忆污染。用户在 A 项目里说"不用 Tailwind",不代表所有项目都不用 Tailwind。记忆必须带 scope。
坑四:没有过期机制。 旧记忆如果不降权,会污染新任务。应该引入 expires_at、last_accessed_at、valid_from/valid_to、status(active/superseded/archived)。
坑五:自动提取太激进。 LLM 很容易把一次性表达提炼成长期偏好。用户说"这次写短一点",不代表以后永远要短。
坑六:图谱过早上场。 图谱适合关系推理,但也会带来实体消歧、关系抽取、时间维护、冲突合并等一堆问题。没有明确图推理需求,就先别上。
坑七:不可见不可删。 用户不知道 Agent 记了什么,就很难信任它。产品级 Memory 必须可查看、可编辑、可删除、可关闭。
我的实战选型:三层架构
研究完这些方案,我给自己的 Agent 选了三层:
Layer 1:显式规则(优先级最高)
稳定、短小、明确。
比如:默认用中文回答、不要营销腔、先给判断再展开原因、代码修改前先说明风险。这些是硬约束,不需要 Agent 去"回忆",直接写在 rules 里。
Layer 2:稳定文件记忆
类似 Claude Memory Tool 和 Hermes 的做法,用 markdown 文件保存稳定事实:
代码块
Plain Text
/memories
USER.md
PROJECT.md
MEMORY.md
DECISIONS.md
SKILLS.md
好处:可读、可改、可审计、可版本控制。出了问题打开文件就能看到 Agent 到底"记住"了什么。
Layer 3:可检索历史记忆
把对话和决策变成结构化
代码块
Plain Text
{
"id": "mem_123",
"type": "preference | fact | decision | task_state | skill | warning",
"scope": "global | project | session",
"content": "用户偏好技术笔记先给判断,再展开原因。",
"source": {
"conversation_id": "conv_456",
"timestamp": "2026-05-15T15:30:00+09:00"
},
"importance": 0.82,
"confidence": 0.91,
"expires_at": null,
"status": "active",
检索时结合 BM25 + 向量相似度 + 时间新鲜度 + scope 匹配 + 重要度 + 置信度。
不要一上来就做 GraphRAG 或 MemoryOS。 只有当你真的遇到跨 session 多跳推理、实体关系持续变化、企业级权限审计这些问题时,再考虑图谱和分层 OS。
从 MVP 到高级版的路线图
阶段 1:文件记忆。 几个 markdown 文件,USER.md 和 PROJECT.md。最简单也最值得先做。你会发现光是这一步,Agent 的跨会话体验就好很多了。
阶段 2:结构化记忆。 把记忆拆成 item,带类型、scope、来源、重要度。这样能按条管理,能过期,能删除。
阶段 3:混合检索。 BM25 + Vector + Rerank。到这一步大多数场景已经够用了。
阶段 4:分层记忆。 短期任务状态、中期项目摘要、长期稳定事实分开。
阶段 5:图谱/时间线。 只有关系和时间变化很重要时再上。
阶段 6:Sleep-time 整理。 参考 Letta 的思路,把记忆整理放到空闲期,不阻塞当前对话。
我目前在阶段 3,暂时没有往图谱走的需求。大多数人做到阶段 2-3 就够用了。
几条跨方案经验
分层/树状结构通常更强。 扁平向量库只能找相似条目,树和分层结构可以同时保留"概念"和"细节"。对多跳推理尤其重要。
信息完整性比结构化抽象更重要。图谱看起来更高级,但结构化提取容易丢信息。原始对话里的语气、上下文、否定、条件、时间范围,经常无法完整进入三元组。摘要式 + 原文可追溯,比纯图谱更稳。
关联机制是多跳推理的命门。如果每条记忆都是孤立的,系统很难回答"这件事和上次那个决策有什么关系"。A-MEM 的动态链接、Zep 的图谱、Mem0 的相似记忆更新,都在增强关联能力。
时间推理不能只靠存储结构。需要时间戳、有效期、版本、事件链、最近性权重、冲突处理。用户以前喜欢 A 现在不喜欢了,客户上个月是 active 现在 churn risk,这类问题不能只靠向量检索。
还有一个容易忽略的:索引维护成本很容易被低估。 图越大去重越难,树越深插入越贵,记忆越多冲突越多,自动更新越多调试越难。论文里看不到这些成本,但生产里直接体现在延迟、账单和线上 bug 上。
最后说一句
Agent Memory 这东西,很容易被讲得很玄。什么"让 AI 像人一样积累经验",什么"记忆操作系统"。
但做工程的人知道,先做最简单的版本,遇到真实问题再加复杂度。这个原则在 Memory 这件事上尤其适用。
Memory 的价值是让 Agent 少忘关键事、少重复犯错、少被错误历史误导。 一个好的记忆系统,应该让 Agent 更稳定,而不是更神秘。
如果你也在做 Agent Memory 相关的事情,欢迎来聊。我会持续分享实战过程中的真实经验,包括踩的坑。毕竟这东西目前还没有标准答案,大家都在摸索。