图解5种主流 Agent Memory框架
一、mem0,智能记忆管理
技术核心:
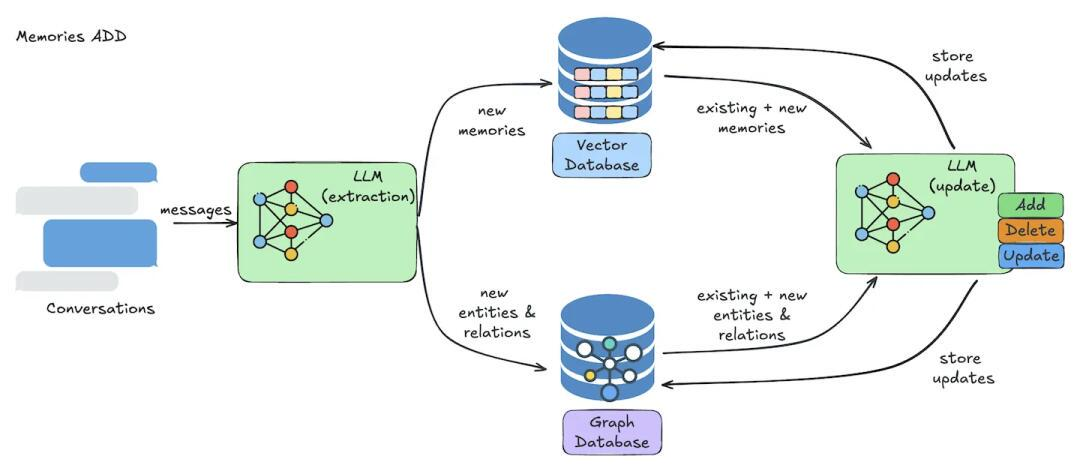
多层次记忆架构
🔔
Mem0支持用户级、会话级、Agent级的记忆。
这种结构让AI能跨会话、跨场景地“记住”用户的偏好、习惯和历史互动,提升了个性化体验的连贯性
👉开源:mem0(点击跳转)
记忆提取与向量化存储
📌
Mem0依赖大语言模型(如OpenAI)通过定制Prompt,从非结构化文本中抽取“事实、偏好、记忆”
抽取后的记忆会被向量化,存入向量数据库。这种方式便于后续的相似度检索和快速调用,技术上类似于RAG(检索增强生成),但更聚焦于个体用户的长期数据
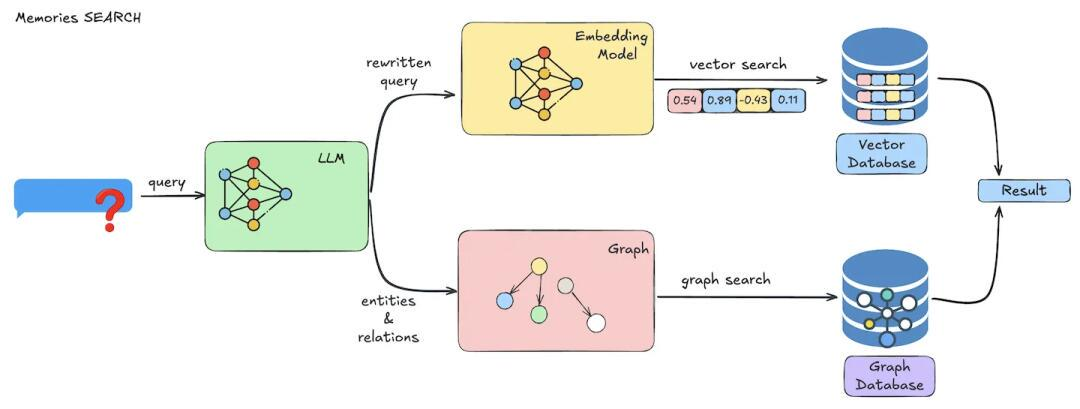
自适应与可更新机制
📌
每次用户与AI交互,Mem0会自动分析新信息与历史记忆的关系。
决定是新增、合并还是更新已有记忆
这种机制减少了冗余和冲突,理论上能让记忆库更“干净”、更有用
API友好与开发者体验
📌
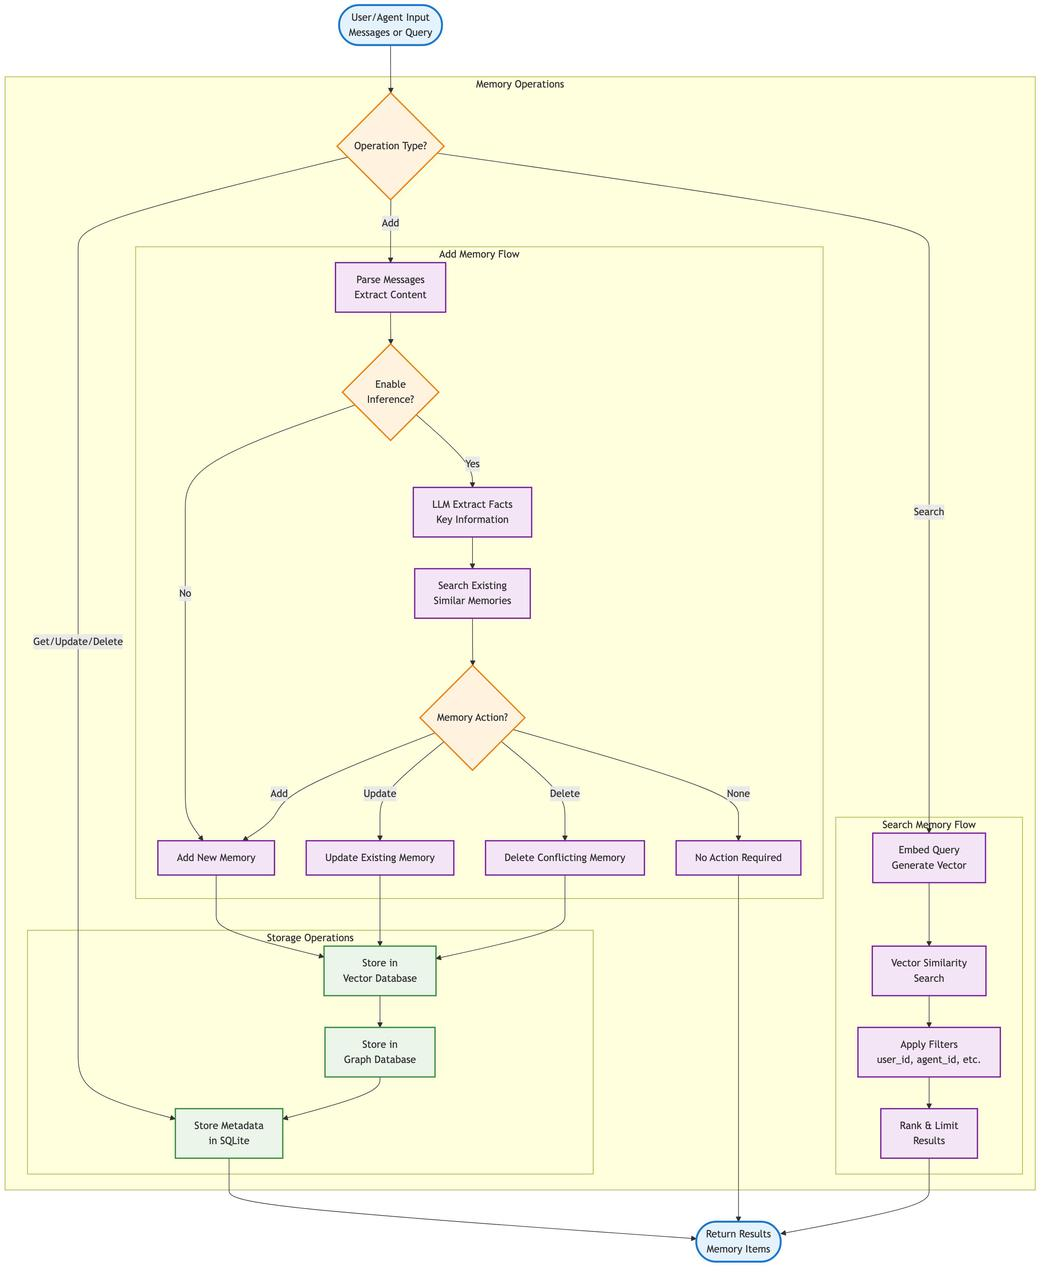
Mem0提供了简单的API接口,支持Python调用。
开发者可以通过add、search、update等方法灵活管理记忆,schema可自定义,适合不同场景的需求。
主要功能:
📚 长期记忆
Mem0利用自适应记忆系统,能记住你的偏好和交互方式,让AI的回答更连贯,更符合你的期待!
🌐 跨应用个性化
无论你在哪里用AI,Mem0都能保持信息的连续性和上下文的一致性,让你的体验从未如此流畅!
33%
33%
🚀 智能自我改进
它会根据你的反馈和交互不断优化,让回答更准确,服务更贴心!Mem0真是越用越懂你!
💾 高效存储和管理数据
帮你的个性化AI系统高效地管理和利用数据,系统性能UP UP!
33%
二、Graphiti,实时知识图谱构建框架
58%
42%
👉地址(开源): Graphiti (点击跳转)
🌐
•
目前Graph在Agent规划、执行、记忆管理和多Agent协调四个方面进展丰富,以下从这四个方向总结图与AI Agent的结合方式
1️⃣ Agent规划:任务推理、分解与决策
图结构优化Agent的任务规划,提升效率
📌
任务推理:
知识图谱通过提取多跳子图信息,增强大语言模型(LLM)Agent的任务理解能力,帮助推理复杂任务逻辑。树状或复杂图结构可组织Agent的中间思维,形成清晰推理路径。
2️⃣ Agent执行:工具调度与环境交互
图结构提升Agent执行效率,优化工具使用和环境交互
📌
工具使用:
工具图清晰展示工具互连关系,帮助Agent高效管理和调用工具,选择最优工具组合。
环境交互:
场景图(Scene Graph)编码视觉场景中对象及其空间、语义关系,支持Agent通过启发式或学习方法建模环境交互,适应复杂场景。
3️⃣ Agent记忆:组织、检索与维护
图结构化记忆揭示信息关联,提升Agent动态适应能力
📌
记忆组织:
知识图谱系统化存储长期记忆,便于调用。
记忆检索:
图检索增强生成(Graph-based RAG)高效提取有用信息📈。
记忆维护:
4️⃣ 多Agent协调:优化通信与任务分配
图建模通信路径,提升多Agent系统效率
📌
任务特定关系:
三、letta,Stateful Agents
🌐
•
也就是之前的MemGPT,提供了一个用于构建stateful agent的开发平台。
相当于一个中间层,可以Docker启动后比较方便地接入项目,还可以帮助记录应用运行情况
49%
51%
地址(开源):👉点击 letta(点击跳转)
实现核心:记忆分级和使用function call处理记忆。
记忆架构
MemGPT使用两级记忆机制:main context和external context。
main context
📌
external context
📌
外部数据库,不属于LLM的提示词。
包括:
•
archival storage (存储任意长度文本对象的读/写数据库)
•
recall storage (存储对话消息的数据库)
记忆管理
Queue Manager
✍️
queue manager管理recall storage和FIFO queue的消息。
Function executor
🌐
四、memary,Agent记忆管理
地址(开源):👉点击 Memory(点击跳转)
Memary的内存结构:
•
为了向没有现有Agent的开发人员提供访问权限,设置了一个简单的Agent实现,基于给定所提供的工具,使用ReAct Agent来规划并执行查询。
📌
•
搜索工具对于从知识图谱检索信息至关重要。
这个工具基于现有节点查询知识图谱以获取响应,并在没有相关实体存在时执行外部搜索。
•
默认工具:LLaVa支持的计算机视觉
•
默认工具:使用geocoder和谷歌地图的位置工具
记忆模块由记忆流(Memory Stream)和实体知识库(Entity Knowledge Store)组成,记忆模块的设计受到了微软研究院提出的K-LaMP设计的影响。
实体知识库
按相关性对实体进行排序:
使用频率和新近度对实体进行排序。经常提及(高计数)和最近引用的实体可能具有很高的重要性,用户非常了解这个概念。
代码块
Plain Text
def _select_top_entities(self):
分类实体:
根据它们的性质或被提及的上下文将实体分门别类(例如,技术术语、个人兴趣)。这种分类有助于快速获取针对用户查询量身定制的相关资讯。
代码块
Plain Text
def _convert_memory_to_knowledge_memory(
突出显示随时间的变化:
识别实体排名或分类随时间的任何重大变化。最常提及的实体的变化可能表明用户的兴趣或知识发生了变化。
新建上下文窗口
利用与用户相关的关键分类实体和主题来更紧密地定制Agent响应,以适应用户当前的兴趣/偏好和知识水平/专业知识。
Agent响应:
代码块
Plain Text
def get_routing_agent_response(self, query, return_entity=False):
最相关的实体:
代码块
Plain Text
def get_entity(self, retrieve) -> list[str]:
聊天记录(已摘要以避免Token溢出)
代码块
Plain Text
def _summarize_contexts(self, total_tokens: int):
五、Cognee,AI Agent记忆层
地址(开源):👉点击 Cognee(点击跳转)
🌐
Cognee是一个开源的端到端知识图谱构建与检索框架。它的流程非常清晰,称为 ECL(Extract-Cognify-Load) 流水线
📌
•
Extract (提取):
摄入文本、图片等各种格式的原始数据。
Cognee架构
🌐
cognee使用Docker的内置DNS服务发现机制,使服务能够通过容器名称相互访问。
例如,主服务可以通过"postgres"主机名访问PostgreSQL数据库。
Cognee框架
📌
•
chunk_size:
文本分块大小(例如:200, 500, 1000个token)
•
search_type:
检索策略(例如:用矢量搜索文本块 vs 用图谱搜索三元组)
部署与扩展
•
cognee提供了多种部署选项,使开发者能够根据需求选择合适的部署策略。
Docker Compose部署
•
对于开发和小型部署,cognee提供了docker-compose.yml配置文件,简化了多服务部署:
代码块
Python
# 启动主服务和PostgreSQL数据库
docker-compose up -d
# 启动MCP服务
docker-compose --profile mcp up -d
# 启动前端服务
docker-compose --profile ui up -d
这种部署方式适合快速启动和测试整个系统,同时保持服务的隔离性。
Kubernetes部署
•
对于生产环境,cognee提供了Helm图表,支持在Kubernetes集群上部署:
代码块
YAML
# deployment/helm/Chart.yaml
apiVersion: v2
name: cognee
description: A Helm chart for cognee AI memory platform
type: application
version: 0.1.0
appVersion: "1.0.0"
📌
架构作用:
•
根据需求选择和部署所需的组件
•
独立扩展高负载服务
•
采用不同的技术栈满足特定组件的需求
•
简化系统维护和更新