当下10种主流LLM Agent Memory方案统一分析对比
背景
为什么需要 Agent Memory
•
LLM 原生上下文窗口有限,长对话、多轮交互、跨会话任务易丢失信息;
•
Memory 让 Agent 实现知识累积、迭代推理、持续进化,支撑复杂长程任务;
•
区别于 RAG:Memory 聚焦交互态、会话内 / 跨会话动态信息,RAG 聚焦外部知识库
Agent Memory vs LLM Memory
•
LLM Memory:模型预训练知识(静态)
•
Agent Memory:智能体运行时记忆(动态)
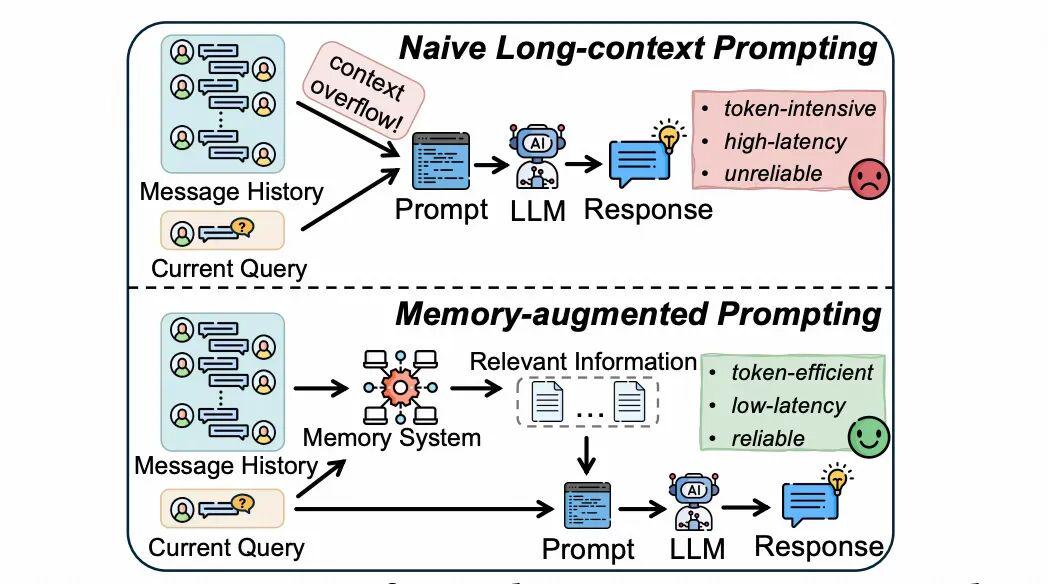
naive long-context prompting和记忆增强prompting概述
Agent Memory工作流程
Agent通常通过以下几步来有效地管理记忆:
•
记忆存储(Memory Storage):设计策略存储重要的交互信息
•
记忆更新(Memory Update):随着交互不断更新,优化响应
•
记忆检索(Memory Retrieval):根据当下需求检索相关内容
一、代表性Agent Memory方案
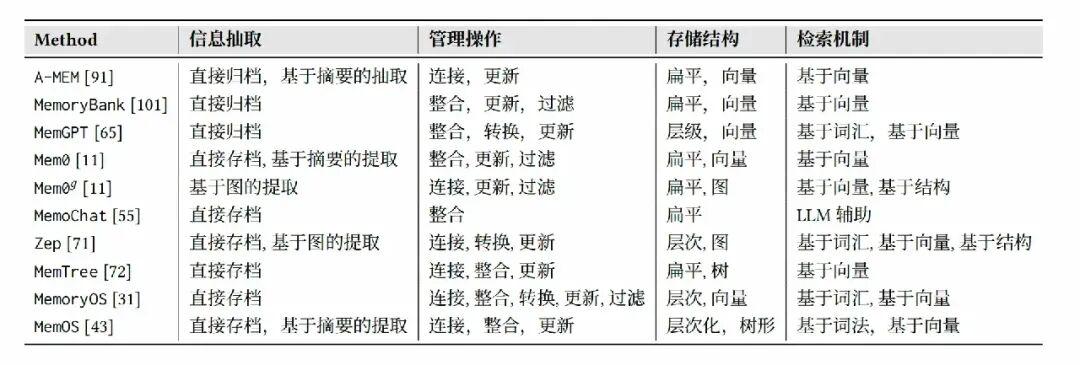
代表性Agent Memory方法的分类
A-MEM
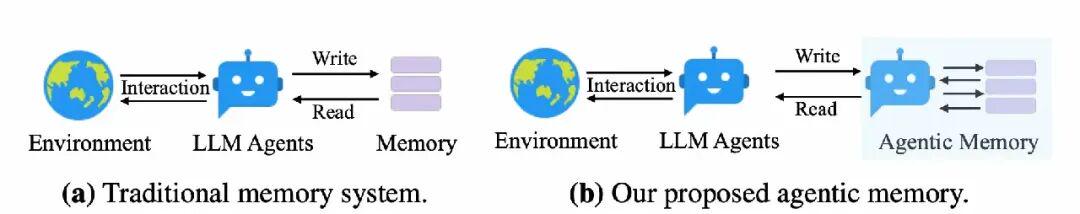
传统记忆系统都需要预先定义workflow中指定的Memory访问模式,这限制了它们对各种场景的适应性。相比之下,A-MEM 通过支持动态Memory操作,增强了 LLM Agent的灵活性。
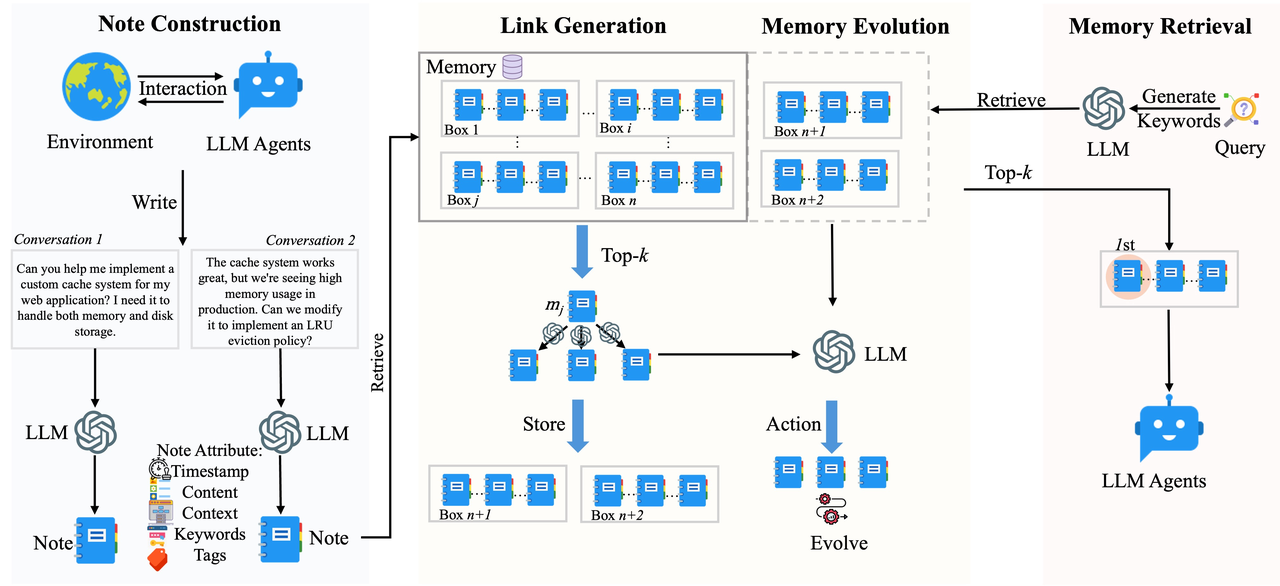
A-MEM 架构
A-MEM 核心过程
笔记构建过程:新增交互记忆时,自动生成结构化多维笔记,结合上下文描述、关键词、标签等属性,完成单条记忆的标准化结构化存储
链接生成过程:基于Zettelkasten卡片盒思想:先检索与新记忆最相关的历史记忆,再由LLM判断并建立记忆间关联链接;创新支持单条记忆可归属多个关联盒子,打破单一归类限制,构建互通互联的知识网络。
记忆检索过程:利用文本编码模型生成查询Embedding,在记忆库中检索匹配记忆;命中目标记忆后,自动联动跳转同盒子内所有关联链接记忆,实现语义检索+关联网络完善和加深对知识的理解。
Zep (Graphiti)
Zep记忆模型核心结构
在Zep中,内存通过一个时间感知的动态知识图 (G = (N, E, φ) 提供,其中 (N) 表示节点,(E) 表示边,(\varphi) 是一个形式的关联函数。知识图包括三层次的子图:
情节子图:包含原始输入数据的节点,并通过边连接到提及的语义实体。
语义实体子图:构建于情节子图之上,节点表示从情节中提取的实体。
社区子图:表示强连接实体的集群,并提供其摘要。
核心机制:时间感知知识图谱引擎。融合非结构化对话与结构化业务数据,保持历史关系演化轨迹,属于GraphRAG()变体。
MemoryBank
MemoryBank框架,SiliconFriend是一款基于LLM的AI助手,并集成了Memoryank的功能。
MemoryBank概述
•
记忆存储:存储过往对话、事件摘要和用户画像
•
记忆更新机制:更新记忆存储。
•
记忆检索:用于召回相关记忆。
核心机制
在每层Transformer中插入可更新的Memory Tokens:
•
固定参数:预训练的模型参数(不变)
•
Memory Tokens:可读写的记忆单元(可更新)
•
终身学习:持续学习新知识,对抗遗忘
🌌
核心机制:基于艾宾浩斯遗忘曲线的记忆衰减模型。根据时间流逝和重要性动态调整记忆强度,实现自适应遗忘与强化。
MemoChat
MemoChat 流程的整体架构。在维护人类用户和聊天机器人之间的聊天流(左侧部分)的同时,聊天机器人将拥有一个配备备忘录功能的内部思考系统(右侧部分)。
⚙️
核心机制:迭代式"记忆-检索-回复"循环。通过结构化备忘录维护长程对话一致性,优化开放域多轮交互。
MemGPT
MemGPT(左图)在收到关于上下文空间有限的系统警报后,会将数据写入持久Memory。MemGPT(左图)可以搜索上下文之外的数据,以便将相关信息带入当前上下文窗口。
在 MemGPT 中,固定上下文的 LLM 处理器通过分层内存系统和函数进行增强,使其能够管理自身的Memory
核心思想:
把 LLM 当成“CPU + 少量Memory”,再配一个“外部大内存 + OS 风格调度”。LLM 的prompt tokens ((输入),或称主上下文,由系统指令、工作上下文和一个 FIFO 队列组成。LLM 的completion tokens(输出)由函数执行器解释为function call。
MemGPT 使用函数在主上下文和外部上下文(归档和调用存储数据库)之间移动数据。LLM 可以通过在其输出中生成一个特殊的关键字参数(request heartbeat=true)来请求立即进行后续 LLM 推理,从而将函数调用链接起来;函数链接使得 MemGPT 能够执行多步骤检索以回答用户查询。
主要分为三个步骤:
虚拟上下文(Virtual Context)
系统式的缺页/换页逻辑
◦
把近期对话或中间状态总结成记忆块写入持久 memory
◦
当系统检测到“上下文空间不足”(system alert),MemGPT 触发写操作:
◦
当模型需要某个不在上下文里的信息时,通过检索工具从外部记忆中拉回相关片段,再注入到当前 prompt
LLM 自己管理记忆
◦
写入 memory(决定哪些内容值得长期记住)
◦
搜索 memory(根据当前任务需要拉回什么)
◦
不是外部程序决定存什么、取什么,而是LLM 自己通过工具调用来:
MemoryOS
核心机制:三层存储架构(短期/中期/长期)。短期→中期采用FIFO策略,中期→长期基于热度评分(访问频率+时间衰减)。
三层存储架构
三层存储架构
•
短期记忆(STM):固定长度FIFO队列,存储近期对话页,聚焦即时上下文。
•
中期记忆(MTM):按主题将对话页聚合成segment,以语义+关键词相似度为聚合指标,作为近期重要话题缓存。
•
长期个人记忆(LPM):存储稳定的用户/Agent画像、知识库及偏好,保障跨会话个性化一致性。
迁移策略
•
STM→MTM:FIFO驱动,队列满时将最旧页面合并至对应MTM主题段。
•
MTM→LPM:基于热度评分(访问次数+对话页数+时间衰减),热度超阈值则转化为LPM条目,低热度则优先驱逐
MemOS
Memory的形式化建模(MemCube 抽象)
•
论文里强调三大类记忆:
◦
Parametric:模型权重里的知识
MemOS 引入一个统一的记忆单元抽象(MemCube),用于把这些不同形态的数据变成一个统一可管理的对象,标注来源、重要性、使用历史,支持迁移、合并、追踪溯源
把记忆当“系统资源”来调度
◦
表示(representation)
◦
组织(organization)
◦
调度(scheduling)
◦
演化(evolution)
◦
类似 OS 对 CPU/内存/IO 的调度,MemOS 对记忆进行:
任务在跑的时候,系统可以动态决定加载哪些记忆、淘汰哪些记忆、如何在不同形式的记忆之间迁移
记忆中心的执行框架
◦
下一个 token 怎么生成,不仅看 prompt,还看“当前可访问的记忆视图”和记忆策略
◦
MemOS 建立一个“memory-centric”的运行框架:
🚀
核心机制:将记忆视为可管理系统资源,构建完整的记忆操作系统抽象层,包含复杂的资源调度与生命周期管理。
Mem0
Mem0的工作流程
Mem0ᵍ的工作流程
核心机制:动态个性化记忆提取。从持续对话中实时提取、整合、检索用户特定信息,变体引入图结构。
•
动态抽取:精准识别用户身份、偏好、任务等信息,结构化抽取为记忆条目,避免冗余存储。
•
多信号检索:融合语义相似度、实体匹配、会话作用域与时间衰减,高效筛选关键记忆。
•
图结构:构建实体关系有向图,支持多跳推理,快速关联相关记忆片段。
MemTree
MemTree 提出的是一种层级树状记忆结构,核心是用“树 + 语义嵌入 + 动态重构”来管理长期记忆。
•
树状层级表示:节点包含聚合文本、语义嵌入与抽象层级,从顶层主题到底层具体片段,结构清晰。
•
动态结构调整:新信息到来时,依据语义相似度实现节点合并、新建或分支扩展,随对话动态演化。
•
检索优势:高层粗筛、底层细粒度搜索,减少检索空间,适配多轮对话与长文档问答,保持全局记忆结构。
🚪
核心机制:动态树状记忆表示。将记忆以树状结构组织,每个节点封装聚合文本、语义嵌入及跨层抽象信息,通过实时语义相似度计算动态调整树的结构(如节点合并、拆分、层级调整),实现记忆的分层抽象与高效检索,适配复杂场景下的多粒度记忆需求
二、统一框架下的模块化分解
将现有的智能体记忆系统分解为统一框架下的 模块化组件,该框架包含四个关键组件:
•
信息提取
•
记忆管理
•
大型记忆存储
•
大型信息检索。
Agent Memory系统的统一框架概述,用户消息 → 信息提取 → 记忆管理 → 记忆存储 → 信息检索 → LLM生成回复
2.1 信息提取(Information Extraction)
三种实现范式:
直接归档:零处理存储原始消息+时间戳(MemoryBank、MemGPT)
摘要式提取:LLM生成简洁摘要或提取关键词/标签(A-MEM、Mem0),依赖prompt工程
基于摘要提取的示例prompt
图式提取:提取SPO三元组构建知识图谱,保留结构化关联(Mem0ᵍ、Zep),同样基于prompt
基于图的提取
2.2 记忆管理(Memory Management)
Memory Management流程的工作机制
该过程模拟人类记忆生命周期,包含五项核心操作:关联相关经验、整合碎片化信息、将短期记忆转化为长期记忆、更新过时内容以及过滤陈旧知识
五大核心操作:
关联相关经验
◦
基于语义相似度/时间接近性/上下文相关性建立连接
◦
A-MEM/MemoryOS():语义关联链接
整合碎片化记忆
◦
MemoryBank:日常记录→事件摘要→全局用户画像
◦
MemoChat:主题分组+主题级摘要
跨层级转换
◦
MemoryOS:FIFO短期→中期,热度评分中期→长期
◦
Zep:语义社区形成机制
更新现有记忆
◦
规则驱动:MemoryBank的遗忘曲线、MemoryOS的相似度整合
◦
LLM驱动:MemTree的聚合操作(压缩+泛化)
◦
Agent驱动:MemGPT的自主工具调用
过滤无效信息
◦
基于使用:MemoryOS的访问频率+时间衰减
2.3 记忆存储(Memory Storage)
组织方式:
•
扁平式:FIFO队列/JSON文件(MemoryBank)
•
分层式:多粒度存储池(MemoryOS三层架构)
表示方式:
•
向量存储:高维嵌入+相似度检索(FAISS/Qdrant,主流方案)
•
图存储:
◦
MemTree:层次化树结构,节点封装不同抽象层级
◦
Zep:时序知识图谱,原始消息节点+SPO三元组+实体社区
2.4 信息检索(Information Retrieval)
四种检索范式:
词汇检索:BM25/Jaccard相似度,适合精确匹配
向量检索:余弦相似度+ANN算法,解决词汇失配(最主流)
结构检索:
◦
Mem0ᵍ:相似度搜索→子图构建
◦
Zep:BFS图遍历增强初始结果
LLM辅助检索:查询重构+实体识别(MemoChat)
三、性能评估
实验设置
LOCOMO:人类间长程对话
•
10个对话,平均198.6问题/27.2会话/588.2轮次
•
评估:单跳/多跳检索、时间推理、开放域知识
LONGMEMEVAL:用户-AI长程交互
•
500问题,平均50.2会话/11.5万token
•
评估:信息提取、多会话推理、知识更新、时间推理
实验结果
各方法在 LONGMEMEVAL 上的对比
💡
MemTree、MemOS(树状)、MemoryOS(分层)性能最优。树结构在上层保留概念摘要、叶节点保留细节,实现高效信息流动。
保留原始消息的方法优于纯图三元组提取(Mem0 > Mem0ᵍ)。结构化提取易导致语义丢失,这是图式方法的固有缺陷。说明信息完整性是记忆管理的基础。
各方法在 LOCOMO 上的对比
信息完整性是记忆管理的基础:保留原始消息的方法优于纯图三元组提取(Mem0 > Mem0ᵍ)。结构化提取易导致语义丢失,这是图式方法的固有缺陷。说明信息完整性是记忆管理的基础。
关联能力决定多跳推理上限:缺乏关联操作的方法(MemoryBank、MemGPT)在多会话任务中表现极差。Mem0通过相似记忆同步更新实现隐式关联,性能显著提升。
时间推理强依赖模型能力:模型从7B→72B时,时间推理任务性能翻倍(MemoryOS、MemoChat)。现有方法普遍缺乏专门的时空信息处理组件。
LOCOMO 上性能与 token 成本之间的总体权衡
MemTree和MemOS实现高准确率但token开销显著。F1得分与平均token消耗呈正相关。
LOCOMO 上各会话的平均每对话 token 成本
处理粒度影响成本
•
MemoryOS:对话片段粒度(中期存储)
•
MemoryBank:每日粒度摘要
•
粗粒度处理不一定降低性能,甚至可能因LLM泛化能力而提升效果
索引机制的扩展性瓶颈
•
MemTree:树深度增加导致自顶向下插入成本上升
•
Zep:图复杂度增长导致去重与一致性维护成本攀升
•
频繁更新场景下需权衡索引精度与维护开销
PDF链接
•
https://arxiv.org/pdf/2504.19413
•
https://arxiv.org/pdf/2505.22101
•
https://arxiv.org/pdf/2410.14052
•
https://arxiv.org/pdf/2604.08224