图解5种 Agent Memory 主流框架
Mem0(智能管理记忆)
一、定位
💙
Mem0 核心解决多会话、多 Agent、多客户端的用户记忆统一管理,是目前工程落地里常用的Memory Module 标准化实现方案,可无缝对接 Claude 工作流体系,和 Memobase、Letta 形成记忆层互补选型。
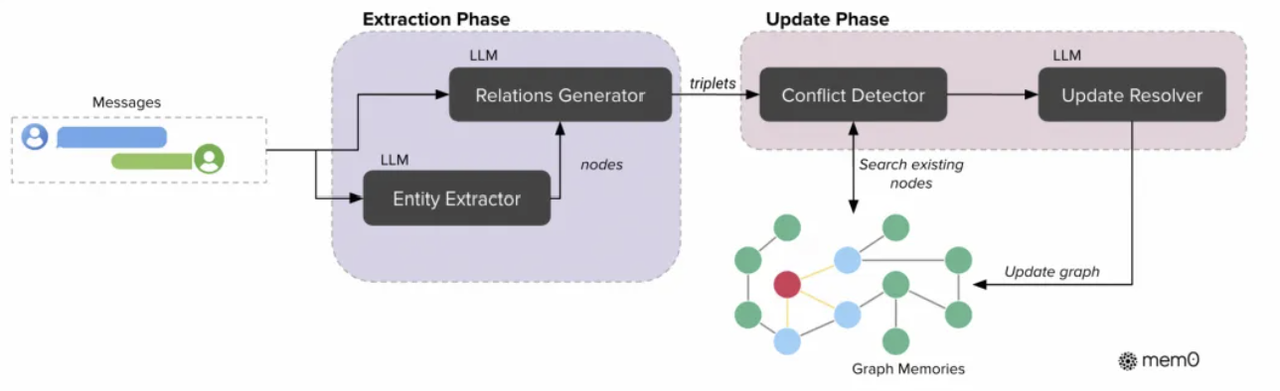
Mem0的工作流程
56%
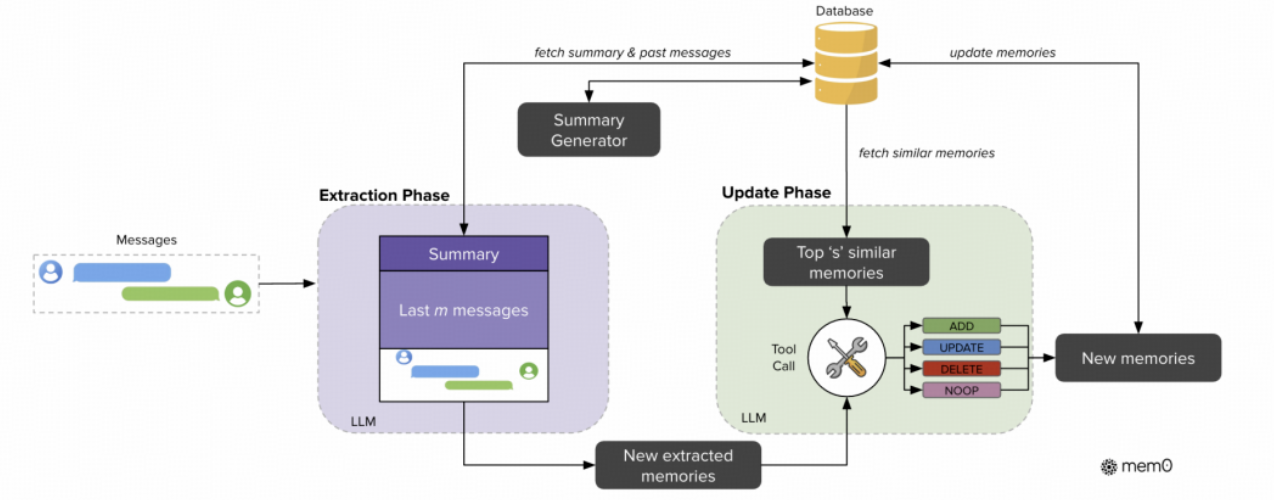
Mem0的工作流程
44%
二、核心架构三大记忆分层
💡
用户画像记忆(Profile Memory) 自动从对话抽取用户偏好、业务要求、固定规则、历史约定,结构化存储;同用户任意 Agent 启动自动加载画像。
会话时序记忆(Episodic Memory) 按时间线保存历史交互事件、任务过程、过往执行结果,支持按时间段、任务标签检索,对标 Memobase 时序库。
语义常识记忆(Semantic Memory) 提炼跨会话通用结论、沉淀复用经验,自动去重、归纳,用于后续任务推理参考。
底层:向量库 + 关系库混合存储,内置 LLM 自动摘要、记忆抽取、冗余淘汰,不用开发者自己写记忆解析逻辑。
三、关键特性
💡
跨平台统一记忆 一套记忆库对接 Claude、OpenAI、本地开源大模型、多 Agent 实例,同一个用户在不同工作流、不同智能体共用记忆,解决多 Agent 记忆孤岛。
自动记忆蒸馏 对话结束后后台异步提炼关键信息入库,过滤闲聊无效内容,无需手动调用写入接口,类似 Memobase 梦境蒸馏机制。
记忆粒度可控 支持手动增删改记忆、打标签、设定过期规则,适配工作流里迭代更新筛选标准、校验规范。
API 轻量化接入 一行 SDK 接入,替换自研记忆模块,大幅缩短 Agent 工作流开发周期。
四、工作流落地
整体链路: 工作流 Agent → Letta 管控上下文 → 需要历史经验查 Mem0/Memobase → 需要外部资料调取 HippoRAG2。
分类并执行:历史分类经验、用户需求特征存入 Mem0,分类器启动自动召回历史路由经验。
扇出并综合:各子 Agent 临时上下文由 Letta 管理,汇总阶段从 Mem0 调取同类历史拆分方案辅助合并结果。
对抗性验证:校验基准、历史错误案例存 Mem0,校验 Agent 统一调取标准做合规核验。
生成并筛选:筛选规则、优质案例沉淀进 Mem0,批量生成时复用历史筛选逻辑。
锦标赛:历次参赛方案、评审打分、最优结果入库,新任务优先参考历史优胜思路。
循环直至完成:每轮迭代日志时序存入 Mem0,新一轮迭代读取过往记录,避免重复排查。
五、适用场景
AI 客服、个性化助理、SaaS 内嵌智能体、多端互通对话机器人、中小型 Agent 工作流快速落地。
Memobase(突触记忆)
💙
智能体的突触记忆存储层,主打用户画像 + 时序事件双架构记忆,依托 MCP 标准可原生对接 Claude 全系列模型,完美嵌入前文六种 Agent 工作流架构。
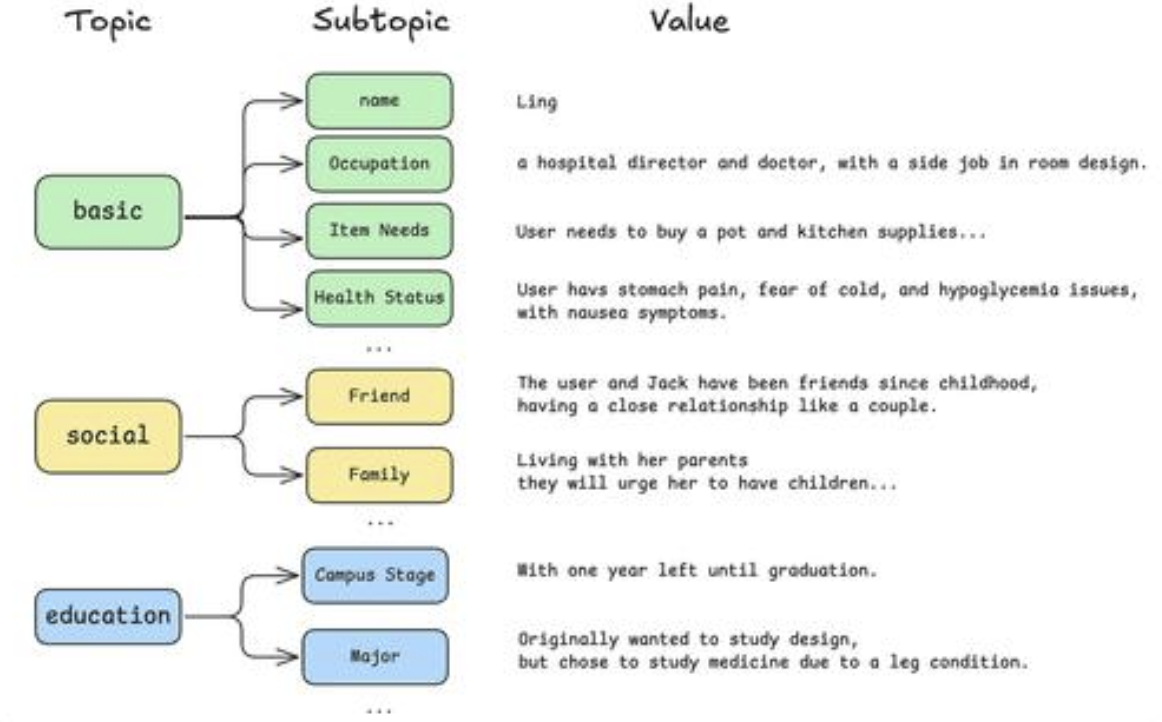
一、核心架构与三大关键机制
双层存储:画像记忆 + 时序事件记忆
✅
•
结构化 Profile(画像库):自定义记忆字段,固化筛选规则、分类标准、评审细则、用户偏好、Agent 固定配置,以树形分类存储(如业务规则/方案筛选标准),全量结构化可精准检索,替代零散文本存储;
•
Timeline 时序事件库:按时间戳记录每轮任务执行日志、迭代过程、错误记录、锦标赛比拼结果,自带时间属性,可区分历史有效 / 失效信息,规避过时记忆干扰新任务。
缓冲区 + 后台梦境蒸馏(Dream Phase)
✅
向量 + 图谱混合召回
✅
融合向量语义检索与轻量化知识图谱关联检索,既可以自然语言模糊查找历史内容,也能依托实体关联追溯跨任务的历史经验,检索时延普遍低于 80ms,兼顾语义泛化与精准事实召回MemoBase。
MCP 原生通信协议
✅
基于 Model Context Protocol 标准化对接,Claude、Cursor 等工具无需额外适配即可直连 Memobase,实现跨模型、跨 Agent 共享同一套记忆基准数据,解决多智能体记忆割裂问题。
二、Memobase、Letta、HippoRAG2 三者分工(Memory Module 三层落地)
Memobase:结构化私有长效记忆(规则 / 履历 / 画像) 存放工作流沉淀的筛选规则、分类阈值、历史评审打分标准、历次任务复盘、用户长期特征,属于 Agent 自身经验记忆;
Letta:运行时状态管理 + 短时内存调度 管控上下文窗口、动态内存读写、运行时临时缓存,决策何时从 Memobase 拉取历史规则、何时向 Memobase 写入新经验,做记忆调度中枢;
HippoRAG2:外部公共知识库(行业文档、原始资料) 全量业务文档、外部参考素材图谱化存储,属于公共知识,对抗验证、资料溯源时按需调取,不占用 Agent 私有记忆空间。
Memory Module 顶层统一封装调用逻辑,向下调度三类存储,向上对接六大 Claude 工作流。
三、对接 Claude 六大智能体工作流落地细则
2.1
分类并执行
历史任务分类案例、路由判别规则存入 Memobase 画像库;分类 Agent 启动时自动拉取过往分类经验,持续迭代优化路由精度,新分类结果同步回写入库。
2.2
扇出并综合
各并行子 Agent 短时上下文由 Letta 托管;汇总环节从 Memobase 调取同类历史拆解方案辅助结果融合,子任务执行履历时序归档至 Memobase。
2.3
对抗性验证
校验标准、合规条款、历史错例统一固化在 Memobase;校验 Agent 每次核验任务固定读取基准规则,校验后产生的错误样本自动入库,持续优化校验逻辑。
2.4
生成并筛选
筛选阈值、淘汰规则、优质样本存入 Memobase;批量生成内容后复用历史筛选标准,优质创意沉淀入库,扩充筛选参考样本。
2.5
锦标赛
各参赛 Agent 方案、评审打分记录、优胜结论按时序存入 Memobase;同类新任务启动时,直接调取过往优胜思路,减少重复试错。
2.6
循环直至完成
每轮迭代排查日志、错误记录、已解决问题时序存储,新循环优先读取 Memobase 历史排查记录,避免重复排查,达到终止条件后归档全流程总结。
四、对比 Letta 核心差异
五、落地适用场景
企业业务智能工作流、知识库客服 Agent、方案决策类机器人、长周期迭代型项目智能体,适配需要持续沉淀业务规则、越迭代越智能的工程化 Agent 项目。
Letta・Stateful Agent(有状态智能体)
一、基础定义
💙
•
Stateful Agents:有状态智能体,核心是跨轮次、跨会话持久留存记忆与运行状态,区别于原生 LLM 无状态特性(每次调用清空上下文、无历史留存)Letta。
•
原生大模型天生无状态:知识只来源于模型权重 + 单次传入上下文窗口,对话结束、超出上下文即丢失全部交互信息;
•
Letta(前身 MemGPT)是业内标杆级有状态智能体开发框架,通过分层内存架构实现 Agent 自主管理记忆、长期留存任务进度、用户信息与历史决策Letta。
有无状态Agent架构对比
二、Letta 实现有状态 Agent 的核心原理
分层双内存架构(核心设计)
✅
上下文内存(In-Context Memory):常驻 LLM 上下文窗口,拆分 Persona(人设)、Human(用户信息) 等结构化记忆块,模型随时可见、直接参与推理Letta;
外置持久内存(Out-of-Context DB Memory):溢出上下文的历史对话、任务记录、工具调用日志全存入数据库永久落地,不会因上下文超限丢失数据Letta。
关键:Agent 可调用内置工具自主增删、修改、检索自身记忆,不用外部代码手动管理存储,实现智能自主记忆演化Letta。
全状态持久化
✅
Agent 全量数据(系统提示词、记忆块、聊天记录、工具调用记录、中间推理结果)统一落库,重启、隔天接续对话不会丢失进度;客户端仅需推送最新单条用户消息,不用全量拼接历史上下文,大幅节省 token 开销Letta。
3.2
自主状态迭代
Agent 在交互中自主筛选关键信息归档长期记忆、淘汰无效内容,随使用持续沉淀用户偏好、任务经验,越用越适配业务,实现跨周期持续学习。
三、无状态 vs 有状态 Agent 关键区别
四、落地适用场景
循环直至完成:长周期迭代任务,暂停重启可读取历史执行日志接续工作;
扇出并综合:多子智能体并行结果持久保存,汇总阶段直接调取历史分片数据;
对抗验证 / 锦标赛:留存历次评审记录、打分标准,后续对比复用历史校验规则;
分类执行 / 生成筛选:沉淀历史分类规则、筛选标准,持续优化路由与筛选逻辑。
五、极简 Python 调用示例(Letta-SDK)
代码块
Plain Text
from letta_client import Letta
client = Letta(api_key="你的密钥")# 创建带结构化记忆块的有状态Agent
agent = client.agents.create(
memory_blocks=[{"label":"persona","value":"专业项目助理,记住用户所有项目需求"},{"label":"human","value":"空,自动存储用户信息"}])# 仅发送新消息,历史自动持久化
res = client.agents.messages.create(agent_id=agent.id, message="帮我跟进上周文档整理任务")
HippoRAG2:仿生海马记忆
💙
HippoRAG2 是俄亥俄州立大学 ICML2025 发布、初代 HippoRAG 迭代升级版的开源检索增强框架,仿生人类大脑海马体记忆原理。
解决传统向量 RAG、GraphRAG 通病:常规图谱 RAG 做多跳强、简单事实问答反而变差,标准向量 RAG 查事实稳、跨文档多跳关联推理乏力,是目前兼顾事实记忆、语义理解、联想推理三类能力的全能型 RAG 方案。
HippoRAG2整体架构图
一、底层设计逻辑:人脑双记忆模拟
原始文档 = 大脑新皮层:存储完整段落原文(密集记忆,保留上下文细节);
自建开放知识图谱 = 海马索引:只存概念、实体、关系与关联链路(稀疏索引,负责跨文档联想跳转)。 框架全程非参数化,不用微调 LLM 权重,新增文档直接入库即可被检索调用,天然适配 Agent 持续记忆更新。
二、核心升级(对比初代 HippoRAG)
短语 + 段落双节点图谱(密集 - 稀疏融合)
图谱内置两类节点,用contains包含边绑定:
✅
•
短语节点:从原文抽取三元组(S-P-O),凝练概念、实体与关系;
•
段落节点:挂载完整原文片段,补齐短语丢失的上下文; 额外新增同义边,同义词、别名自动连通跨文档节点,大幅提升召回覆盖面。
查询→三元组深度匹配(摒弃旧版实体匹配)
✅
初代 HippoRAG 只提取问句实体找节点;HippoRAG2 直接用查询语义匹配图谱完整三元组,精准命中关系逻辑(如「A 的外祖父是谁」直接匹配亲属关系三元组,而非只匹配 A 实体),从根源减少无关召回。
LLM 在线识别记忆过滤
✅
检索后先用大模型筛除无效、不相关三元组,模拟人脑「识别记忆」,剔除噪声再进入 PPR 图游走,压缩冗余检索量。
三、两段运行流程:离线建库 + 在线检索
① 离线索引构建
LLM 批量解析文档,抽取开放域三元组,搭建无 Schema 开放 KG;
嵌入模型识别同义词,补充同义关联边;
所有原文段落生成段落节点,和对应短语节点通过包含边绑定,完成全量图谱落地。
② 在线检索(PPR 个性化页面排名为核心)
用户 Query→匹配图谱三元组,锁定初始种子节点;
LLM 初筛,删掉无关三元组;
PPR 算法在图谱上扩散游走,沿关联边多跳遍历全图,自动串联分散在不同文档的碎片化知识;
根据 PPR 得分排序关联段落,打包原文送入 Claude 等大模型生成答案。
关键优势:单次 PPR 即可完成多跳推理,不像传统 RAG 需要循环多次检索拼接,多跳场景算力成本比 GraphRAG 低约 12 倍。
四、和主流 RAG 横向对比
测评数据:联想类任务比顶尖向量 RAG 提升 7%,事实、语义理解全维度领先同代 GraphRAG、LightRAG。
五、结合你前文两大技术落地(Claude 六大工作流 + Letta 有状态 Agent)
4.1
搭配 Claude 六大智能体工作流落地
扇出并综合:各子 Agent 分片知识库分别调用 HippoRAG2 检索,汇总阶段依托图谱关联自动串联分片知识;
对抗性验证 / 锦标赛:校验 Agent、评审 Agent 统一调取同一套 HippoRAG 知识库,基准资料统一无偏差;
循环直至完成:迭代排查任务时,HippoRAG 持续检索新增文档,Letta 持久化历次检索结果;
分类并执行 / 生成筛选:分类规则、筛选标准存入图谱,后续任务自动关联历史规则知识库。
4.2
搭配 Letta Stateful 有状态 Agent
•
Letta 负责长期记忆分层存储(短时上下文 + 外置 DB),HippoRAG2 负责海量外部知识库关联检索;
•
Agent 日常对话细碎信息存 Letta 记忆,专业外部文档、行业知识库全量入 HippoRAG2 图谱,实现「私人记忆 + 公共知识库」双引擎检索,完美落地仿生长期记忆智能体。
六、适用落地场景
行业知识库问答、长文档智库分析、多步骤法律 / 科研推理、企业全量文档智能助理、长周期项目 Agent 知识库。
Memory Module(标准化记忆)
一、定义
💙
Memory Module 是 Agent 标准化记忆组件,负责统一管控智能体短时上下文、中长期历史信息、外部知识库索引,承接Letta 有状态持久化 + HippoRAG2 知识库检索。
整套模块划分为三层经典存储架构(行业通用分层):
上下文记忆|Short-term Memory(In-Context)
✅
•
驻留 LLM 上下文窗口,实时存放本轮对话指令、即时工具返回、临时中间结果;
•
容量受窗口长度限制,溢出内容自动下沉至中长期存储;
•
对接:分类路由、扇出并行单次子任务临时数据。
长效记忆|Long-term Memory(DB 持久层,Letta 落地)
✅
•
结构化存储:人设、用户画像、历史决策、历史筛选规则、过往评审标准;
•
由 Agent 自主增删、检索、更新,跨会话、跨天重启不丢失;
•
落地场景:锦标赛历史打分标准、循环迭代历史排查日志、生成筛选沉淀规则。
外部知识库记忆|External Memory(HippoRAG2 图谱 RAG)
✅
•
非 Agent 私有记忆,企业 / 项目海量文档、行业资料以图谱 + 原文双结构入库;
•
不存入 Agent 私有数据库,需要时由记忆模块发起检索调用 HippoRAG2;
二、模块内置核心能力
记忆分级路由:新信息自动判别层级,临时数据留在上下文,关键经验归档长效库,专业文档存入图谱库;
召回调度:任务启动前根据任务类型,按需拉取历史规则 / 外部资料,不用全量加载全部记忆;
记忆压缩 & 汰换:自动清理无效冗余信息,优化 token 占用,避免记忆无限膨胀;
读写权限管控:不同子 Agent(生成 / 校验 / 评审)分配差异化记忆访问权限。
三、和六种 Claude 工作流的组合落地
分类并执行:记忆模块沉淀历史分类案例,优化分类器路由逻辑,越用分流越精准;
扇出并综合:各并行子 Agent 独立使用短时记忆,汇总阶段统一从长效 / 外部库拉取分片数据;
对抗性验证:校验智能体固定调取记忆中存档的评审规范与基准知识库;
生成并筛选:筛选标准存入长效记忆,批量生成后复用历史筛选规则;
锦标赛:历次比拼结果、优劣结论入库留存,后续同类型任务直接参考历史最优方案;
循环直至完成:每轮迭代结果存入长效记忆,新循环读取过往排查记录,避免重复工作。
四、三者联动关系(Memory Module + Letta + HippoRAG2)
•
Letta:实现私有长效记忆底层存储;
•
HippoRAG2:实现海量外部文档记忆图谱化检索;
•
Memory Module:上层调度中枢,统一封装调用逻辑,对接各类工作流智能体。