作品三:AI情绪治愈平台
🔔
•
这篇文章记录的是我用 WorkBuddy + CloudBase 在3天内从0做出
《MoodWave——基于AI的情绪分析与可视化音乐治愈平台》的全过程。
一、背景:从灵感到MoodWave
50%
50%
MoodWave的起点其实很朴素:身边太多人在焦虑,但大家不愿意说出来。于是MoodWave的核心idea定了下来:
🎃
•
AI 情绪日记:用低压力的方式记录今天发生了什么
•
可视化音乐治愈:让情绪不只是文字,而是能听见、能看见
•
数据分析中心:把零散情绪变成趋势、热力图和高光时刻
•
解忧角社区:用匿名、轻社交的方式获得共鸣,而不是制造压力
二、调研阶段的WorkBuddy实战
2.1 情绪雷达:用WorkBuddy抓取全网情绪数据
在正式写代码前,我先做了一轮“情绪雷达”。
"帮我抓取小红书上大学生情绪、考研焦虑、期末压力等相关内容,整理成用户痛点和产品机会。"
50%
50%
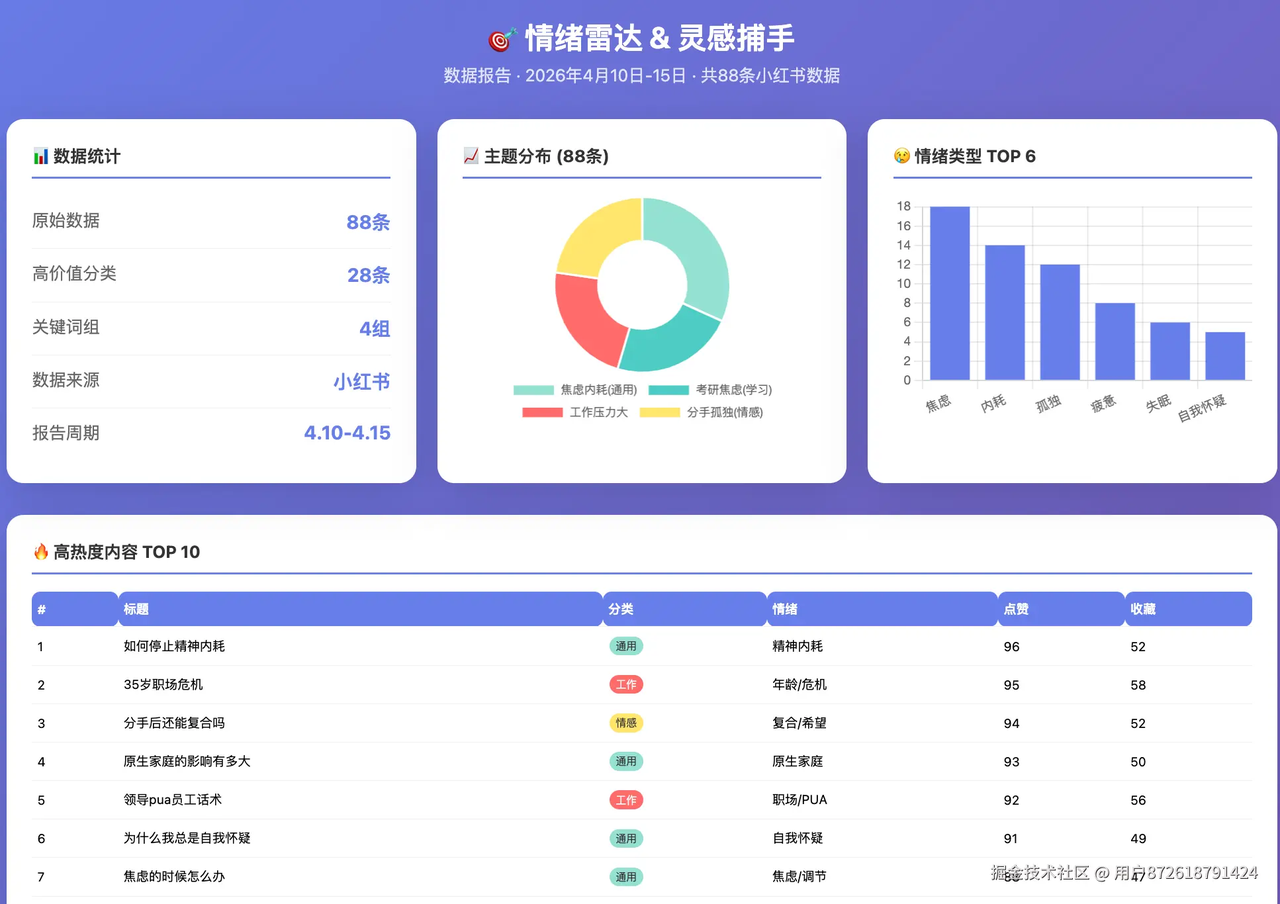
WorkBuddy 自动完成了关键词拆解、页面抓取、内容清洗和分类汇总,最后整理出 88 条真实用户情绪数据。它不是随便列几个“年轻人很焦虑”的空泛结论,而是把帖子按场景分成了几类:考研焦虑、职场压力、情感困惑、精神内耗。
🎃
这个阶段给了我一个很重要的判断:MoodWave 不能做成传统心理健康App那种“严肃问诊”的感觉。很多用户不是想被诊断,他们只是想有一个不评判的地方,轻轻放一下今天的情绪。
2.2 问卷调研:WorkBuddy + 腾讯问卷 MCP
线上数据之后,我又用腾讯问卷 MCP 做了第二轮验证。
这次我直接让 WorkBuddy 生成问卷结构:
"根据 MoodWave 的产品方向,创建一份面向大学生的情绪健康和音乐治愈调研问卷,控制在20题以内,加入防刷和红包回收策略。"
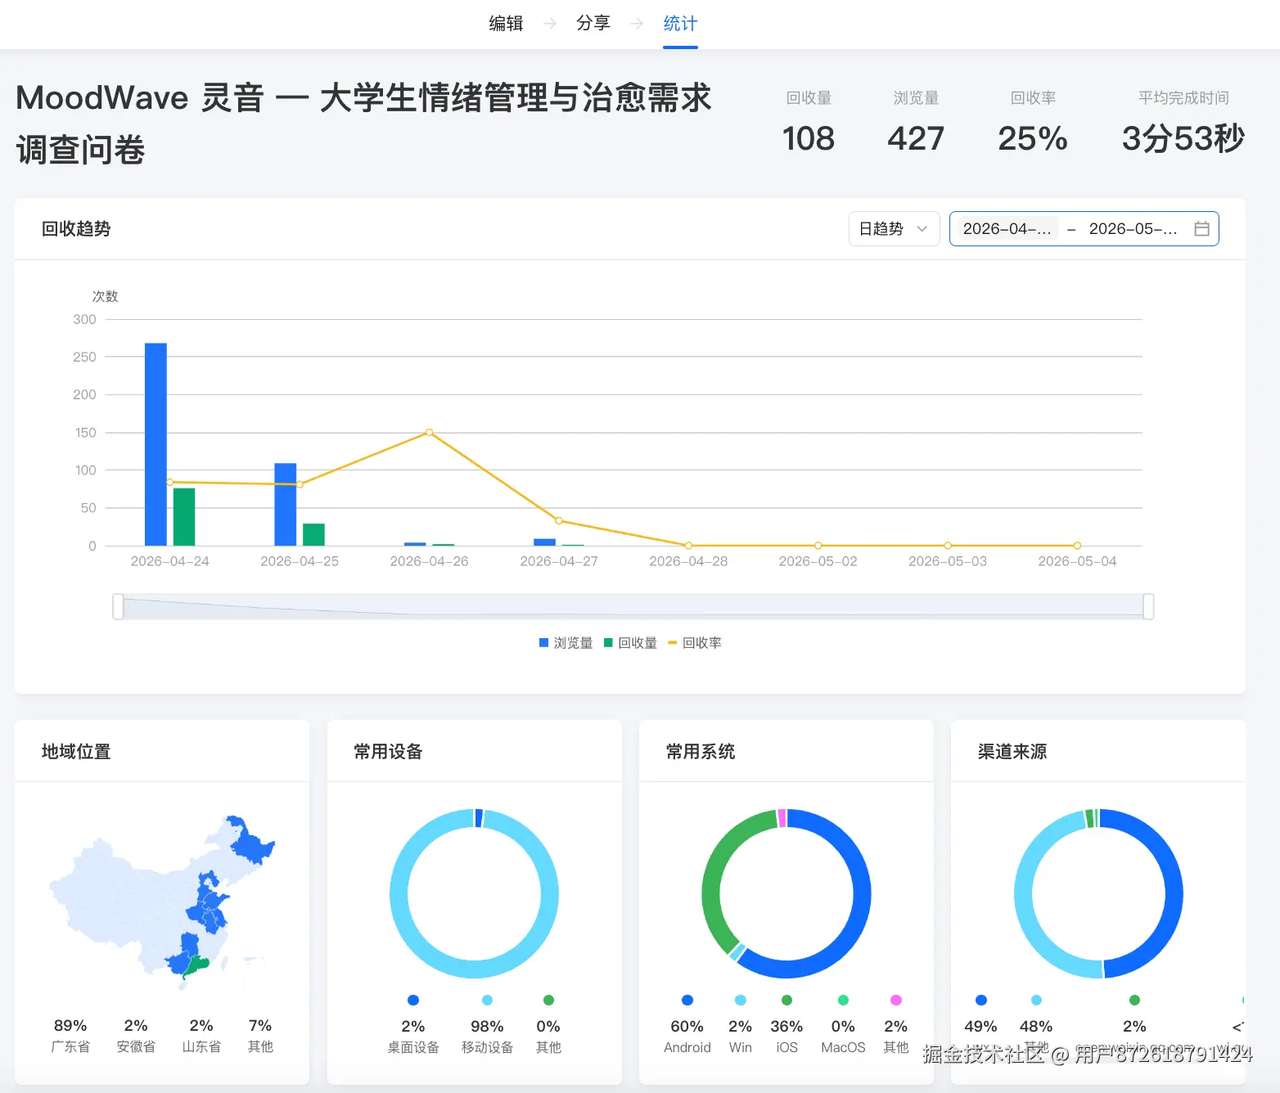
它帮我生成了20道题,并把问题分成了情绪频率、压力来源、记录偏好、音乐治愈接受度、功能吸引力几个模块。最后问卷回收了108份有效数据。
几个关键结论直接影响了后面的产品设计:
•
45.7% 用户希望首页是“干净的、让人平静的治愈界面”
•
67.7% 用户对音乐治愈产品持正面态度
•
46.7% 用户最想要“一键快速记录心情”
•
38.1% 用户对情绪数据可视化感兴趣
•
37.1% 用户希望有一个像朋友一样倾听的 AI 聊天
所以 MoodWave 的优先级很快就清晰了:先做快速记录,再做 AI 陪伴和音乐可视化,社区要轻,不要做成信息过载的论坛。
三、技术架构总览
以下是 MoodWave 的完整技术架构:
代码块
JavaScript
用户浏览器 / PWA
├─ 前端:Next.js 14 + TypeScript
│ ├─ Tailwind CSS + Shadcn/UI + Framer Motion
│ └─ Tone.js + Canvas API(音乐可视化)、Recharts(图表)
├─ Nginx 反向代理
├─ 后端:Python FastAPI + SQLModel
│ ├─ AI:DeepSeek V4-Pro(情绪分析+对话)
│ └─ 多模态:Qwen3-VL(图片) + Qwen3-ASR(语音)
├─ 数据库:PostgreSQL 16
│ └─ Docker Compose 编排 + 命名卷持久化
└─ 部署:腾讯云 + CloudBase
关键架构决策:
•
为什么用 Python FastAPI 而不是 Next.js API Routes? — Python 生态对 AI/数据采集(Hermes Agent)更友好,DeepSeek SDK 原生支持
•
为什么用 PostgreSQL 而不是 SQLite? — Docker 容器重启后 SQLite 数据丢失,PostgreSQL 命名卷持久化是生产环境的底线
•
为什么前端用 Next.js 而不是纯 HTML? — App Router 的路由系统、SSR/SSG、PWA 支持、Vercel 一键部署,对 Vibe Coding 极度友好
四、7 天Vibe Coding全流程
4.1 Day 1-2:项目搭建+问卷验证+前端基础页面
🎃
Day 1-2 的目标不是做“漂亮页面”,而是先把产品骨架搭起来:用户能进入、能登录、能看到 Dashboard,也能明确知道 MoodWave 是什么。
我给 WorkBuddy 的第一条前端指令是:
"用 Next.js 14 App Router + TypeScript + Tailwind 搭建 MoodWave 前端,做 Landing、登录注册、Dashboard 三个页面。视觉风格是赛博治愈,底色 #050505,毛玻璃容器,情绪色用霓虹渐变。移动端优先,桌面端用侧边栏。"
WorkBuddy 先生成了 frontend/src/app/page.tsx、login/page.tsx、dashboard/page.tsx,再抽出统一的 Shell 和 Logo 组件。这个过程很像搭舞台:Landing 负责讲清楚产品,登录页负责建立入口,Dashboard 则是用户每天打开后的主屏。
我当时特别强调了一个设计判断:首页不要做成密密麻麻的数据大屏。
因为问卷里 45.7% 的用户明确说想要“干净的治愈界面”,所以 Dashboard 采用的是“今日状态 + 快速记录 + 最近心情 + AI 问候”的轻量结构。底部 TabBar适配手机,桌面端才展开为左侧导航。这样用户在 390px 手机屏上不会被卡片淹没,在 1440px 桌面屏上又不会显得空。
第二轮 UI 打磨时,我又让 WorkBuddy 按“像真实产品而不是原型”的标准清理页面:能点击的入口都要有反馈,不能出现 API 路径、Mock 数据、接口预留这类开发痕迹。
后端同样是"对话式开发"。我对 WorkBuddy 说:
"帮我搭建 FastAPI 后端,创建 moods 表的 CRUD 接口,统一返回格式为 {code, msg, data}"
WorkBuddy 直接生成了完整的三层结构:
关键细节:
•
所有接口统一 {code: 0, msg: "ok", data: ...} 格式,前端只需判断 code === 0
•
用 SQLModel 同时做 ORM 和 Pydantic 校验,一个模型定义同时服务于数据库和 API
•
Tags 字段用 PostgreSQL 的 JSONB 类型(不是字符串),天然支持数组查询
给 WorkBuddy 装上"长期记忆":Skills + Memory + PRD 体系
前面说的前端页面和后端接口,都是"一次性"的对话成果。但 Vibe Coding有一个致命的痛点:每次新开对话,AI 就像失忆了一样,完全不记得你的项目规范、设计风格、技术决策。
如果每次都要重新解释"我们项目底色是 #050505、接口格式是 {code, msg, data}、数据库用 PostgreSQL 而不是 SQLite",那 7 天根本不够用。
所以 Day 1-2 搭建项目骨架的同时,我还做了一件更重要的事:给 WorkBuddy 建立一套"规范注入系统" ,让每次新对话都能自动加载项目上下文。
第一层: .agents/skills/ — 项目级 Skill,让 AI 自带"设计手册"
WorkBuddy 的 Skills 系统允许在项目目录下创建 .agents/skills/ 文件夹,里面放 Markdown 格式的技能文件。每次 WorkBuddy 启动时,会自动读取这些 Skill,把里面的规范注入到 AI 的上下文中。
我给 WorkBuddy 的指令是:
"帮我在 .agents/skills/ 下创建一个 moodwave Skill,把我们的设计规范写进去——底色、情绪色、字体、毛玻璃参数、响应式断点。以后每次我让你改 UI,你都要先读这个 Skill。"
WorkBuddy 生成了第一个 Skill 文件:
代码块
JavaScript
.agents/skills/
└── moodwave/
└── SKILL.md # 赛博治愈设计规范:霓虹情绪色、Glassmorphism、响应式断点
这个 Skill 的存在意味着:不管我在哪个对话里说"帮我改一下 Dashboard 的配色",WorkBuddy 都会先读到 #050505 底色、backdrop-blur(24px) 毛玻璃、Happy=金橙 #FFD93D 这些规范,生成的代码自然对齐项目风格。
后面随着项目迭代,Skill 体系不断扩展:
每个 Skill 就像一个"微型设计文档",AI 读到它就能理解这部分规范,不需要我每次都重新解释。
第二层:PRD 文档 — 产品的"宪法"
光有 Skill 还不够。Skill 解决的是"怎么做"的问题,但"做什么"需要更上层的文档。
Day 1 我就让 WorkBuddy 帮我创建了PRD.md:
"基于问卷数据和我的产品构想,写一份 PRD 文档,包含产品定位、目标用户、核心功能、数据模型、API 设计、技术选型"
WorkBuddy 生成的 PRD 成了后续所有开发决策的依据。比如:
•
问卷显示 67.7% 用户对音乐治愈持正面态度 → PRD 把"可视化音乐房间"列为 P0 核心功能
•
问卷显示 45.7% 用户要"干净的治愈界面" → PRD 把 Dashboard 设计原则定下来了
•
技术选型部分明确了"PostgreSQL 而非 SQLite"、"Python FastAPI 而非 Next.js API Routes"
后续还迭代了 PRD-v2-功能迭代.md(基于问卷数据新增 AI 虚拟角色等功能),以及各种专项方案文档(新手指引、第二轮/第三轮细节修改等)。
到项目结束时,docs/目录下积累了 15 份文档:
代码块
JavaScript
这些文档不只是给人看的——每次新对话开始时,WorkBuddy 会读取相关的 PRD 和方案文档,确保 AI 对"这个产品要做什么"有清晰认知。
第三层: .workbuddy/memory/ — 跨对话记忆,让 AI 不"失忆"
Skills 解决了规范注入,PRD 解决了产品定义,但还有一个问题:每天做的事情太多,AI 需要记住"昨天做了什么、今天要接着做什么"。
WorkBuddy 的 Memory 系统正好解决了这个问题。项目目录下的 .workbuddy/memory/ 有两个核心文件:
代码块
Bash
.workbuddy/memory/
├── YYYY-MM-DD.md # 每日日志(每天追加)
└── MEMORY.md # 长期记忆(精简提炼)
每日日志:每次完成实质性工作后,WorkBuddy 会自动在当天日期的 md 文件中追加一条记录——做了什么事、改了什么文件、遇到了什么坑、做了什么决策。比如 Day 4 的日志里记录了 DeepSeek 模型名称的踩坑,Day 6 记录了 JWT 认证的实现细节。
长期记忆:MEMORY.md 是一个"精炼版"的项目记忆,只保存跨会话需要反复用到的信息——技术栈、接口规范、部署流程、踩坑记录、偏好约定。当日志积累超过 30 天,WorkBuddy 会自动提炼到 MEMORY.md 中。
这个系统的工作原理是:每次新对话开始,WorkBuddy 先读取 MEMORY.md 和最近几天的每日日志,把项目状态"装进脑子",然后再开始工作。
举个例子,Day 6 我要做 JWT 认证,WorkBuddy 从 MEMORY.md 中读到了:
•
项目用 Python FastAPI + PostgreSQL
•
接口统一返回 {code, msg, data}
•
之前 moods 接口的 user_id 还是硬编码的
有了这些上下文,我只需要说"实现 JWT 认证",WorkBuddy 就知道要在 FastAPI 框架下、用 PostgreSQL 存储用户、接口保持统一格式——不需要我重复解释技术栈。
到项目结束时,memory 文件夹里积累了7天的每日日志和一份不断更新的长期记忆,形成了完整的"项目知识库"。
54%
46%
三层体系的价值
回头看,Skills + PRD + Memory 这三层体系是 Vibe Coding 能跑通 7 天冲刺的关键基础设施:
#NrFxABRBveSL text{white-space:pre}.fb0{stroke:var(--N900-FG, 0.15)}.fx0{stroke-miterlimit:10}.fa1{fill:#bbbfc4}.fx1{font:normal 400 12px MonospacedNumber,LarkHackSafariFont,LarkEmojiFont,LarkChineseQuote,-apple-system,BlinkMacSystemFont,Helvetica Neue,Tahoma,PingFang SC,Microsoft Yahei,Arial,Hiragino Sans GB,sans-serif,Apple Color Emoji,Segoe UI Emoji,Segoe UI Symbol,Noto Color Emoji}.fx2{text-anchor:middle}.fx3{dominant-baseline:central}.fx4{stroke:none}.fc0{fill:var(--text-caption)}.fa2{fill:var(--text-link-disabled)}.fx5{font:700 normal 13px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"}.fx6{text-anchor:start}.fx7{dominant-baseline:alphabetic}.fc1{fill:rgb(0, 0, 0)}.fx8{font:400 normal 13px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"}.fx9{font:400 normal 13px LarkHackSafariFont, LarkEmojiFont, "monospace", -apple-system, BlinkMacSystemFont, "Helvetica Neue", Helvetica, "Noto Sans", Tahoma, "Nimbus Sans L", Arial, "Liberation Sans", "PingFang SC", "Hiragino Sans GB", "Noto Sans CJK SC", "Source Han Sans SC", "Source Han Sans CN", "Microsoft YaHei", "Wenquanyi Micro Hei", "WenQuanYi Zen Hei", STHeiti, SimHei, sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji", system-ui}.fb1{fill:var(--N900-FG, 0.15)}.fa3{fill:var(--bg-body)}ABC1234层级SkillsPRDMemory解决的问题注入时机()()()AI 不知道设计规范、代码风格AI 不知道产品要做什么AI 不记得昨天做了什么每次对话自动加载开发前手动引用每次对话自动读取.agents/skills/docs/.workbuddy/memory/
没有这套体系,7 天冲刺会变成"7 天解释项目"——每次新对话都要花半小时重新描述背景。
有了它,WorkBuddy 就像一个"有记忆的同事":每次回来,它已经知道项目在什么阶段、用了什么技术、有哪些坑要避开。我只需要告诉它"今天要做什么",它就能直接开工。
这也是我想分享给所有 Vibe Coding 实践者的第一条经验:在写第一行代码之前,先建好你的"AI 记忆系统"。
4.2 Day 3:情绪录入核心流程
Day 3 我开始做 MoodWave 最核心的入口:情绪录入。
如果情绪记录很麻烦,用户一定会放弃。所以我没有做一个长表单,而是让 WorkBuddy 按“5 步分步引导”生成页面:
"帮我实现 Mood Entry 页面,分成 5 步:情绪选择、强度滑块、多媒体输入、标签选择、AI 分析结果。每一步都有返回和下一步,状态保存在前端,最后提交到 POST /api/moods。"
生成后的流程是这样的:
情绪选择:happy、calm、anxious、angry、sad、neutral 六种情绪,每一种都有对应颜色
强度滑块:1-10 分,不只是数字变化,滑块颜色也跟着情绪渐变
多媒体输入:文字、图片、语音入口都保留;图片支持预览,语音先做“即将上线”的友好提示
标签选择:学习、工作、社交、情感、健康等标签,用来辅助后续分析
AI 分析结果:提交后展示摘要、关键词和音乐推荐,再引导进入音乐房间
这里有一个小细节我很喜欢:情绪强度不是冷冰冰的 range input,而是根据情绪色彩变化。开心是金橙,平静是丁香紫,焦虑是极光蓝。用户拖动滑块时,会感觉自己不是在填表,而是在调一段情绪波形。
Day 3 结束时,前端已经能完成从“我现在是什么感受”到“系统给我一个分析反馈”的闭环。虽然当时部分分析还是本地模板,但页面流程已经跑通,后端只要按接口补上真实数据即可。
4.3 Day 4:AI 接入 — DeepSeek SSE 流式对话
这是整个项目最核心的技术难点:如何让 WorkBuddy 帮我接入 AI 并实现流式响应?
第一步:设计 Prompt → 生成 AI Service
我对 WorkBuddy 说:
"用 openai 兼容 SDK 接入 DeepSeek API,实现两个功能:1) SSE 流式聊天 2) 结构化 JSON 情绪分析"
WorkBuddy 生成了 ai_service.py,核心实现:
代码块
Python
# backend/src/services/ai_service.py
from openai import AsyncOpenAI
client = AsyncOpenAI(
api_key=os.getenv("DEEPSEEK_API_KEY"),
base_url="https://api.deepseek.com"
)
第二步:创建 SSE 路由
"创建 POST /api/ai/chat,返回 SSE 流式响应"
WorkBuddy 用 FastAPI 的 StreamingResponse 实现:
代码块
Python
@router.post("/chat")
async def chat(request: ChatRequest):
return StreamingResponse(
stream_chat(messages=...),
media_type="text/event-stream",
headers={
"Cache-Control": "no-cache",
"Connection": "keep-alive",
"X-Accel-Buffering": "no" # Nginx 不缓冲
}
)
第三步:前端 SSE 对接
后端能流式返回之后,前端还要真的“逐字显示”,否则用户体感还是卡顿。
我继续让 WorkBuddy 处理前端:
"前端接入 /api/ai/chat,使用 fetch 读取 ReadableStream,实现 AI 回复逐字显示;加 AbortController,30 秒无响应就中断并给出温柔提示。"
WorkBuddy 生成的逻辑是:提交消息后先把用户输入放进对话列表,再读取 response.body.getReader(),用 TextDecoder 一段一段解码,把 AI 的回复追加到最后一条 assistant message 上。视觉上就是打字机效果。
50%
50%
这一步让我第一次感觉 MoodWave “活”了起来。不是页面里弹出一段静态建议,而是 AI 像一个正在回应你的伙伴,慢慢把话说完。
关键技术点:
•
response_format={"type": "json_object"} 是 DeepSeek 的结构化输出能力,不用自己写 JSON 解析
•
SSE 需要 X-Accel-Buffering: no 否则 Nginx 会缓冲导致"假卡顿"
•
前端用 AbortController 控制超时(30s),后端用 asyncio.wait_for(20s),严格前后对齐
4.4 Day 5:数据分析 + 解忧角+ Hermes Agent
Day 5 的前端重点是两个页面:Analytics 情绪分析中心,以及 Discovery 解忧角。
Analytics 页不是为了堆图表,而是让用户看见“我的情绪不是一团乱麻”。我让 WorkBuddy 按这条 Prompt 生成:
"实现情绪分析中心,包含月度情绪日历、情绪分布饼图、30 天趋势折线图、年度热力日历、AI 洞察卡片。图表用 Recharts,移动端可滑动,桌面端两列布局。"
最后页面分成几块:顶部是月度总结,中间是趋势折线和情绪占比,底部是GitHub风格的年度热力图。用户能看到最近 30 天是慢慢变平稳,还是某几天明显下坠。
Discovery 页我没有叫“社区广场”,而是叫“解忧角”。这个命名来自问卷里的一个重要反馈:用户希望有共鸣,但不想被传统论坛的信息流压住。所以页面设计成轻社交:
•
帖子可以匿名发布
•
分类包括全部、学习、情感、树洞
•
互动不是“攻击性评论”,而是抱抱、我懂你、给一点帮助
•
桌面端左栏固定,右侧帖子流滚动;移动端保持单列
第二轮打磨时,我专门清理了“接口不可用时使用本地数据”“当前显示 Mock 数据”这类文字,改成用户能理解的产品状态。对开发者来说这只是几个文案,但对用户来说,这是“原型”和“产品”的分界线。
Analytics 接口改造
"改造 analytics 接口,补全 weekly_trend、heatmap_data、AI insight 字段"
WorkBuddy 将原本的规则模板分析升级为真正的 AI 分析:
代码块
JavaScript
# GET /api/analytics/summary 现在会调用 DeepSeek
ai_result = await analyze_mood_with_ai(
text=f"用户近30天情绪记录:{recent_moods}",
Hermes Agent:数据采集 Agent
我还用 WorkBuddy 创建了一个数据采集 Agent Skill— moodwave-hermes:
代码块
JavaScript
我给 WorkBuddy 的指令:
"创建一个 Skill,让它能自动爬取小红书、微博、知乎上关于'考研焦虑'
'期末压力'等关键词的情绪帖子,分类存到 PostgreSQL"
WorkBuddy 生成了完整的 SKILL.md,包含:
- 爬取策略(关键词 + 平台 + 频率)
- 数据清洗规则
- PostgreSQL 存储结构
- 定时任务配置
这个 Agent 的意义在于:产品上线后可以持续抓取真实用户的情绪数据,为 AI 分析提供语料,让情绪雷达真正"活"起来。
4.5 Day 6:JWT认证 + UI 打磨 + PWA
Day 6 是最像“收拾房间”的一天。
功能大体跑通后,我发现页面里还有很多会让产品露馅的小问题:按钮点了没反应、用户名写死成“小鱼”、侧边栏图标风格不统一、Dashboard 里还出现 GET /api/moods 这种开发提示。于是我让 WorkBuddy 按 UI 打磨清单逐项修。
前端最重要的三个动作:
Profile 个人主页真实化
个人主页从 auth store 读取真实用户名和头像,不再硬编码。页面包含 MBTI、月度记录数、连续记录天数、主导情绪、快乐能量库、历史记录、心境清单。这个页面的作用不是展示“我有多少功能”,而是让用户觉得:这个 App 真的记得我。
清理假按钮和开发痕迹
我把 13 项假按钮和 15 处开发痕迹列成清单,让 WorkBuddy 逐个处理。不能实现的功能要给“即将上线”提示,能跳转的入口必须跳转,用户可见文字不能出现 API、Mock、接口预留。
PWA 与响应式适配
WorkBuddy 配置了 manifest.json、PWA 图标、移动端安全区和 iOS 添加到主屏幕的基础适配。响应式则重点检查 390px、768px、1440px 三个断点:手机端底部导航不截断,平板端卡片不拥挤,桌面端侧边栏固定。
Day 6 之后,MoodWave 才从“能跑的项目”变成“能拿给别人点一点的产品”。这个阶段没有 Day 4 接 AI 那么刺激,但非常决定观感。
81%
19%
JWT 认证全链路
这是 Day 6 最关键的工作。在此之前,所有接口的 user_id 都是硬编码的 1——没有真正的用户系统。
我给 WorkBuddy 的指令:
"实现完整的 JWT 认证:User 模型 + bcrypt 密码加密 + 注册/登录/me 接口,moods 和 posts 接口从 JWT 解析 user_id"
WorkBuddy 完成了:
User 模型扩展(email, username, hashed_password, mbti, avatar_character)
POST /api/auth/register — bcrypt 加密 + 数据校验
POST /api/auth/login — 密码验证 + JWT 签发(python-jose)
GET /api/auth/me — Token 解析 + 返回用户信息
路由守卫中间件 — 所有 moods/posts 接口从 request.state.user_id 读取用户身份
Profile 数据校准
"summary 接口新增 month_count、streak_days、dominant_mood、music_count、favorite_tags"
WorkBuddy 在 GET /api/analytics/summary 中补齐了 5 个 Profile 页需要的新字段,前端才能展示连贯的用户数据。
4.6 Day 7:腾讯云 Docker + CloudBase
Day 7 是整个7天冲刺的收官之战:把项目真正部署上线,让任何人可以通过 URL 访问。
部署 1:腾讯云 Docker 后端部署
Prompt → 部署
"用 Docker Compose 把后端部署到腾讯云轻量服务器 ,FastAPI + PostgreSQL + Nginx 三容器编排"
WorkBuddy 生成了完整的 docker-compose.yml 和 nginx.conf:
代码块
YAML
# docker-compose.yml
services:
db:
image: postgres:16-alpine
volumes:
【踩坑 1】Docker Build 失败:缺少 psycopg2
第一次 docker compose up --build 失败,报错 ModuleNotFoundError: No module named 'psycopg2'。
原因:requirements.txt 中只写了 sqlmodel,但没有显式包含 PostgreSQL 驱动。
解决:在 requirements.txt 中添加 psycopg2-binary==2.9.9,重新 build 成功。
【踩坑 2】Docker Hub 拉取超时
国内服务器 docker pull postgres:16-alpine 慢到怀疑人生。
解决:配置腾讯云镜像加速器 /etc/docker/daemon.json:
代码块
JavaScript
{
"registry-mirrors": ["https://mirror.ccs.tencentyun.com"\]
重启 Docker 后速度飞起。
【踩坑 3】PM2 双用户陷阱
服务器上前端进程用 PM2 守护,但我执行 pm2 list 显示空列表——以为进程没跑。
原因:PM2 daemon 是 root 用户启动的,ubuntu 用户看不到。
解决:所有 PM2 操作加 sudo:sudo pm2 list、sudo pm2 restart moodwave-frontend。
最终健康检查通过:
代码块
JavaScript
$ curl http://106.52.8.176:8000/api/health
{"status": "healthy"}
部署 2:CloudBase全栈部署
我对 WorkBuddy 说:
"帮我把整个 MoodWave 项目部署到 CloudBase,用 CloudRun 跑后端,静态托管跑前端"
【步骤 1】配置 CloudBase MCP
首先在 WorkBuddy 中配置 CloudBase MCP:
代码块
JSON
{
"mcpServers": {
"cloudbase": {
"command": "npx",
"args": ["@cloudbase/cloudbase-mcp"]
}
}
}
配置完成后,WorkBuddy 就能直接操作 CloudBase 环境。
【步骤 2】创建 CloudBase 环境
"在 CloudBase 创建一个新环境,区域选上海"
WorkBuddy 通过 MCP 自动创建:
•
环境 ID:moodwave-d1goq3vwib5df0121
•
区域:上海(ap-shanghai)
•
套餐:个人版
【步骤 3】CloudRun 部署后端
"用 CloudRun 部署后端,从 GitHub 仓库拉代码,用 Dockerfile 构建"
因为 CloudBase 个人版不支持 PostgreSQL,我让 WorkBuddy 生成一个"多合一"的 Dockerfile,把所有服务打包到一个容器:
代码块
SQL
CloudRun 配置:
•
部署方式:Git 部署
•
内存:4GB
•
CPU:2核
•
端口:80
50%
50%
【步骤 4】CloudRun部署前端
"把前端构建产物上传到 CloudRun云托管"
WorkBuddy 通过 MCP 自动:
在项目根目录执行 cd frontend && npm run build
将 .next/static 和 public/ 上传到云托管
【最终成果】
CloudBase 部署的独特价值:
•
Git Push 自动触发部署,不需要手动 ssh 到服务器
•
自带 HTTPS 证书和 CDN 加速
•
CloudRun的弹性伸缩让个人版也能应对小量并发
•
MCP 集成后,在 WorkBuddy 中"一句话完成部署"
五、WorkBuddy Skills 生态:让 AI 更懂你的项目
Vibe Coding 最大的痛点是什么?AI 不记得你的项目上下文。 每次新对话,AI 就像失忆了一样。
WorkBuddy 的 Skills 系统 解决了这个问题。我创建了 5 个 Skill,让 AI 始终保持对项目的理解:
Skill 的工作方式:
代码块
JavaScript
用户: "帮我改一下 Dashboard 的配色"
↓
WorkBuddy 自动加载 moodwave Skill
↓
Skill 告诉 AI:底色 #050505、毛玻璃 backdrop-blur(24px)、
情绪色 Happy=#FFD93D Calm=#9D84B7...
↓
AI 生成符合设计规范的代码
没有 Skill 的话,AI 会生成默认的蓝白配色,完全不符合项目风格。
我如何创建 Skill?
以 moodwave-onboarding 为例:
"我要为 MoodWave 设计新手指引,帮我研究最佳实践并创建一个 Skill"
WorkBuddy 自动搜索了 woshipm.com、UX Design Institute 2025 的研究,然后生成了一个 160 行的 SKILL.md,包含:
•
5 步引导流程设计
•
响应式断点规范
•
动画参数
•
边界条件处理
•
技术架构方案
之后每次讨论新手指引,AI 都从这个 Skill 读取上下文,保持一致性。
六、踩坑记录与避坑指南
7 天开发踩了不下 20 个坑。挑几个最有代表性的分享:
坑 1:DeepSeek 模型名称的"薛定谔存在"
问题:网上说 DeepSeek 最新模型叫 deepseek-chat,但官方文档说 deepseek-v4-pro 才是旗舰。
解决:以官方文档为准。deepseek-v4-pro 在 JSON 结构化输出、中文理解上都优于 deepseek-chat(后者即将弃用)。
教训:AI 模型选型不要信二手资料,直接看官方文档。
坑 2:SSE 流式响应"卡住"不动
问题:前端显示"AI 正在思考...",3-4 秒后突然一大段文字弹出来,而不是逐字流式输出。
根因:Nginx 默认会缓冲 upstream 响应,SSE 被 Nginx 攒够一定大小才发送。
解决:在 SSE 响应头加 X-Accel-Buffering: no,并在 nginx location 中加 proxy_buffering off;。
坑 3:?? 与 || 的微妙差异
问题:NEXT_PUBLIC_API_URL 环境变量在 CloudBase 部署时设为空字符串 "",但 process.env.NEXT_PUBLIC_API_URL ?? 'http://localhost:8000' 返回了空字符串而不是 fallback!
原因:??(空值合并)只在 null/undefined 时生效,空字符串 "" 是有效值。
解决:改用 ||(逻辑或),空字符串也会触发 fallback。
代码块
Plain Text
// ❌ 错误const API_URL = process.env.NEXT_PUBLIC_API_URL ?? 'http://localhost:8000'
// ✅ 正确const API_URL = process.env.NEXT_PUBLIC_API_URL || 'http://localhost:8000'
坑 4:前后端超时不对齐 = 无限转圈
问题:用户说"有时候点 AI 对话,页面一直转圈,等 2分钟都没反应"。
排查:后端 AI 调用设置了 60s 超时,但前端 AbortController 只设了 15s。15s 时前端中断请求,但后端的 TCP 连接可能还没断,导致用户体验"卡死"。
解决:前后端超时必须严格对齐。我们定了一个原则:
代码块
Bash
后端 timeout <
前端 timeoutSSE 流建立: 20s <
AbortController 30s
多模态分析: 20s×2=40s < axios 45s
坑 5:PM2 双用户陷阱
问题:服务器上 pm2 list 显示空,但网站明明在跑。
原因:PM2 daemon 是 root 启动的,ubuntu 用户 pm2 list 看不到 root 的进程。
解决:所有 PM2 命令加 sudo。部署脚本中写 sudo pm2 restart moodwave-frontend。
坑 6:新用户看到别人的数据
问题:新注册用户登录后,Dashboard 居然显示了情绪记录——但那不是他的数据!
原因:GET /api/analytics/summary 没有做 user_id 过滤,返回了全库聚合数据。
解决:所有 analytics 接口加入 WHERE user_id = ? 过滤。新用户看到的是真实的空状态,不是别人的隐私数据。
七、对话式开发 vs 传统开发 — 效率对比
核心差异不是"快多少",而是:
•
传统开发:需要记住所有技术细节,查文档、写代码、调试循环
•
Vibe Coding:描述需求 + 审查结果 + 迭代优化。人的角色从"执行者"变成"决策者"
这里我有一个很真实的感受:WorkBuddy 并不是把开发变成“点一下生成”。真正节省时间的地方,是它帮我减少了大量低价值切换。
以前写一个功能,我要在文档、编辑器、终端、浏览器之间来回切:查 SDK 用法,写封装,跑报错,搜错误,再改一轮。现在我更多是在描述产品意图:
"这个页面不要像后台,要像一个安静的情绪空间。"
"这里不要只返回一段文字,要返回 summary、keywords、suggestion,前端要能稳定解析。"
"CloudBase 个人版不支持 PostgreSQL,帮我设计一个能跑通比赛展示的替代部署方案。"
WorkBuddy 的价值就在于,它能把这些意图快速翻译成工程动作。但最后要不要接受、哪里需要重构、哪些功能先砍掉、哪个坑会影响上线,这些仍然要人来判断。
所以我的效率提升不是来自“少思考”,而是来自“把思考集中在更上层”。7 天里我没有被 CRUD、样式细节、Docker 模板拖死,而是能把精力放在:这个产品到底解决什么问题,哪些功能必须先完成,比赛展示时评委会先看到什么。
八、 心得体会与总结
做完 MoodWave,我对 Vibe Coding 的理解变了。
一开始我以为它的重点是“AI 帮我写代码”。但真正做完整个项目后,我发现更准确的说法是:AI 把人的角色从执行者推到了产品负责人、架构师和验收者的位置。
WorkBuddy 可以很快生成一个页面,但我要判断这个页面是不是符合问卷里“干净治愈”的需求;它可以生成 Docker Compose,但我要判断 PostgreSQL 是否持久化、Nginx 是否会缓冲 SSE;它可以帮我部署到 CloudBase。
这 7 天里,Skills 对我帮助最大。MoodWave 有自己的设计系统、产品语气、用户数据、部署限制,如果每次都重新解释,AI 很容易跑偏。把这些沉淀成 Skill 后,WorkBuddy 才能持续理解“这是 MoodWave”,而不是每次都从一个普通 Web App 开始猜。
CloudBase MCP 则让我第一次感受到,部署也可以变成对话式流程。以前部署像一段很脆弱的运维仪式:登录服务器、改配置、看日志、猜报错。现在我可以直接描述目标,让 WorkBuddy 帮我拆成 CloudRun、环境变量、域名访问几个步骤,再逐个验收。
当然,Vibe Coding 不是没有坑。AI 生成的代码一样会有超时不对齐、用户隔离遗漏、环境变量 fallback 错误。区别在于,发现问题后,我能用更快的循环修掉它。
最重要的心得:
Vibe Coding 让一个人的生产力接近一个团队。
7 天时间,一个大学生,几乎不从空白文件开始手写代码,
从 0 到上线交付了一个包含 AI 对话、音乐可视化、
数据分析和社区的完整产品。
这不是因为 AI 可以替人做所有决定,而是因为"对话式开发"
把人的精力从"怎么写"解放到了"做什么"。
从情绪雷达到腾讯问卷,再到 MoodWave 全栈开发和部署,这三篇文章刚好串起了我这个项目最完整的一条线:先用数据找到问题,再用问卷验证需求,最后用 WorkBuddy + CloudBase 把产品真正跑起来。
如果只能用一句话总结这次经历,那就是:
一个人也可以做出接近团队协作的速度,但前提是你要学会把想法说清楚,把上下文沉淀好,并且敢于对 AI 的结果负责
作者:用户872618791424
来源:稀土掘金 著作权归作者所有。