WorkBuddy 项目实操:AI Agent 亚马逊全链路自动化
一、基础环境搭建 WorkBuddy安装
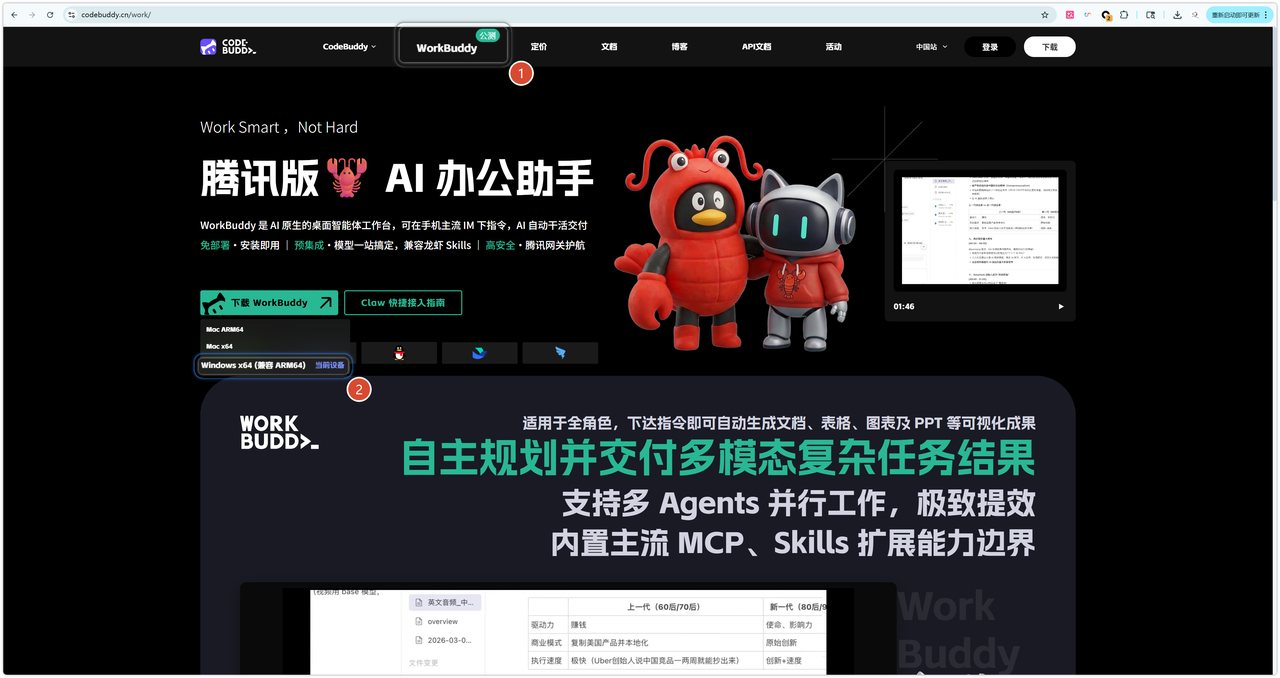
Windows下的安装步骤:
选择安装路径,默认装在C盘。C盘可用空间不多的,强烈建议改到D盘等非系统盘:
安装完成后桌面会生成WorkBuddy快捷方式:
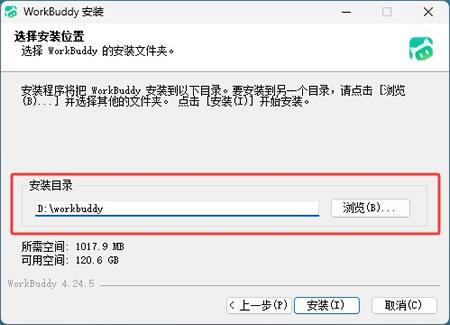
步骤二 选择安装路径
50%
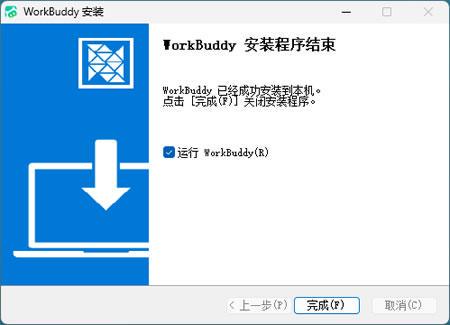
步骤三 创建快捷方式
50%
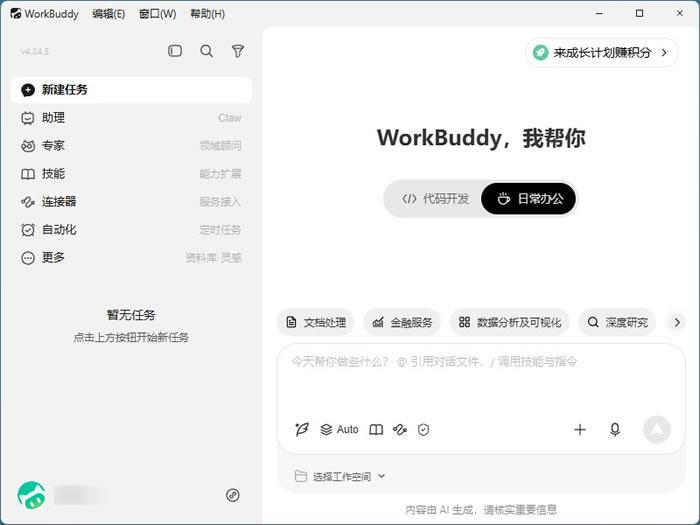
首次打开需要使用腾讯云或CodeBuddy账号登录。如果还没有账号,可以在登录界面点击注册,使用手机号或邮箱即可完成注册。
登录后进入主界面。左侧是任务列表和工作区,右侧是对话和任务执行区域。WorkBuddy会提供一些默认的任务模板,你可以直接使用也可以创建自己的任务。
59%
41%
⭕
Mac用户下载DMG文件后拖到Applications文件夹即可。不用额外配置,登录流程和Windows一致。Web用户直接打开浏览器访问官网,登录后就能使用全部功能。
二、数据接入 WorkBuddy重要配置
在正式开始使用之前,有几个关键的配置项建议先调整好,后面用起来会顺手很多。
1)修改工作空间存储路径
WorkBuddy生成的所有文件默认保存在系统盘的特定目录下。如果你C盘空间有限,或者想把AI生成的文件统一管理,建议修改工作空间路径。
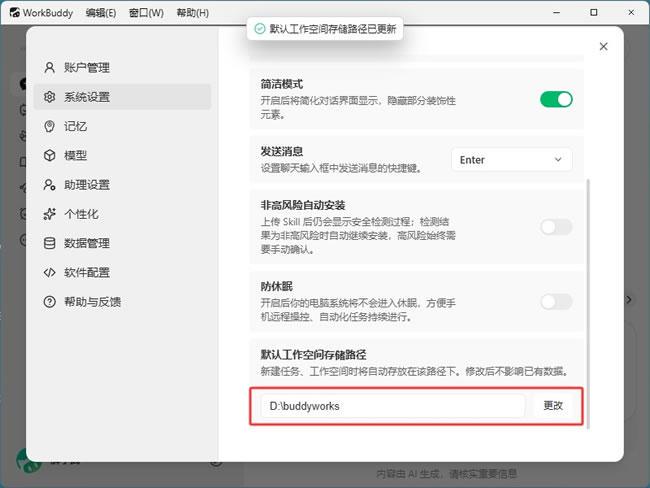
修改工作空间存储路径
50%
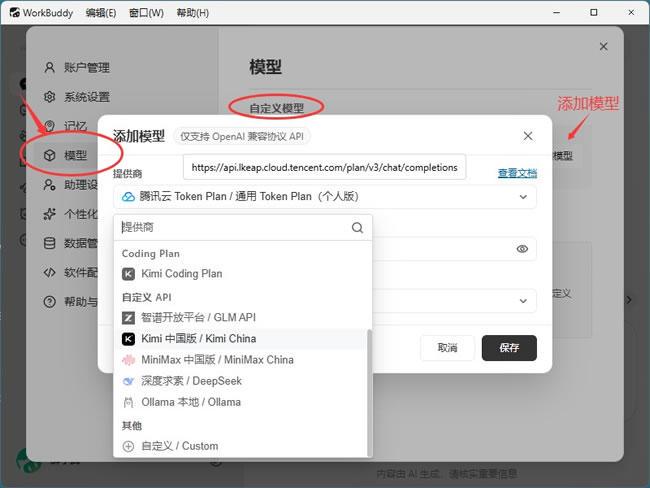
默认AI模型设置
50%
在软件左下角点击头像,菜单里选择设置进入设置页面,在系统设置页面最下方,参考下图修改存储路径。修改后所有新生成的文件都会保存在这个路径下,方便查找和备份。
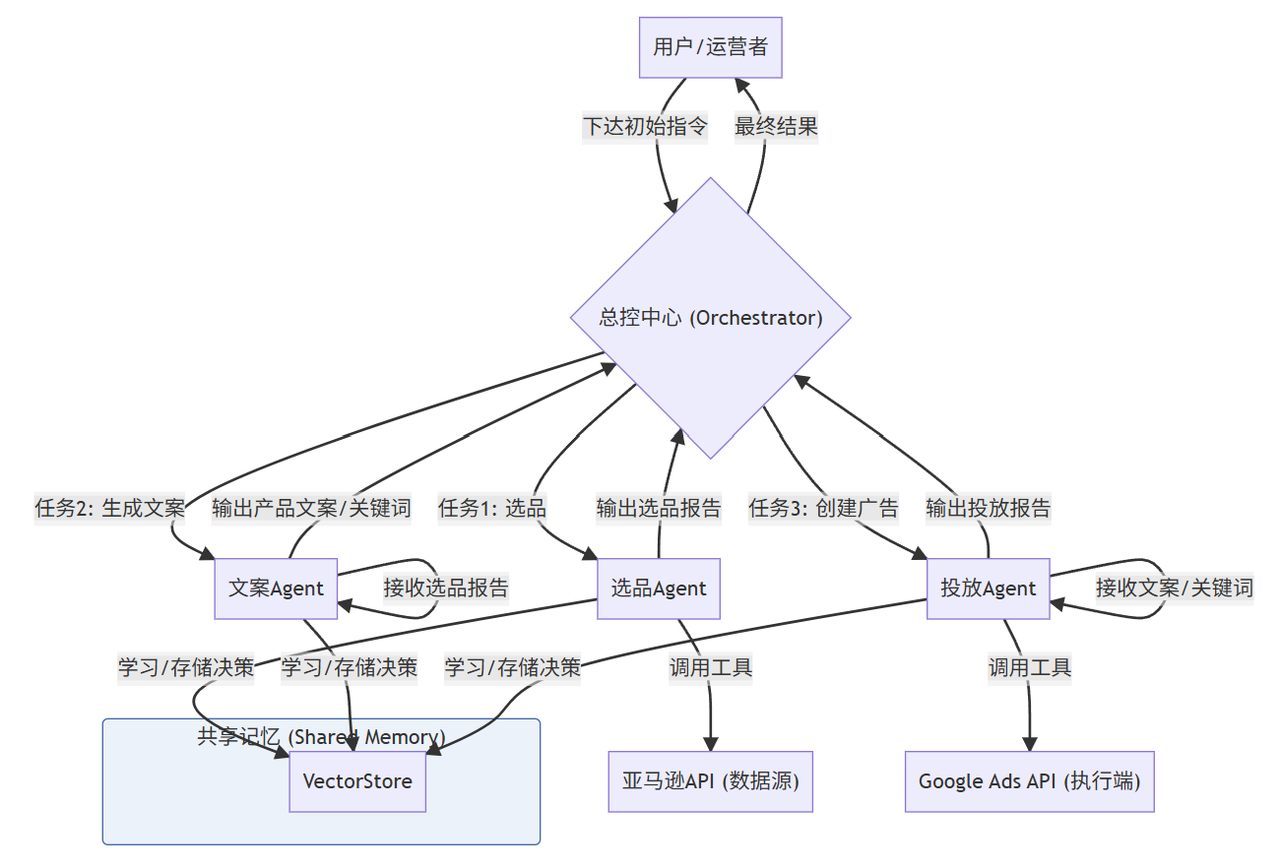
亚马逊多智能体系统架构
2)默认AI模型设置
WorkBuddy 支持 DeepSeek、Kimi、MiniMax 等多个 AI 模型。在设置页面的自定义模型里添加使用的模型:保持默认的"智能推荐"模式就行,WorkBuddy会根据任务特征自动选择最合适的模型。
3)整体架构预览
传统的跨境电商运营,极度依赖运营者的个人经验,我们称之为“老师傅模式”。
这种模式有其价值,但也存在明显的瓶颈:
⭕
选品:凭感觉,追爆款,风险高。 “老师傅”们或许能凭直觉嗅到爆款的气息,但这种直觉难以复制,且市场瞬息万变,一次失误就可能导致大量库存积压。
⭕
文案:套模板,同质化,难出彩。 为了提高效率,运营者往往会使用固定的文案模板。这导致大量商品描述千篇一律,无法在情感上打动目标客户,更难以在搜索引擎中脱颖而出。
⭕
投放:凭经验,调价格,易浪费。 广告投放是一门艺术,更是一门科学。“老师傅”通常根据过往经验调整关键词出价,但面对海量数据和实时变化的竞价环境,这种手动优化方式往往导致广告预算的严重浪费,投资回报率(ROI)极不稳定。
4)AI如何破局?从“聊天机器人”到“虚拟员工”
大语言模型的出现,为我们提供了全新的解决方案。但首先,我们需要刷新一个认知:AI远不止是一个能说会道的聊天机器人。我们要引入一个核心概念——智能体(Agent)。
🧠
一个Agent,可以被理解为一个“虚拟员工”。它具备三个核心能力:
大脑(Brain): 由大语言模型(如GPT-4o)驱动,赋予其思考、推理和规划的能力。
然而,一个再厉害的员工也无法包揽所有工作。公司的发展需要不同岗位的专家协同合作。于是,多智能体系统(Multi-Agent System)应运而生。它就像组建一个真正的团队,让多个拥有不同专业技能的Agent协同工作,自动化地完成一个复杂的业务流程。
📌 我们的目标
在本教程中,我们的目标非常明确:构建一个由“选品专家”、“文案大师”和“投放顾问”三个核心Agent组成的AI团队,实现从市场分析到广告上线的核心运营流程的全自动化。
5)系统蓝图:一图看懂我们的AI团队如何协作
为了更直观地理解这个系统,我们用一张架构图来展示它的全貌。
这张蓝图的解读:
•
用户 (你): 整个流程的起点。你扮演着“老板”的角色,只需要下达一个高层次的指令,比如:“帮我寻找一款适合在今年夏季美国市场销售的户外烧烤类新品。”
•
总控中心 (Orchestrator): 这是我们系统的“项目经理”。它会理解你的指令,并将其拆解成一个个具体的任务,然后按照预设的流程,依次分配给最合适的Agent去执行。
•
智能体团队 (Agents):
🧠
•
共享记忆 (Shared Memory): 这是我们团队的“知识库”和“经验库”。当接到新任务时,Agent会先来这里检索,看看历史上有没有类似的成功案例可以借鉴,从而让整个团队具备持续学习和进化的能力,而不是每次都从零开始。
通过这样的设计,我们就将一个复杂、依赖人工经验的运营流程,转化成了一个清晰、自动化、且具备学习能力的系统。
三、环境搭建与第一个“ 全链路自动 AI Agent ”
在这一部分,我们将像搭建工作室一样,准备好我们的开发环境,并与我们的第一个“智能体”进行初次对话。
3.1 准备你的“开发工作室”:环境安装
一个干净、独立的工作室是高效工作的保障。在编程世界里,这个“工作室”就是我们的“虚拟环境”。
第一步:确认你的Python版本
大模型生态系统主要围绕Python构建,因为它拥有海量的库和强大的社区支持,像“胶水”一样能把各种服务粘合在一起。
打开你的终端(在Windows上是命令提示符或PowerShell,在macOS/Linux上是Terminal),输入以下命令:
代码块
JavaScript
python --version
# 或者 python3 --version
第二步:创建并激活虚拟环境
在你的项目文件夹内(可以新建一个,比如 ecommerce_agent),打开终端,执行以下命令来创建虚拟环境:
代码块
JavaScript
# 这会在当前目录下创建一个名为 "venv" 的文件夹,里面存放着一个独立的Python解释器和包管理工具
python -m venv venv
创建成功后,你需要“走进去”开始使用这个独立的环境,这个过程叫做“激活”:
在 Windows 上:
代码块
JavaScript
venv\Scripts\activate
在 macOS 或 Linux 上:
代码块
JavaScript
source venv/bin/activate
激活成功后,你会发现终端命令行的前面出现了一个 (venv) 的标识。这告诉你,现在你所有的操作都将在这个独立的环境中进行。
第三步:安装核心依赖库
现在,我们的“工作室”已经准备就绪,可以开始搬入核心设备了。我们将安装三个关键的Python库。
LangChain: 它是我们构建智能体系统的“骨架”和“神经系统”。它本身不是一个大模型,而是一个开源框架,极大地简化了与大模型、外部工具和数据源的交互。它提供了标准化的接口,让我们不必从零开始造轮子。
代码块
JavaScript
pip install langchain
OpenAI: 这是OpenAI官方提供的Python开发包(SDK)。如果我们想和GPT系列模型(如GPT-4o)对话,就需要通过这个“官方语言包”来发送请求和接收回复。
代码块
JavaScript
pip install openai
langchain-openai: 这是LangChain专门为了与OpenAI模型集成而制作的适配包,提供了更顺畅的连接体验。
代码块
JavaScript
pip install langchain-openai
第四步:配置你的“钥匙” - 设置环境变量
临时设置(仅限当前终端会话):
•
在 macOS 或 Linux 上: export OPENAI_API_KEY="sk-..."
•
在 Windows PowerShell 上: $env:OPENAI_API_KEY="sk-..."
•
在 Windows CMD 上: set OPENAI_API_KEY="sk-..."
🧠
推荐做法(永久设置): 为了避免每次打开终端都要重新设置,建议将API Key配置为系统级的环境变量。具体方法可以搜索“你的操作系统 + 设置环境变量”。
3.2 第一个文件:让Agent听懂你的话
在你的项目文件夹 ecommerce_agent 中,创建一个名为 main.py 的文件,并输入以下代码:
代码块
Python
# main.py
import os
from langchain_openai import ChatOpenAI
代码逐行解析:
•
import os 和 from dotenv import load_dotenv; load_dotenv(): 这部分代码是为了更方便地管理我们的API Key。我们推荐你在项目根目录下创建一个名为 .env 的文件,把 OPENAI_API_KEY="sk-..." 写进去。python-dotenv 库会自动读取这个文件,并将其中的内容加载到环境变量中,省去了手动设置的麻烦。记得先用 pip install python-dotenv 安装它。
•
from langchain_openai import ChatOpenAI: 这行代码从我们安装的 langchain-openai 库中,导入了 ChatOpenAI 这个类。你可以把它理解为一个“连接器”,专门负责与OpenAI的聊天模型进行通信。
•
llm = ChatOpenAI(...): 这是整个程序的核心。我们创建了 ChatOpenAI 的一个实例,并命名为 llm (Large Language Model的缩写)。我们通过参数告诉它:我们要用 gpt-4o 模型,并且希望它的回答是严谨、确定的 (temperature=0)。
•
response = llm.invoke(...): 我们调用 invoke 方法,把我们的问题作为参数传递给模型。这一步,LangChain会将我们的请求打包,通过OpenAI的SDK发送到云端的大模型,然后等待回复。
•
print(response.content): 模型返回的是一个包含丰富信息的对象。我们最关心的文本内容存储在 .content 属性里,我们将它打印到终端。
现在,保存文件,确保你的虚拟环境已激活,并且API Key已设置好,然后在终端运行:
代码块
JavaScript
python main.py
如果一切顺利,你将会在终端看到类似这样的回复:
代码块
JavaScript
我是一个由OpenAI训练的大型语言模型。我能够理解和生成自然语言,可以回答问题、撰写文章、翻译语言、编写代码,并参与各种主题的对话。我的知识截止于特定日期,并且我没有个人经历或意识。我的目标是协助用户处理信息和完成基于语言的任务。
四、分工 - 打造各司其职的专家Agent
一个强大的大脑如果被关在“黑屋子”里,无法与外界互动,那它的能力将大打折扣。Agent的强大之处,就在于我们可以赋予它使用工具(Tools)的能力。在这一部分,我们将为我们的AI团队招聘三位专家:选品Agent、文案Agent和投放Agent,并为它们各自配备独特的工具和指令。
4.1 选品Agent:你的数据分析师
🔔
目标: 从海量商品中,基于数据而非直觉,找到潜力爆款。
所需工具: 要进行数据分析,首先得有数据。在真实世界中,我们会对接亚马逊的MWS或SP-API。
第一步:准备数据和工具
创建一个名为 data 的文件夹,在里面创建一个 amazon_products.csv 文件,内容如下:
代码块
JavaScript
ProductID,ProductName,Category,SalesLast30Days,Rating,ReviewsCount,CompetitionLevel
P001,Portable Espresso Maker,Kitchen,1200,4.8,2500,High
P002,Electric Gooseneck Kettle,Kitchen,850,4.9,4300,Medium
P003,Smart Mug Warmer,Office Gadgets,3000,4.6,7800,High
P004,Outdoor Propane Grill,Outdoor Living,500,4.7,1200,Low
P005,Smokeless Fire Pit,Outdoor Living,750,4.8,950,Medium
P006,Foldable Camping Table,Outdoor Living,1500,4.5,3100,High
在你的项目中创建一个新文件 tools.py,我们将在这里定义所有Agent可以使用的工具。
代码块
Python
# tools.py
代码解析:
•
import pandas as pd: 我们使用 pandas 库来方便地读取和处理CSV数据。请先执行 pip install pandas 安装它。
•
from langchain.tools import tool: 这是LangChain提供的“装饰器”,一个神奇的语法糖。
•
@tool: 只要在一个函数上方加上 @tool,LangChain就会自动把它识别为一个可供Agent调用的工具。LangChain会自动解析函数的名称、参数 (query: str) 和文档字符串 ("""..."""),让Agent明白这个工具是干什么用的(搜索产品)、怎么用(需要一个查询词)以及返回什么。这极大地简化了工具的定义过程。
第二步:构建选品Agent
现在,我们有了工具,接下来要创建一个使用这个工具的“专家”。我们将使用LangChain提供的标准Agent创建流程。修改你的 main.py 文件:
代码块
Python
代码解析:
Prompt模板: 这是整个Agent的灵魂。
"system", "...": 系统消息,用于给Agent设定一个全局的角色和行为准则。我们告诉它,它是一名“资深亚马逊选品专家”。
"human", "{input}": 人类消息,这里用 {input} 占位符来接收我们每次运行时输入的具体任务。
"placeholder", "{agent_scratchpad}": 这是一个特殊的占位符,用于存放Agent的“草稿纸”。Agent在决定最终答案前,会进行一系列的思考和工具调用,这些中间步骤都会记录在这里,帮助它进行下一步的推理。
create_tool_calling_agent: 这个函数将LLM、工具和Prompt“组装”在一起,形成一个具备完整思考能力的Agent。
AgentExecutor: 这是Agent的执行循环。verbose=True 是一个非常有用的参数,它会把Agent的完整思考过程打印出来,包括它决定调用哪个工具、传入什么参数、以及工具返回了什么结果。这对于我们调试和理解Agent的行为至关重要。
运行与验证:
现在运行 python main.py。因为设置了 verbose=True,你会在终端看到一长串的输出,这正是Agent的“内心独白”。它会显示:
•
Thought: Agent在思考它应该做什么。
•
Action: Agent决定调用 search_amazon_products 工具,并传入参数 outdoor living。
•
Observation: 工具执行后返回的CSV数据。
•
Thought: Agent分析了返回的数据,并开始组织最终的答案。
•
Final Answer: Agent给出的最终结论。
最终,你会看到类似这样的输出:
代码块
C++
----- FINAL RESULT -----
Based on the data for "Outdoor Living" products, I recommend considering the "Smokeless Fire Pit" (P005).
后续Agent的构建思路(文案Agent & 投放Agent)
4.2 文案Agent:你的金牌营销文案
🧠
•
目标: 将产品信息转化为吸引人的营销文案。
•
输入: 选品Agent输出的产品信息(例如,关于"Smokeless Fire Pit"的JSON或文本描述)。
•
工具: 通常不需要外部工具,它的主要任务是语言创作。但可以为其设计一个get_product_details的工具,用于从一个更详细的数据库中提取卖点。
核心Prompt:
代码块
JavaScript
"You are a top-tier e-commerce copywriter specializing in the AIDA model (Attention, Interest, Desire, Action). Based on the following product information: {product_details}, generate three distinct product titles (under 60 characters), one compelling product description (around 150 words), and five core search keywords. The copy should highlight the product's key benefits and resonate with the target market's culture."
4.3 投放Agent:你的数据驱动投手
•
目标: 基于产品文案和关键词,创建高效的广告活动。
•
输入: 文案Agent生成的标题、描述和关键词。
•
工具(模拟): 在tools.py中定义一个新工具:
代码块
Python
@tool
def create_google_ad_campaign(title: str, description: str, keywords: list[str]) -> str:
"""
Creates a mock Google Ads campaign.
It takes an ad title, description, and a list of keywords.
Returns a confirmation message with the campaign ID.
"""
print(f"--- Creating Google Ads Campaign ---")
print(f"Title: {title}")
print(f"Description: {description}")
print(f"Keywords: {keywords}")
campaign_id = f"Campaign_ID_{random.randint(1000, 9999)}"
return f"Successfully created Google Ads campaign with ID: {campaign_id}"
核心Prompt:
代码块
JavaScript
通过为每个Agent设定清晰的角色、目标和工具,我们就拥有了一个分工明确的专业团队。
五、协作 - 从“单打独斗”到“团队作战”
我们已经成功打造了三位各有所长的专家Agent。但是,一个真正的团队不是简单的成员相加,而是要能实现 1+1+1 > 3 的效果。要做到这一点,我们需要建立高效的协作机制和共享记忆。
5.1 协作机制:如何让Agent们“对话”
目前,我们需要手动运行选品Agent,复制其结果,再粘贴给文案Agent。这个过程既繁琐又低效。我们需要一个“总控中心”(Orchestrator)来自动完成任务的交接。在LangChain中,我们可以用LangGraph这个强大的库来构建复杂的、有状态的多智能体工作流。
第一步:定义工作流的状态
首先,我们需要定义一个数据结构,用于在整个团队中传递信息。它就像一个“项目文件夹”,每个Agent完成自己的工作后,都会把成果放进去。
代码块
Python
# graph_state.py
from typing import TypedDict, List
class GraphState(TypedDict):
"""
Represents the state of our graph.
Attributes:
initial_request: The initial user request.
product_research: The output from the product selection agent.
copywriting_result: The output from the copywriting agent.
campaign_result: The output from the ad campaign agent.
"""
initial_request: str
第二步:创建工作流节点(Node)
每个Agent的执行过程,都可以看作是工作流中的一个“节点”。
代码块
Python
# multi_agent_workflow.py (这是一个新的文件)
# ... (导入之前的Agent和工具) ...
def product_selection_node(state):
"""
The node for the product selection agent.
"""
print("--- NODE: PRODUCT SELECTION ---")
initial_request = state["initial_request"]
第三步:用LangGraph组装工作流
LangGraph允许我们像画流程图一样定义计算图。我们需要定义节点(Nodes)和边(Edges)。
代码块
Python
# multi_agent_workflow.py (续)
from langgraph.graph import StateGraph, END
# 1. 初始化工作流
workflow = StateGraph(GraphState)
现在,只需运行 python multi_agent_workflow.py,整个流程就会自动执行!选品Agent的结果会自动传递给文案Agent,文案Agent的结果再自动传递给投放Agent,实现了真正的自动化工作流。
协作时序图:
这个流程可以用下面的Mermaid时序图清晰地表示:
5.2 记忆共享:让团队拥有“集体智慧”
现在的团队虽然能协作,但他们是“健忘”的。每次接到新任务,都是一次全新的开始,无法从过去的成功或失败中学习。这就像一个每天都被清空记忆的团队。
为了解决这个问题,我们需要引入共享记忆机制,我们选择**向量数据库(VectorStore)**来实现。
概念解释:
向量数据库是什么? 它是一种特殊的数据库,不存储传统文本,而是存储文本的“数学表示”——向量(Embeddings)。
工作原理: 我们使用一个“嵌入模型”(Embedding Model)将文本(比如一段成功的文案)转换成一串数字(向量)。这个向量捕捉了文本的语义信息。当有新任务时,我们可以将新任务也转换成向量,然后在数据库中寻找“最相似”的向量,从而找到与当前任务最相关的历史经验。
实现步骤:
安装所需库: 我们使用FAISS,一个高效的本地向量搜索引擎。
代码块
JavaScript
pip install faiss-cpu langchain_community
创建记忆存储和检索工具:
在 tools.py 中添加:
代码块
Python
# tools.py (新增)
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAIEmbeddings
from langchain.docstore.document import Document
为Agent配备记忆工具:
现在,在创建每个Agent时,将 save_memory 和 retrieve_memory 添加到它们的工具列表中。
代码块
JavaScript
在Prompt中引导Agent使用记忆:
修改Agent的系统Prompt,鼓励它们使用记忆。例如,对选品Agent:
“You are a senior Amazon product selection expert… Before you start your analysis, use the retrieve_memory tool to see if there are any successful cases related to the current request. After you complete your analysis, use the save_memory tool to store your final recommendation and reasoning.”
六、实战演练与效果评估
理论和代码都已就位,是时候让我们的AI团队处理一个完整的真实世界任务了。
6.1 全流程演示案例
场景设定:
老板(你)下达了一个新的指令:“我想在美国市场销售一款便携式咖啡机,请帮我完成整个运营流程。”
运行 multi_agent_workflow.py,并输入指令。以下是整个流程的模拟输出:
Step 1: 选品Agent启动
代码块
YAML
--- NODE: PRODUCT SELECTION ---
> Entering new AgentExecutor chain...
I need to find a product related to 'portable coffee maker'. I will use the search_amazon_products tool.
Action: search_amazon_products
Action Input: {'query': 'coffee'}
... (工具返回了P001和P002的数据) ...
I see two coffee-related products. The 'Portable Espresso Maker' (P001) is a direct match. It has high sales (1200), a great rating (4.8), and a large number of reviews (2500). However, the competition is high. I should analyze this and provide a clear recommendation. I will also save this successful analysis to memory.
Action: save_memory
Action Input: {'memory_text': 'Analysis for portable coffee maker: Product P001 has high demand but also high competition. Recommended for sellers with a strong marketing budget to stand out.'}
Step 2: 文案Agent接收数据并执行
代码块
YAML
--- NODE: COPYWRITING ---
> Entering new AgentExecutor chain...
I have received a product recommendation for a 'Portable Espresso Maker'. My task is to create compelling copy. I will generate a title, description, and keywords.
... (Agent进行思考和创作) ...
Final Answer:
Here is the marketing copy for the Portable Espresso Maker:
**Titles:**
Step 3: 投放Agent接收文案并执行
代码块
SQL
--- NODE: AD CAMPAIGN ---
> Entering new AgentExecutor chain...
I need to create a Google Ads campaign based on the provided copy. I will use the create_google_ad_campaign tool with the first title and the keywords. I will also suggest a bidding strategy.
Action: create_google_ad_campaign
Action Input: {
'title': 'Portable Espresso Maker: Barista-Quality Coffee, Anywhere You Go',
'description': '...',
'keywords': ['Portable Espresso Maker', 'Travel Coffee Press', 'Manual Espresso Machine', 'Camping Coffee', 'Office Coffee Gadget']
}
--- Creating Google Ads Campaign ---
Title: Portable Espresso Maker: Barista-Quality Coffee, Anywhere You Go
...
整个流程无缝衔接,从一个模糊的需求,到一份可执行的广告方案,全部由AI团队自动化完成。
6.2 效果评估:AI团队 vs 人工运营
这个系统到底有多大价值?让我们通过一个简单的对比表格来量化评估。
🧠
结论: AI运营团队的价值远不止于“快”。它带来的是系统化、数据驱动、可规模化且能持续进化的运营新范式。它不是要取代人,而是要成为人类运营者的“超级外骨骼”,让我们能管理比以往多得多的店铺和产品,并做出更明智的决策。