项目一:WorkBuddy 构建AI知识库的系统方法
一个普遍现象:许多团队和个人在AI工具上的投入,与效率产出并不成正比。
🤔
很多团队在接到新任务时,流程依然是:打开搜索引擎 → 翻阅数十个收藏夹 → 在各种聊天窗口间反复横跳 → 从零开始拼凑方案。
即便有了能“联网搜索”的AI,它给出的答案也常常是泛泛而谈,因为它没有“上下文”——不知道你的业务边界、你的历史判断、你的成功与失败的案例。
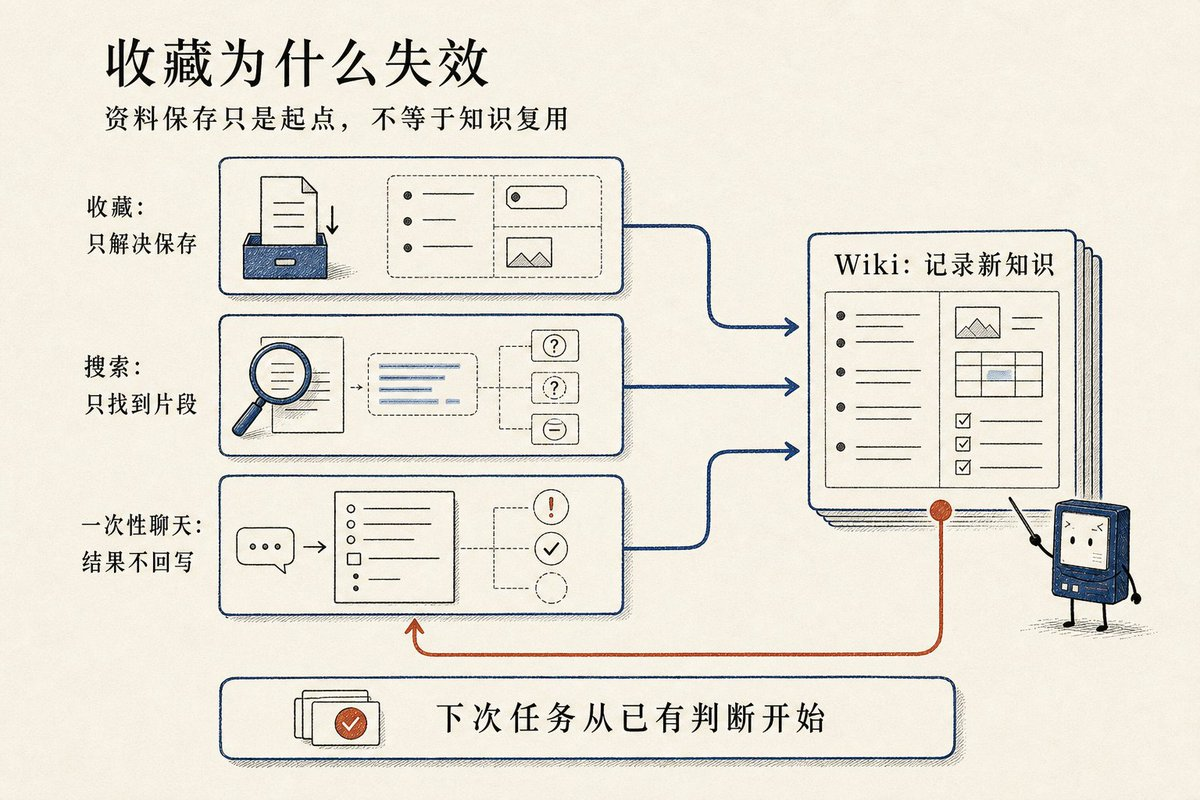
为什么你的“知识库”只是“高级回收站”?
在搭建任何系统之前,必须先诊断旧系统的死穴。传统的信息管理方式,在面对AI协作时,暴露了三个致命的结构性缺陷:
缺陷一:收藏等于“入库”,不等于“入料”
我们习惯把资料扔进文件夹或Notion,就像把矿石堆在仓库门口。但我们没有标记:这块“矿石”(文章)的纯度有多高(是事实还是观点)?它适合冶炼成什么产品(用于哪个工作环节)?它与其他矿石是共生还是冲突关系?AI面对一堆未经“选矿”的原材料,自然提炼不出高纯度的知识。
缺陷二:搜索能定位“关键词”,但无法判断“信用等级”
AI的RAG(检索增强生成)技术确实能从海量文件中找出包含“Prompt”的段落。但它无法区分,这段话是行业公认的基础原理,还是某个KOL为了卖课提出的偏激观点,亦或是你三个月前已经验证失败的内部教训。把所有信息都当作“平权”的事实去拼凑,是AI“一本正经胡说八道”的根源。
缺陷三:单次对话是一次性“外卖盒”,吃不完就扔
我们在与AI的深度对话中,常常会碰撞出绝佳的策略或优化后的SOP。但这些珍贵的产出,往往随着对话窗口的关闭而烟消云散。下一次,当你面对类似任务,AI还是那个什么都不懂的“新员工”,你们不得不重新磨合。
真正要解决的不是保存更多文件,而是让原始资料、人的判断和真实工作形成一个持续更新的系统。
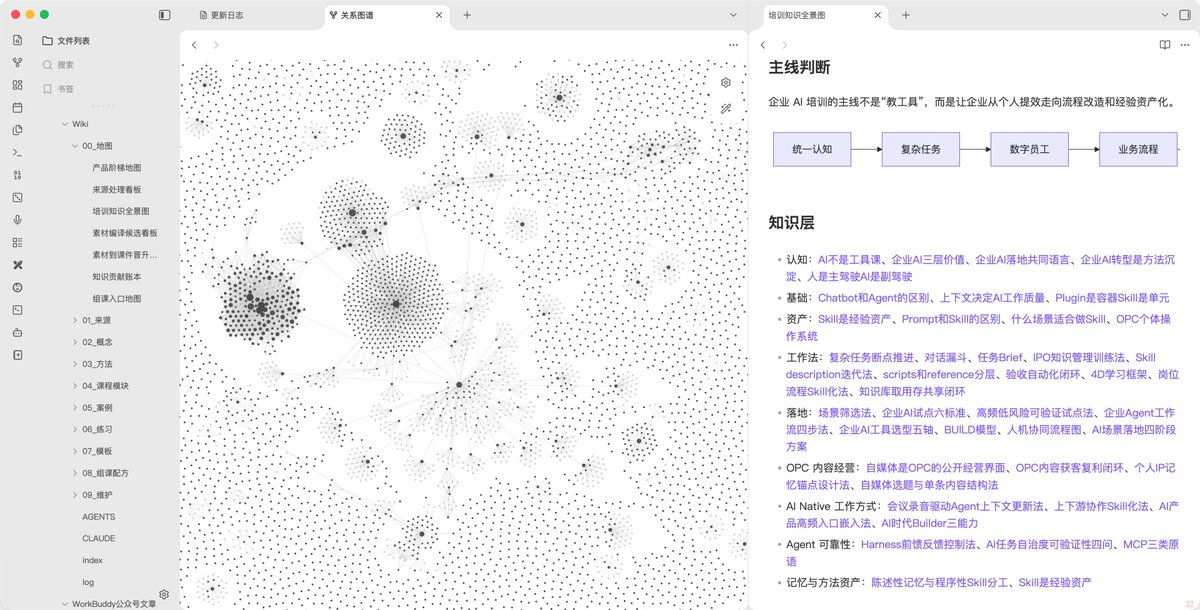
一、先定验收任务结构
在搭建Wiki前,必须设计两个“验收任务”。知识库不是为了“存”而存,而是为了“用”而建。
以搭建“企业AI应用培训”Wiki为例,设定个终极考验:
实战任务:为某传统行业的中层管理者,设计一门两小时AI落地入门课。
写作任务:把「为什么Skill比Prompt更值钱」扩展成一篇能区分作者主张与外部事实的文章。
这两个任务共同决定Wiki至少要能找到:课程判断、核心概念、落地方法、练习模板、写作素材、来源和知识缺口。比起「把AI培训知识全部整理完」,备课和写文章更能检验这些页面能不能组合成真实成果。
flow 定任务 → 定结构 → 处理材料 → 用任务验证
WorkBuddy的起点也很简单:一个独立目录、8份材料,以及一段自然派活。
代码块
JavaScript
这里有一批AI培训材料,还有一个方法参考。
我希望把它们整理成一个以后能支持企业AI培训备课的Wiki。
先不要建页面:先读材料,盘点类型、来源和风险,
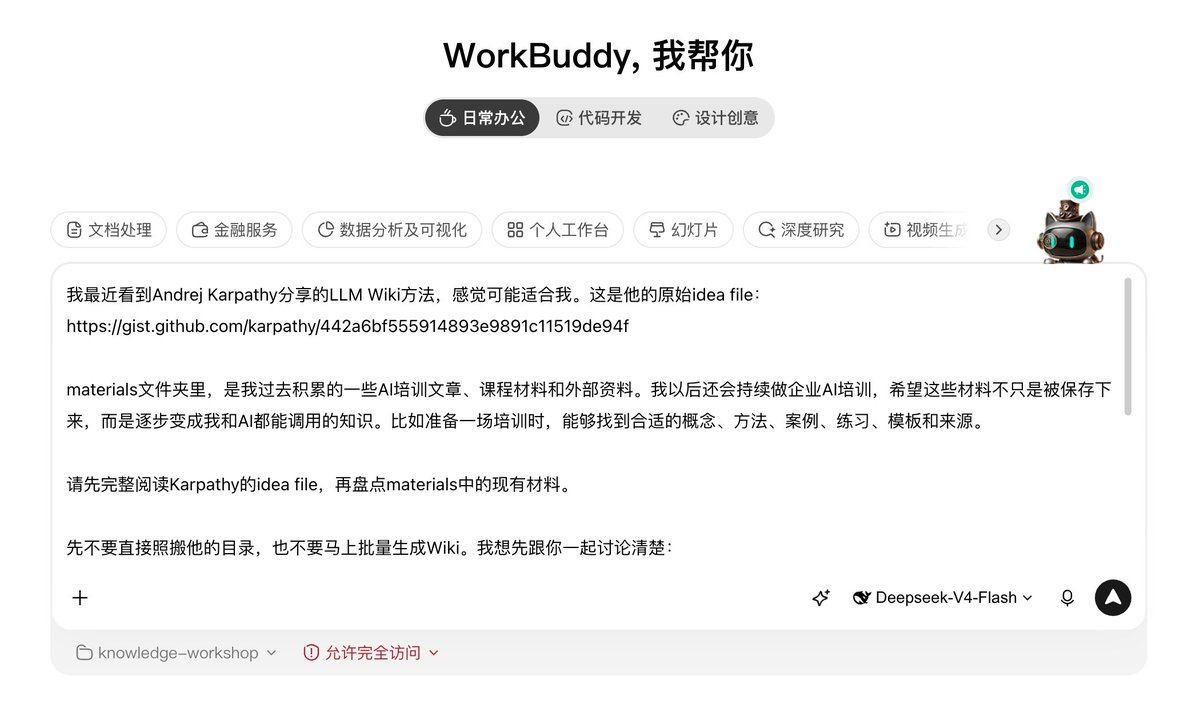
这个指令的核心在于:让AI先做“策划”,再做“执行”。它需要思考如何组织,而不是盲目地把文字填进页面。
✅
WorkBuddy先读方法原文和全部材料,没有立即创建文件,而是提出两项关键改造:
培训是生产导向,需要增加课程产出层;
材料混合了外部事实和作者主张,概念页与主张页必须分开。
59%
41%
这两个判断很关键。培训Wiki不是资料摘要库,它最终要产出课程和文章。同时,外部作者的观点不能混成我的判断,我的商业判断也不能被写成行业共识。
真正影响结构的三个问题,WorkBuddy交给我拍板:采用哪种分层、第一版处理多大范围、用什么任务验收。文件命名、页面链接和日常索引维护,则交给它推进。
二、了解 Wiki 的五层结构
这个最小Wiki有五个核心层,理解了它们,就不会把知识库做成文件夹工程。这套五层架构,是确保知识“可信、可用、可演进”的基石。
第一层:原始材料(保存证据)
这里是知识的“原始矿藏”。包括PDF、录音转写、网页存档、邮件记录等。原则是保持绝对纯净。不修改、不删减。哪怕是错误数据,也要保留其错误原貌。这是未来进行“事实核查”的唯一法律依据。
第二层:来源卡(材料的身份证和风险单)
来源页不是再写一遍摘要,而是回答:这份材料是谁、能不能信、有什么风险、能支持什么内容。
它记录标题、作者、平台、链接、获取日期、本地形态、转写工具、识别错误、时效风险、可支持的概念、待核验项和已拆出的页面。
这层最容易被省略,也最重要。没有来源卡,AI只知道「文字放在哪里」;有了来源卡,AI才知道「这份材料能不能信,可以怎么用,有哪些风险」。
✅
作用:当AI引用信息时,它能清楚地知道这句话的“置信度”有多高。没有来源卡的知识页,就像没有身份证的旅客,不应被允许登上“正式交付”的列车。
第三层:知识页(把材料编译成可复用知识)
这是Wiki的核心资产,将原材料“编译”成标准化的知识原子。关键原则是分类拆解:
•
概念页:定义“是什么”(公认客观事实)。
•
主张页:记录“谁怎么看”(带有强烈作者个人色彩的判断,需谨慎引用)。
•
方法页:沉淀“怎么做”(可复用的SOP、步骤清单)。
•
模板页:提供“用什么做”(可直接填写的空白表格)。
✅
概念和主张必须分开。「Prompt是用户或系统给模型的指令」可以进入概念页;「提示词工程热度下降」只能是外部作者观察,需要核验后才能长期使用。
方法页沉淀可重复的步骤和边界。模板页提供可以直接填写的结构,例如任务Brief、概念对比表、课堂练习单和输出检查表。
第四层:入口地图(告诉Agent先读哪里)
当Wiki超过50页,AI全量读取就会产生幻觉和注意力分散。入口地图相当于Wiki的“总指挥”。它告诉AI:
•
这个库里分为几大战区?
•
接到来任务,先去哪个战区找装备?
•
哪些是“已退役”的旧情报(不默认读取)?
•
如果在战区找不到,下一步该怎么扩大搜索范围?
Agent的读取路径是:
代码块
JavaScript
先读维护规则和入口地图
→ 定位相关知识页
→ 读取具体页面
→ 发现证据或执行缺口
Query不是闲聊,而是带着具体任务去知识库取料,再组装成课程、文章或方案。
第五层:交付物(保存一次具体工作的成果)
这里存放的是最终“产品”——产出的课程包、发布的文章、提交的方案。
⚠️注意:交付物不是知识本身,而是知识的“应用场景快照”。课程做完后,我们要从交付物里反推:哪个概念被验证有效?哪个案例被学员吐槽?将这些“实战反馈”提炼后,再回写到第三层(精炼层),完成闭环。
三、AI运行的第一步就犯错
在自动化构建过程中,最容易忽略也最致命的,是AI的“自动晋升”倾向。
案例:一次典型的“越权”事故
在第一批资料处理后,AI自动生成了13个知识页,并全部打上了“Live(正式可用)”的标签。但经过人工抽检,其中9个页面的来源追溯链是断裂的——它只是写了“来源见目录”,却没有指向具体的来源卡ID。
同一轮审计还发现,9个知识页的来源追溯链断裂:两个主张页写着「来源页待建」,6个模板只链接到sources/目录,方法页只有材料名称。
这揭示了「写了来源」和「真正可回查」的区别。链接到一个目录,只相当于说「证据在档案室里」;链接到具体来源页,才相当于给出了档案编号。
我确认问题后,要求WorkBuddy统一修正:13个内容页退回draft;补具体来源链接;把状态规则写进维护说明;所有变化记入日志。
这一步的价值不是修了几个文件,而是把一次返工变成规则:
代码块
Plain Text
新页面一律draft
→ 真实任务使用
→ 作者审核
→ 记录理由
核心原则:文件生成成功,仅代表“产出完成”;只有经过人机交叉验证,才代表“知识可用”。
四、检验 Wiki 的成果
建完页面后,不能说「页面生成成功」就算完成。第一个Query要回答:一个新Agent能否借助Wiki完成选择、裁剪和组装,而不是重新从原始材料写课。
我在一个新会话里只说明任务:
代码块
Plain Text
需要为传统企业零基础员工设计两小时入门课。
工作目录里有一个刚整理好的AI培训Wiki,
先讨论怎样利用它组织课程。
WorkBuddy先读入口和维护规则,再定向读取讲解方法、任务Brief、自检表、培训主张和试点方法等页面,没有从8份原始材料开始扫描。
它先提出四段结构:开场、建立认知、找到任务、实操收尾。
结构确认后,WorkBuddy先生成9个核心课程文件:课程总览、讲师脚本、两场演示脚本、WorkBuddy实操指引、任务扫描工作纸、三步Brief、自检表、任务卡和岗位示例任务库。
走查后又新增组课复盘和演示执行日志,形成11个课程文件。
这不是把Wiki页面连起来。WorkBuddy根据受众重新设计了知识形态:
•
5步叙事线只用前3步;
•
试点选择从5个条件简化成4个问题;
•
6字段任务Brief压缩为3步;
•
6项自检聚焦为3项;
•
30天试点改成一周行动卡。
知识形态
56%
限制条件
44%
五、定期监测,避免Wiki失控
页面增加以后,Wiki会出现和代码库相似的问题:重复、冲突、孤岛、失效链接、过时结论和规则漂移。
我保留一个定期Lint机制。Lint来自编程,可以把它理解成知识库体检报告:不改正文,只检查哪些页面没有入口、哪些结论缺来源、哪些说法冲突、哪些链接断了。
首次Lint覆盖当时Wiki的25个文件。总评没有严重问题,但发现2项需要作者判断、5项缺交叉引用、2项格式问题。我确认方向后,WorkBuddy完成全部9项修复。
关键不是发现了多少问题,而在两点:
回写后的知识库仍然可检查、可追溯;
Agent没有借机静默大改,每一处修复都先出现在报告里,等我确认。
六、让信息自己流进来:WorkBuddy来源雷达
到这里,还有一个问题没解决:企业AI培训的外部知识持续变化,新报告、新案例、新观点不断出现。靠我自己刷文章,既跟不上,也没有把判断力用在刀刃上。
第一轮试采,我要求WorkBuddy找最近两周对企业AI培训真正有价值的文章、观点和案例。
规则是:一手来源优先,去掉转载和低质量内容;每条记录标题、作者、链接、时间、培训价值和建议拆成的知识类型;结果放候选区,不直接建正式来源页。
它读入口和维护规则后发现,正式来源在sources/,但没有候选区。
它没有动sources/,而是新建inbox/,并在文件开头写明:这是候选区,未经审核不建正式来源页、不进目录索引。
普通网页搜索命中的多是新闻和二手转述,咨询报告、学术论文和深度调查很难搜到。
✅
WorkBuddy在技能市场找到两个扩展能力并实测:一个擅长学术、官方博客和深度调查;另一个接国内研报数据库,擅长咨询报告、白皮书和企业公告。
最终组合是:
三路搜索 → inbox候选区 → 人工审核 → 正式来源页
采集窗口也从两周放宽到一个月。原因是高质量机构报告的发布节奏慢于新闻,窗口太短,它们根本进不来。
随后,我把它配置成每周一早上九点自动运行的来源雷达:滚动看最近30天,结果只写inbox/,每次独立成文,运行记录追加到只增不改的日志表。
首跑三路搜索约36条,去重后8条进入一手强候选,4条留作线索,8条明确排除。此前跑过的候选全部被正确跳过,没有重复建卡。
最后我又验证了一个反直觉场景:找不到东西时,雷达会不会硬凑。
我把条件收窄到「过去24小时内发布的、关于用Wiki做企业知识管理的一手文章」。
三路搜索返回约13条,全部不合格:没有24小时内新发布;多是工具选型软文;唯一带日期的一条超出窗口两天。雷达输出空批次,逐条写明查了什么、为什么不合格,没有放宽标准。
写在最后
AI时代的知识库,不是替你保存更多文件,而是让原始资料、人的判断和真实工作形成一个可以持续更新的系统。
AI负责读长材料、生成草稿、建立链接、检查重复、维护索引和寻找缺口;人负责判断为什么保留这份材料、知识怎样拆、哪个来源可信、什么内容能晋升为稳定资产。
这套系统跑起来以后,培训任务来了,你不会再从空白文档开始,而是从已有判断、已有案例、已有模板和已有失败教训开始。
这才是知识库真正的价值。
这套系统的完整闭环:建库 → 用库 → 回写 → 体检 → 持续输入。人负责采信和边界,AI负责搜索、整理、执行和迭代。