Obsidian+WorkBuddy:从0到1搭建知识库完整教程
本文基于Karpathy公开的 LLM Wiki 知识库构建架构与核心方法论,结合Obsidian、WorkBuddy/Codex工具栈,落地一套可自主迭代、增量更新的自生长个人知识大脑系统。
一、LLM Wiki 核心定义与价值
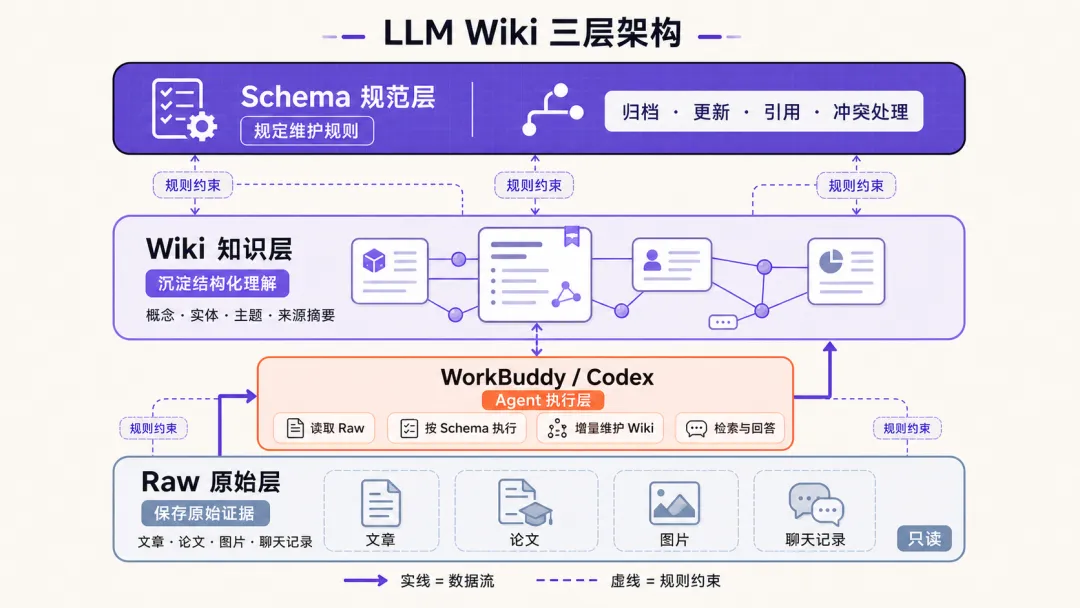
为实现知识管理的标准化、可控化、可迭代,整套系统采用分层架构设计,三层各司其职、相互协同,可根据个人使用场景自定义优化,标准通用架构如下:
✍️
•
Raw原始资料层:存储所有未经修改的原始素材,作为知识的唯一事实依据,仅可读、不可编辑改写,保证知识溯源的真实性;
✍️
•
Wiki结构化知识层:存储AI整理、提炼、关联后的标准化知识,包含概念、实体、主题、来源摘要等结构化内容,是知识库的核心服务层;
✍️
•
Schema规则规范层:定义AI的所有工作标准,涵盖资料归档、页面更新、知识引用、观点冲突处理、日志记录等全流程规则,保障AI运维行为标准化、可管控。
简单概括:Raw层留存原始证据、Wiki层沉淀认知体系、Schema层规范运维规则,三层架构协同实现知识的自动化、规范化生长。
二、核心工具选型逻辑与能力解析
2.1 Obsidian选型优势
本系统选用Obsidian作为核心存储与可视化载体,摒弃Notion、Ima、NotebookLM等工具,核心优势集中在数据自主、适配AI运维、知识关联能力强、生态可扩展四大维度:
✍️
•
完全本地化,数据自主可控:Obsidian的Vault仓库本质是本地文件夹,所有笔记以标准Markdown纯文本格式存储,不依赖平台私有数据库。所有私人资料(会议纪要、私密对话、个人笔记)均留存本地,同步权限、存储路径完全自主,可实现工具无缝迁移、知识永久留存。
✍️
•
适配AI Agent自动化运维:标准化的文件目录与文本格式,支持WorkBuddy/Codex直接读取目录、创建页面、修改双链、维护索引、生成版本记录,所有知识变更可精准定位,支持Git版本追溯。
✍️
•
天然具备知识关联能力:双链、反向链接、知识图谱功能,可自动串联概念、实体、主题、工具等知识节点,快速识别孤立知识、核心节点与潜在关联,助力体系化知识搭建。
✍️
•
插件生态高度可扩展:支持模板配置、数据查询、版本管理、可视化展示、一键发布等各类插件,可根据知识库迭代需求灵活拓展能力。
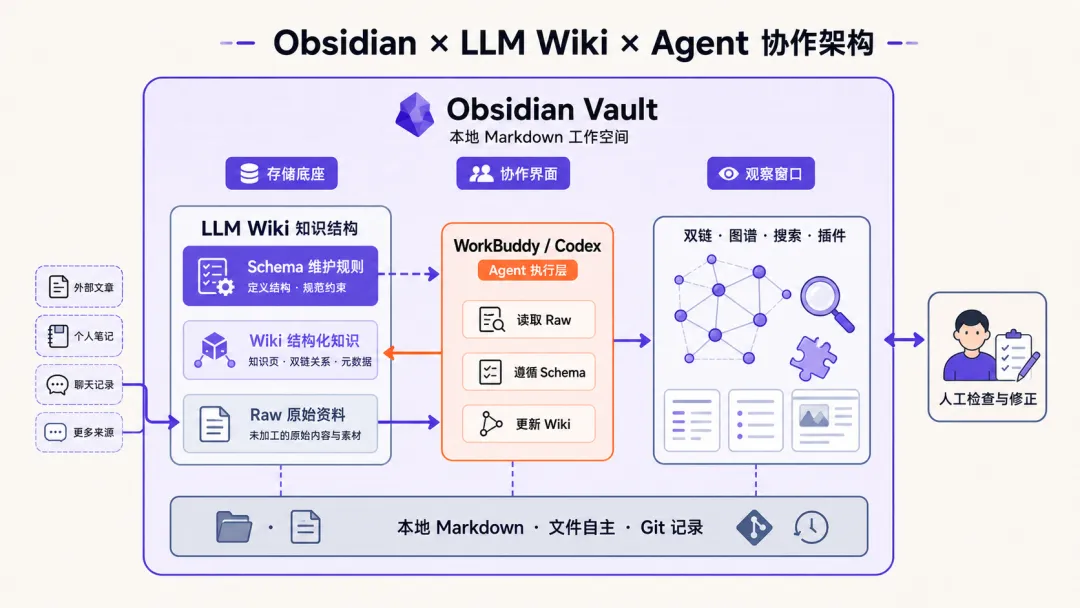
在整套系统中,Obsidian承担存储底座、人机交互界面、知识可视化窗口三重核心角色,是自生长知识库的基础载体。
2.2 WorkBuddy/Codex核心能力
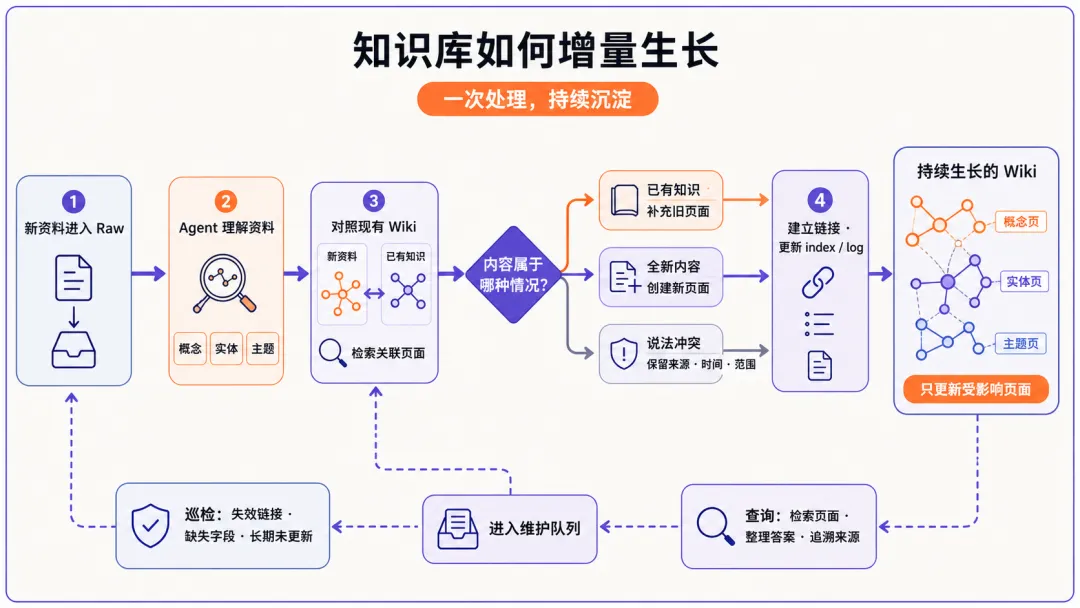
WorkBuddy与Codex作为系统的AI Agent执行层,可直接读取Obsidian Vault目录与Markdown文件,通过工具调用、指令编排、批量处理,严格遵循Schema规则完成全流程知识运维。
✍️
核心工作流程如下:
识别Raw层新增资料的核心概念、实体、主题信息;
检索比对Wiki层已有知识,判断增量补充或新建页面;
处理观点冲突,留存多维度信息及溯源依据;
自动建立知识双链、更新全局索引、追加变更日志;
日常维护失效链接检测、空缺字段补全、低频内容复盘、精准知识检索。
整套流程实现人机协作分工:人工负责制定规则、筛选高价值素材、关键知识校验;AI负责重复、高频、标准化的知识整理与运维工作,彻底解放手工整理成本。
三、系统环境准备与标准化目录架构
3.1 前置环境准备
安装Obsidian:官网免费下载,新建专属Vault仓库,访问插件市场时建议开启代理,保证插件正常加载;
41%
59%
备选增强工具:安装Obsidian WeSight插件,可大幅简化搭建流程,实现一站式知识大脑部署;
部署AI Agent工具:安装WorkBuddy或Codex;
配套工具:安装Obsidian Web Clipper浏览器插件,实现网页文章一键剪藏归档。
3.2 标准化目录架构
以下为通用成熟的LLM Wiki目录结构,用户可按需自定义调整:
代码块
Plain Text
📦 my-wiki/
├── AGENTS.md # Schema规范层:AI运维核心规则手册
├── index.md # 全局索引/站点地图:知识统一导航入口
├── log.md # 变更日志:仅追加记录,留存所有知识迭代记录
│
├── raw/ # 原始资料层(只读,禁止修改)
│ ├── articles/ # 网页剪藏、网络文章
│ ├── papers/ # 学术论文、行业报告
│ ├── books/ # 书籍原文、划线笔记、读书心得
│ ├── chats/ # 高价值AI对话记录
│ ├── notes/ # 个人灵感、碎片化随笔
│ └── meetings/ # 会议录音转写、会议纪要
│
└── wiki/ # 结构化知识层(AI全权增量维护)
├── sources/ # 来源摘要页:单份原始资料对应独立摘要页
四、三套落地搭建方案
结合实操经验,整理三套适配不同用户的搭建方案,上手难度从高到低排序,新手优先推荐第三种极简方案。
方案一:纯自定义提示词搭建法
4.1 方案特点
完全基于三层架构模板,通过自定义提示词驱动WorkBuddy/Codex完成全流程搭建,自由度最高,可深度适配个人知识管理需求,但需要用户理解架构逻辑,需持续迭代优化AGENTS.md规则。
4.2 实操步骤
打开WorkBuddy,选中新建的Obsidian Vault目录,进入「日常办公」场景;
输入以下初始化提示词,驱动Agent生成完整目录、规则与模板;
初始化搭建提示词:
代码块
Plain Text
你现在是这套个人知识库的搭建与维护 Agent。请在当前 Obsidian Vault 根目录中,搭建一套可长期增量维护的 LLM Wiki。
## 目标
建立 Raw、Wiki、Schema 三层结构:
- Raw 层保存原始资料,只允许读取,不修改原文。
- Wiki 层保存 AI 整理后的结构化知识,由 Agent 增量维护。
- Schema 层通过根目录下的 `AGENTS.md` 定义归档、更新、引用和冲突处理规则。
## 需要创建的结构
- `AGENTS.md`:Agent 的长期工作规范
- `index.md`:全局索引和知识导航入口
- `log.md`:变更日志,只追加新记录
- `raw/articles/`:文章和网页剪藏
- `raw/papers/`:论文和报告
- `raw/books/`:书籍、划线和读书笔记
- `raw/chats/`:有价值的 AI 对话
- `raw/notes/`:灵感与随手记录
- `raw/meetings/`:会议纪要与转写
初始化完成后,通过Obsidian Web Clipper将测试文章剪藏至raw/articles目录;
在WorkBuddy/Codex输入增量更新提示词,驱动AI完成知识结构化沉淀;
45%
55%
知识入库迭代提示词:
代码块
Plain Text
请读取 `raw/articles/` 中新增的文章,并严格按照 `AGENTS.md` 的规则增量维护 Wiki。
执行完成后,AI会自动生成来源摘要、概念、实体、主题等Wiki页面,完善知识双链与索引;
可基于沉淀后的Wiki知识库进行精准提问,AI将优先检索结构化知识,溯源原始资料,输出可验证、可追溯的回答。
55%
45%
✍️
方案优缺点:自由度极高、规则完全自定义,但需要用户具备一定工程理解能力,需持续优化提示词与规则。
方案二:Claude-Obsidian开源插件方案
4.3.1 方案特点
基于开源工程化项目claude-obsidian实现,已将LLM Wiki核心能力封装为标准化Agent技能,无需手动编写复杂提示词,支持一键初始化知识库、资料入库、自动索引、智能关联,大幅降低搭建门槛。
4.3.2 实操步骤
在WorkBuddy/Codex中安装claude-obsidian开源项目;
61%
39%
项目自动初始化当前Vault目录,生成标准化LLM Wiki三层架构;
新增资料后,调用ingest指令完成素材批量入库与Wiki更新;
48%
52%
知识检索时,调用retrieve指令即可精准调取知识库内容,Agent可自动命中结构化Wiki知识完成问答。
4.3.3 方案优缺点
✍️
无需自定义规则与提示词,工程化程度高,上手难度低于纯自定义方案;但核心操作仍依赖WorkBuddy/Codex指令调用,Obsidian仅承担存储与浏览功能,运维过程可视化程度低,新手仍有一定使用门槛。
方案三:WeSight知识大脑方案
4.4.1 方案特点
目前最轻量化、最丝滑的落地方案,将知识库初始化、资料入库、Wiki更新、智能检索、对话沉淀全流程整合至Obsidian内部,实现纯可视化操作、零指令编写、零复杂配置。
4.4.2 实操步骤
在Obsidian插件市场安装WeSight插件,开启「知识大脑」内测功能;
57%
43%
插件自动完成当前Vault的环境配置、目录初始化、规则部署,无需人工干预;
支持一键将任意Obsidian笔记、剪藏资料录入知识大脑,自动完成结构化归档与关联;
AI对话时选择「基于知识库」模式,系统自动检索Wiki结构化知识、追溯原始Raw资料、匹配知识双链,输出精准可溯源的回答;
支持一键保存Claude Code、Codex对话记录至知识库,实现对话知识的长效沉淀。
4.4.3 方案优缺点
上手门槛最低、全可视化操作、人机协作闭环完整;唯一限制为当前知识大脑功能处于会员内测阶段,暂未全面开放。
五、总结与落地建议
LLM Wiki自生长知识库的核心价值,是将传统「手工一次性知识整理」升级为「AI持续迭代的长效知识运维机制」。通过三层架构的标准化分工,让碎片化的文章、笔记、对话、灵感,逐步沉淀为结构化、可追溯、可复用、可进化的个人知识资产。
新手落地建议:无需追求一步到位搭建完美系统,优先完成基础三层目录搭建,录入首批测试素材,验证AI增量更新流程。后续根据使用场景持续优化Schema规则、丰富知识素材,循序渐进迭代个人专属知识大脑。