卷积神经网络
一、概述
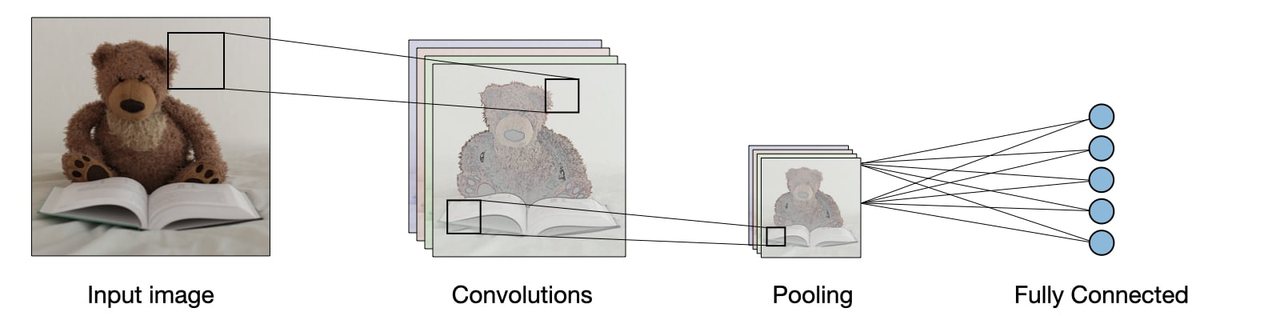
传统 CNN 的架构:
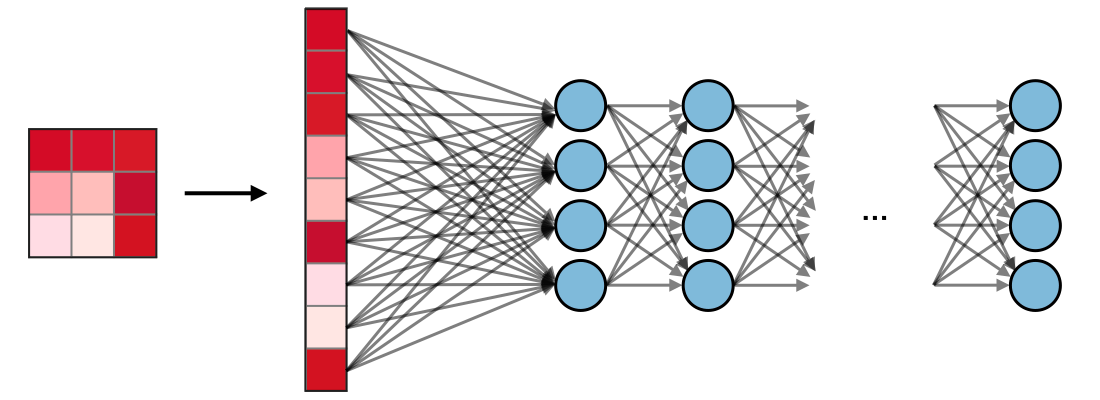
卷积神经网络(也称为 CNN)是一种特定类型的神经网络,通常由以下层组成:输入图像 -> 卷积 -> 池化 -> 全连接。卷积层和池化层可以根据下一节中描述的超参数进行微调。
二、层的类型
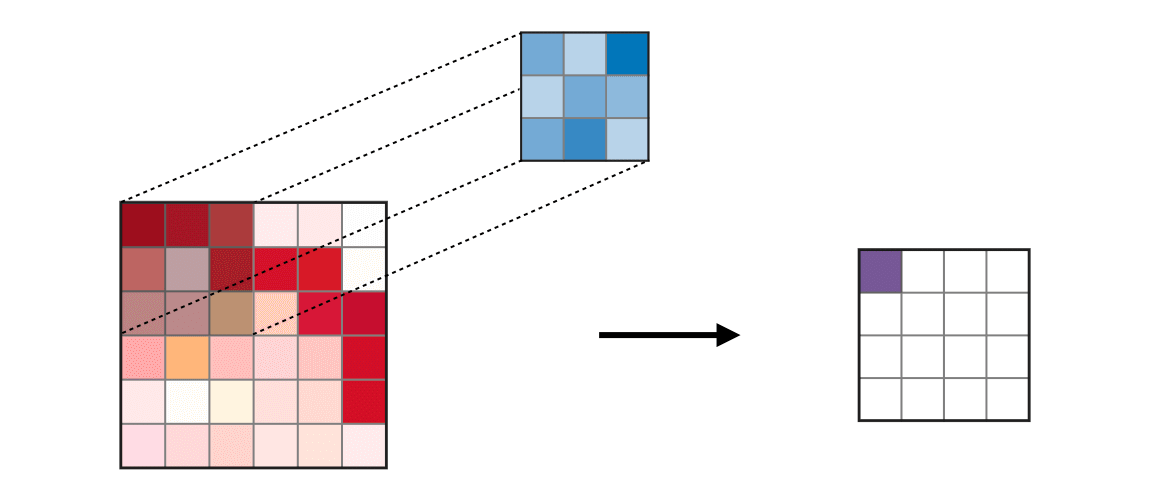
卷积层 (CONV):卷积层(CONV)使用滤波器执行卷积操作,它根据输入的维度扫描输入 。其超参数包括滤波器大小 和步长 。产生的输出 称为特征图或激活图。
备注:卷积步骤也可以推广到 1D 和 3D 情况。
池化层 (POOL):池化层(POOL)是一种下采样操作,通常应用在卷积层之后,它具有一定的空间不变性。特别是,最大池化和平均池化是特殊的池化类型,分别取最大值和平均值。
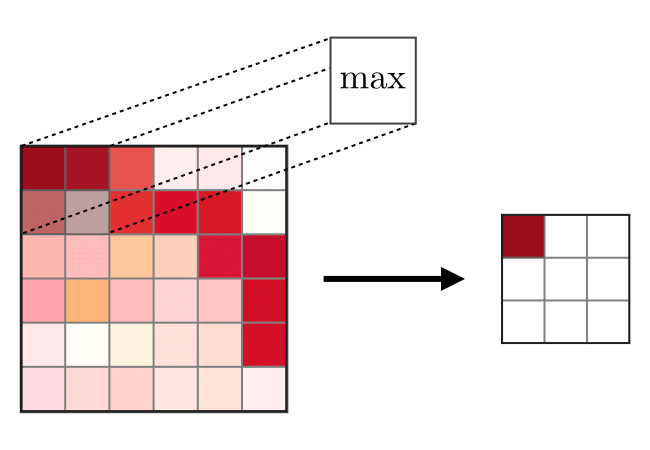
最大池化
50%
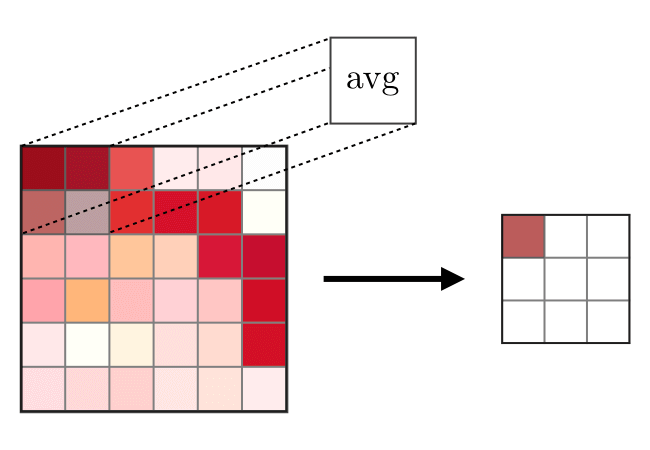
平均池化
50%
| | |
| | |
| | |
全连接层 (FC):全连接层(FC)在展平的输入上操作,其中每个输入都连接到所有神经元。如果存在全连接层,通常出现在 CNN 架构的末端,可用于优化类别分数等目标。
三、滤波器超参数
卷积层包含滤波器,了解其超参数的含义非常重要。
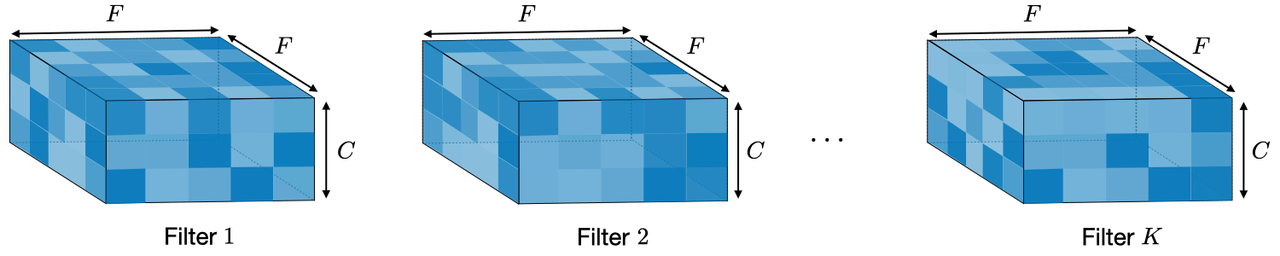
滤波器的维度:一个大小为 的滤波器应用于包含 个通道的输入时,是一个 的体积,它对大小为 的输入执行卷积,并产生大小为 的输出特征图(也称为激活图)。
备注:应用 个大小为 的滤波器会产生大小为 的输出特征图。
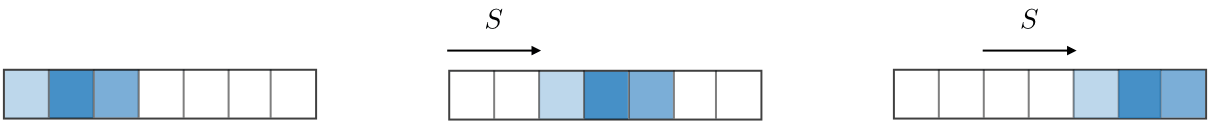
步长:对于卷积或池化操作,步长
S
表示每次操作后窗口移动的像素数。
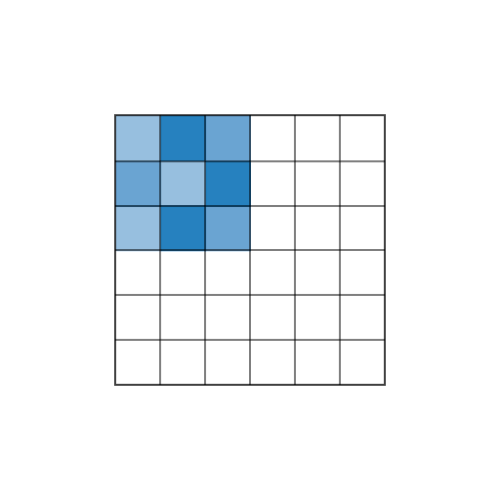
零填充:零填充是指在输入边界的两侧添加 个零的过程。该值可以手动指定,也可以通过以下三种模式之一自动设置:
| | | |
| | | |
| | | |
Valid
33%
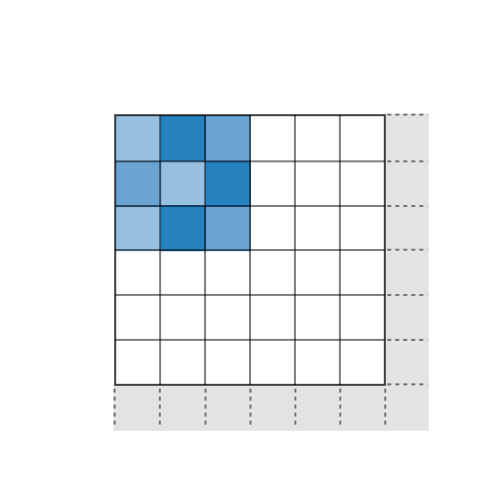
Same
33%
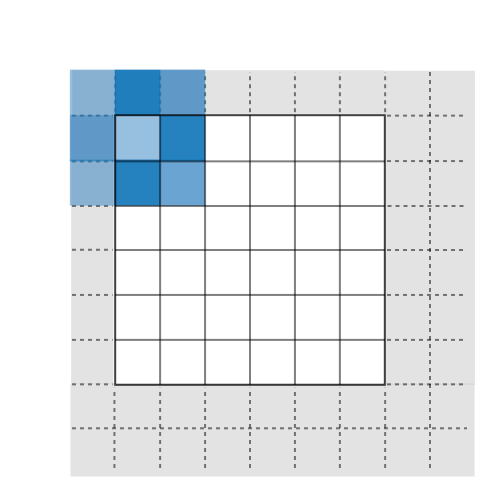
Full
33%
四、调整超参数
卷积层中的参数兼容性:记 为输入体积长度的尺寸,为滤波器长度,为零填充量,为步长,则沿该维度的特征图输出大小 由下式给出:
备注:通常 ,在这种情况下,我们可以将上式中的 替换为 。
理解模型的复杂度:为了评估模型的复杂度,确定其架构将拥有的参数数量通常很有用。在卷积神经网络的给定层中,其计算方式如下:
| | | |
| | | |
| | | |
| | | |
| | | |
感受野:第 层的感受野是第 个激活图的每个像素可以“看到”的输入区域,记为 。
记 为第 层的滤波器大小,为第 层的步长值,并约定 ,则第 层的感受野可以用以下公式计算:
在下面的例子中,我们有
F1=F2=3
且
S1=S2=1
,这给出
R2=1+2⋅1+2⋅1=5
。
五、常用的激活函数
修正线性单元:修正线性单元层(ReLU)是一种激活函数
g
,应用于体积的所有元素。它旨在为网络引入非线性。其变体总结在下表中:
ReLU
33%
Leaky ReLU
33%
ELU
33%
| | |
| | |
| | |
Softmax:Softmax 步骤可以看作是一种广义的逻辑函数,它在架构末端接收一个分数向量
x∈Rn
作为输入,并通过 softmax 函数输出一个输出概率向量
p∈Rn
。其定义如下:
六、目标检测
模型类型:主要有 3 种类型的目标识别算法,它们预测的性质不同。下表描述了它们:
| | |
| | |
| | |
| | |
检测:在目标检测的背景下,根据我们只是想定位目标还是检测图像中更复杂的形状,会使用不同的方法。下表总结了两种主要方法:
| |
| |
| |
| |
交并比:交并比(IoU)是一个函数,用于量化预测边界框
Bp
相对于实际边界框
Ba
的定位正确程度。其定义为:
备注:我们始终有
IoU∈[0,1]
。按照惯例,如果
IoU(Bp,Ba)⩾0.5
,则预测边界框
Bp
被认为是相当好的。
锚框:锚框是一种用于预测重叠边界框的技术。在实践中,允许网络同时预测多个框,其中每个框的预测被约束为具有给定的一组几何属性。例如,第一个预测可能是一个给定形状的矩形框,而第二个将是另一个不同几何形状的矩形框。
非极大值抑制:非极大值抑制技术旨在通过选择最具代表性的边界框来移除同一目标的重复重叠边界框。在移除所有概率预测低于 0.6 的框后,在还有框剩余的情况下重复以下步骤:
对于给定类别,
• 步骤 1:选择预测概率最大的框。
• 步骤 2:丢弃任何与前一个框的
IoU⩾0.5
的框。
YOLO:You Only Look Once (YOLO) 是一种目标检测算法,执行以下步骤:
• 步骤 1:将输入图像划分为
G×G
的网格。
• 步骤 2:对于每个网格单元,运行一个 CNN,预测以下形式的
y
:
其中 是检测到目标的概率,是检测到的边界框的属性,是检测到的 个类别中哪一个的独热表示,是锚框的数量。
• 步骤 3:运行非极大值抑制算法以移除任何潜在的重复重叠边界框。
备注:当 时,网络不检测任何目标。在这种情况下,相应的预测 必须被忽略。
R-CNN:区域卷积神经网络(R-CNN)是一种目标检测算法,它首先对图像进行分割以找到潜在的相关边界框,然后运行检测算法以在这些边界框中找到最可能的目标。
备注:尽管原始算法计算量大且速度慢,但较新的架构使该算法运行得更快,例如 Fast R-CNN 和 Faster R-CNN。
七、人脸验证与识别
模型类型:下表总结了两种主要类型的模型:
| |
| |
附件不支持打印 | 附件不支持打印 |
单样本学习:单样本学习是一种人脸验证算法,它使用有限的训练集来学习一个相似度函数,该函数量化两个给定图像有多不同。应用于两个图像的相似度函数通常记为
d(图像1,图像2)
。
孪生网络:孪生网络旨在学习如何编码图像,然后量化两个图像有多不同。对于给定的输入图像
x(i)
,编码输出通常记为
f(x(i))
。
三元组损失:三元组损失
ℓ
是在一组三元组图像
A
(锚点)、
P
(正例)和
N
(负例)的嵌入表示上计算的损失函数。锚点和正例属于同一类别,而负例属于另一类别。记
α∈R+
为边界参数,该损失定义如下:
50%
50%
八、神经风格迁移
动机:神经风格迁移的目标是基于给定的内容
C
和给定的风格
S
生成图像
G
。
激活:在给定层
l
中,激活记为
a[l]
,其维度为
nH×nW×nC
。
内容代价函数:内容代价函数
Jcontent(C,G)
用于确定生成图像
G
与原始内容图像
C
的差异程度。其定义如下:
风格矩阵:给定层
l
的风格矩阵
G[l]
是一个格拉姆矩阵,其中每个元素
Gkk′[l]
量化通道
k
和
k′
的相关程度。它相对于激活
a[l]
定义如下:
备注:风格图像和生成图像的风格矩阵分别记为 和 。
风格代价函数:风格代价函数 用于确定生成图像 与风格 的差异程度。其定义如下:
总体代价函数:总体代价函数定义为内容代价函数和风格代价函数的组合,由参数 加权,如下所示:
备注:较高的
α
值会使模型更关注内容,而较高的
β
值会使它更关注风格。
九、使用计算技巧的架构
生成对抗网络:生成对抗网络(GAN)由生成模型和判别模型组成,其中生成模型旨在生成最真实的输出,该输出将被馈送到判别模型中,判别模型旨在区分生成图像和真实图像。
备注:使用 GAN 变体的用例包括文本到图像、音乐生成和合成。
ResNet:残差网络架构(也称为 ResNet)使用具有大量层的残差块,旨在减少训练误差。残差块具有以下特征方程:
Inception 网络:该架构使用 Inception 模块,旨在尝试不同的卷积,通过特征多样化来提高其性能。特别是,它使用 卷积技巧来限制计算负担。