基于状态的模型
搜索优化
在本节中,我们假设通过从状态执行动作,我们确定性地到达状态。这里的目标是确定一个动作序列,它从初始状态开始并导向结束状态。为了解决这类问题,我们的目标将是使用基于状态的模型来找到最小代价路径。
树搜索
这类基于状态的算法探索所有可能的状态和动作。它具有相当高的内存效率,适用于巨大的状态空间,但在最坏情况下运行时间可能变为指数级。
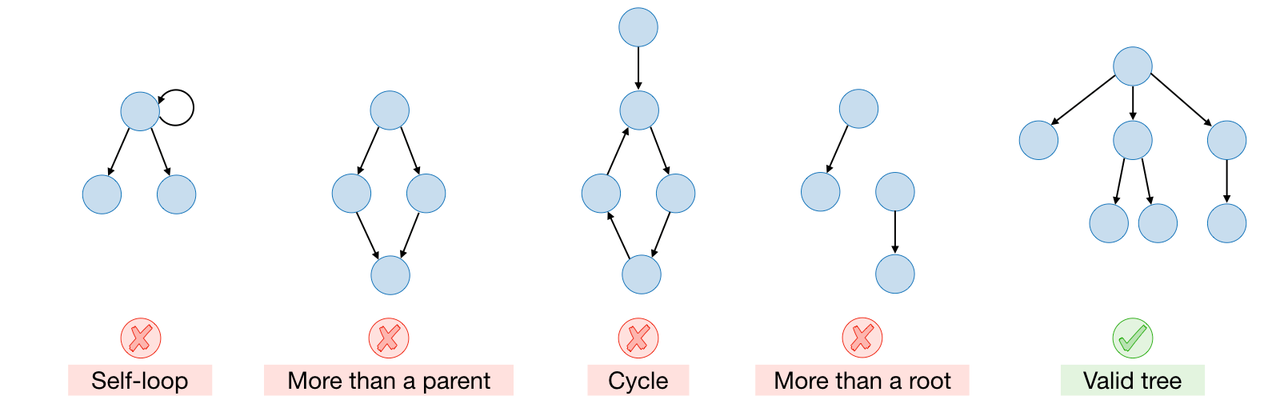
搜索问题 搜索问题定义如下:
•
起始状态
•
从状态出发的可能动作
•
从状态执行动作的动作代价
•
状态执行动作后的后继状态
•
是否到达结束状态
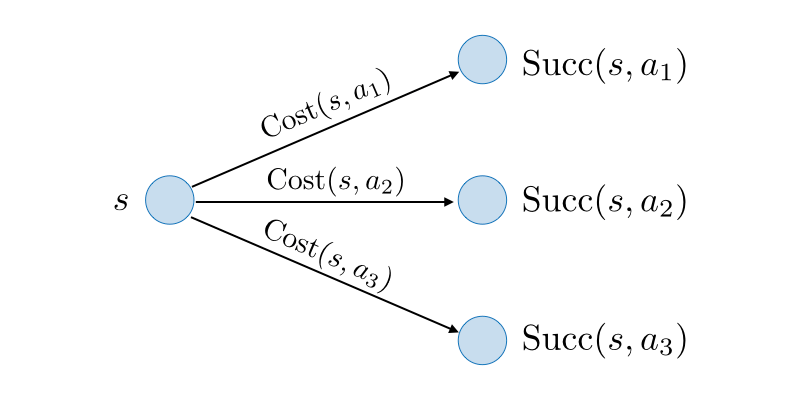
目标是找到一条使代价最小的路径。
广度优先搜索(BFS) 广度优先搜索是一种图搜索算法,进行逐层遍历。我们可以借助一个队列迭代地实现它,该队列在每一步存储将要访问的未来节点。对于该算法,我们可以假设动作代价等于常数 。
回溯搜索 回溯搜索是一种朴素的递归算法,尝试所有可能性以找到最小代价路径。在这里,动作代价可以是正数或负数。
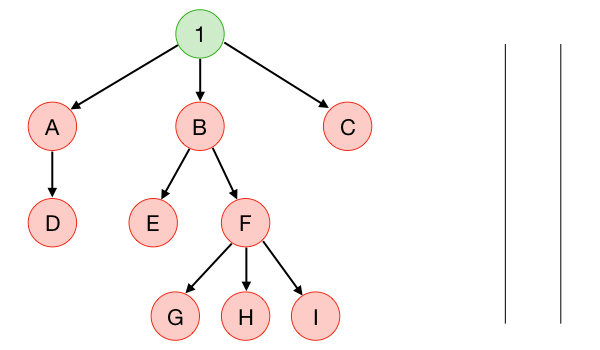
深度优先搜索(DFS) 深度优先搜索是一种搜索算法,通过尽可能深入地沿着每条路径遍历图。我们可以递归地实现它,或者借助一个栈迭代地实现,该栈在每一步存储将要访问的未来节点。对于该算法,动作代价假设等于 0。
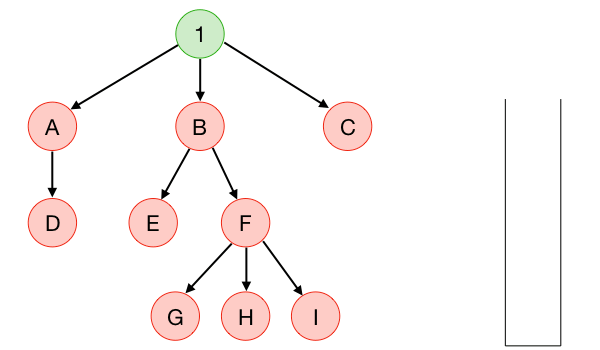
迭代加深 迭代加深技巧是对深度优先搜索算法的一种修改,使其在达到一定深度后停止,这保证了在所有动作代价相等时的最优性。在这里,我们假设动作代价等于常数 。
树搜索算法总结 记 为每个状态的动作数,为解的深度,为最大深度,我们有:
| | | |
| | | |
| | | |
| | | |
| | | |
图搜索
这类基于状态的算法旨在构建最优路径,实现指数级节省。在本节中,我们将重点关注动态规划和一致代价搜索。
图由一组顶点
V
(也称为节点)以及一组边
E
(也称为链接)组成。
备注: 当没有环时,称图为无环的。
状态 状态是所有过去动作的摘要,足以最优地选择未来动作。
动态规划 动态规划(DP)是一种带有记忆化(即保存部分结果)的回溯搜索算法,其目标是找到从状态 到结束状态 的最小代价路径。与传统图搜索算法相比,它可能具有指数级节省,并且具有仅适用于无环图的特性。对于任何给定状态 ,未来代价计算如下:
备注: 上图说明了自底向上的方法,而公式提供了自顶向下问题解决的直观理解。
状态类型 下表呈现了一致代价搜索背景下关于状态的术语:
| |
| |
| |
| |
一致代价搜索 一致代价搜索(UCS)是一种搜索算法,旨在找到从状态 到结束状态 的最短路径。它按 递增的顺序探索状态 ,并依赖于所有动作代价非负这一事实。
备注 1: UCS 算法在逻辑上等价于 Dijkstra 算法。
备注 2: 该算法不适用于具有负动作代价的问题,而添加正常数使其非负也不能解决问题,因为这最终会成为一个不同的问题。
正确性定理 当一个状态 从边界 弹出并移入已探索集 时,其优先级等于 ,即从 到 的最小代价路径。
图搜索算法总结 记 为总状态数,其中 个在结束状态 之前被探索,我们有:
| | | |
| | | |
| | | |
备注: 复杂度计算假设每个状态的可能动作数是常数。
学习代价
假设我们没有给定
Cost(s,a)
的值,我们想从最小代价路径动作序列
(a1,a2,...,ak)
的训练集中估计这些量。
结构化感知机 结构化感知机是一种旨在迭代学习每个状态-动作对代价的算法。在每一步,它:
•
减少训练数据给出的真实最小化路径
y
的每个状态-动作的估计代价,
•
增加从学习权重推断出的当前预测路径
y′
的每个状态-动作的估计代价。
备注: 该算法有多个版本,其中一个将问题简化为仅学习每个动作
a
的代价,另一个将
Cost(s,a)
参数化为可学习权重的特征向量。
搜索
启发式函数 启发式是状态 上的函数 ,其中每个 旨在估计 ,即从 到 的路径代价。
算法
A⋆
是一种搜索算法,旨在找到从状态
s
到结束状态
send
的最短路径。它按
PastCost(s)+h(s)
递增的顺序探索状态
s
。它等价于具有边代价
Cost′(s,a)
的一致代价搜索,由下式给出:
备注: 该算法可以看作是 UCS 的有偏版本,探索估计更接近结束状态的状态。
一致性 如果启发式 满足以下两个性质,则称其是一致的:
对于所有状态 和动作 ,
一致性
结束状态验证以下条件:
h(send)=0
一致性
正确性 如果
h
是一致的,则
A⋆
返回最小代价路径。
可采纳性 如果启发式
h
满足以下条件,则称其是可采纳的:
h(s)⩽FutureCost(s)
效率
A⋆
探索所有满足以下方程的状态
s
:
PastCost(s)⩽PastCost(send)−h(s)
备注:
h(s)
的值越大越好,正如该方程所示,它将限制将要探索的状态
s
的集合。
松弛 它是一个产生一致启发式的框架。其思想是通过移除约束来找到闭式简化代价,并将其用作启发式。
松弛搜索问题 搜索问题 的松弛,代价为 ,记为 ,代价为 ,满足恒等式:
松弛启发式 给定松弛搜索问题 ,我们定义松弛启发式 为代价 图中从 到结束状态的最小代价路径。
松弛启发式的一致性 设 为给定松弛问题。根据定理,我们有:
选择启发式时的权衡 在选择启发式时,我们必须平衡两个方面:
•
计算效率: 必须易于计算。它必须产生闭式、更简单的搜索和独立的子问题。
•
足够好的近似: 启发式 应接近 ,因此我们不能移除太多约束。
最大启发式 设 、为两个启发式。我们有以下性质:
马尔可夫决策过程
在本节中,我们假设从状态
s
执行动作
a
可以以概率方式导致多个状态
s1′,s2′,...
。为了在初始状态和结束状态之间找到路径,我们的目标将是使用马尔可夫决策过程找到最大值策略,这有助于我们应对随机性和不确定性。
符号
定义 马尔可夫决策过程的目标是最大化奖励。它定义如下:
•
起始状态
sstart
•
从状态
s
出发的可能动作
Actions(s)
•
从
s
到
s′
执行动作
a
的转移概率
T(s,a,s′)
•
从
s
到
s′
执行动作
a
的奖励
Reward(s,a,s′)
•
是否到达结束状态
IsEnd(s)
•
折扣因子
0⩽γ⩽1
转移概率 转移概率
T(s,a,s′)
指定在状态
s
采取动作
a
后到达状态
s′
的概率。每个
s′↦T(s,a,s′)
是一个概率分布,这意味着:
∀s,a,s′∈States∑T(s,a,s′)=1
策略 策略 是一个将每个状态 映射到动作 的函数,即
效用 路径 的效用是该路径上奖励的折扣和。换句话说,
上图是 情形的图示。
Q 值 策略 在状态 执行动作 的 Q 值,也记为 ,是从状态 采取动作 然后遵循策略 的期望效用。其定义如下:
策略的价值 策略 从状态 的价值,也记为 ,是从状态 遵循策略 在随机路径上的期望效用。其定义如下:
备注: 如果
s
是结束状态,则
Vπ(s)
等于 0。
应用
策略评估 给定策略 ,策略评估是一种迭代算法,旨在估计 。其操作如下:
初始化: 对于所有状态 ,我们有
迭代: 对于 从 1 到 ,我们有
其中
备注: 记 为状态数,为每个状态的动作数,为后继状态数,为迭代次数,则时间复杂度为 。
最优 Q 值 状态 执行动作 的最优 Q 值 定义为任何策略所达到的最大 Q 值。其计算如下:
最优价值 状态
s
的最优价值
Vopt(s)
定义为任何策略所达到的最大价值。其计算如下:
Vopt(s)=a∈Actions(s)maxQopt(s,a)
最优策略 最优策略
πopt
定义为导致最优价值的策略。其定义为:
∀s,πopt(s)=arga∈Actions(s)maxQopt(s,a)
值迭代 值迭代是一种找到最优价值
Vopt
以及最优策略
πopt
的算法。其操作如下:
初始化: 对于所有状态 ,我们有
迭代: 对于 从 1 到 ,我们有
其中
备注: 如果我们有
γ<1
或 MDP 图是无环的,则值迭代算法保证收敛到正确答案。
当转移和奖励未知时
现在,让我们假设转移概率和奖励是未知的。
基于模型的蒙特卡洛 基于模型的蒙特卡洛方法旨在使用蒙特卡洛模拟估计
T(s,a,s′)
和
Reward(s,a,s′)
,其中:
T^(s,a,s′)=# 次 (s,a) 发生# 次 (s,a,s′) 发生
以及
Reward^(s,a,s′)=r 在 (s,a,r,s′) 中
这些估计然后将用于推导 Q 值,包括
Qπ
和
Qopt
。
备注: 基于模型的蒙特卡洛被称为离策略的,因为估计不依赖于确切的策略。
无模型蒙特卡洛 无模型蒙特卡洛方法旨在直接估计
Qπ
,如下所示:
Q^π(s,a)=平均 ut,其中 st−1=s,at=a
其中 表示给定回合从步骤 开始的效用。
备注: 无模型蒙特卡洛被称为在策略的,因为估计值依赖于用于生成数据的策略
π
。
等价形式 通过引入常数
η=1+(#对 (s,a) 的更新)1
,对于训练集的每个
(s,a,u)
,无模型蒙特卡洛的更新规则具有凸组合形式:
Q^π(s,a)←(1−η)Q^π(s,a)+ηu
以及随机梯度形式:
Q^π(s,a)←Q^π(s,a)−η(Q^π(s,a)−u)
SARSA 状态-动作-奖励-状态-动作(SARSA)是一种自举方法,通过使用原始数据和估计值作为更新规则的一部分来估计
Qπ
。对于每个
(s,a,r,s′,a′)
,我们有:
Q^π(s,a)←(1−η)Q^π(s,a)+η[r+γQ^π(s′,a′)]
备注: SARSA 估计是即时更新的,而无模型蒙特卡洛的估计只能在回合结束时更新。
Q 学习 Q 学习是一种离策略算法,产生 的估计。对于每个 ,我们有:
Epsilon-贪婪 Epsilon-贪婪策略是一种算法,以概率 平衡探索,以概率 平衡利用。对于给定状态 ,策略 计算如下:
博弈
在游戏(例如国际象棋、西洋双陆棋、围棋)中,存在其他智能体,在构建我们的策略时需要将其考虑在内。
博弈树 博弈树是描述游戏可能性的树。特别地,每个节点是玩家的决策点,每个从根到叶的路径是游戏的可能结果。
双人零和博弈 它是一种每个状态都被完全观测且玩家轮流行动的博弈。它定义如下:
•
起始状态
sstart
•
从状态
s
出发的可能动作
Actions(s)
•
从状态
s
执行动作
a
的后继状态
Succ(s,a)
•
是否到达结束状态
IsEnd(s)
•
结束状态
s
处智能体的效用
•
控制状态 的玩家
备注: 我们将假设智能体的效用与对手的效用符号相反。
策略类型 有两种类型的策略:
•
确定性策略,记为
πp(s)
,是玩家
p
在状态
s
采取的动作。
•
随机策略,记为
πp(s,a)∈[0,1]
,是玩家
p
在状态
s
采取动作
a
的概率。
期望最大 对于给定状态
s
,期望最大值
Vexptmax(s)
是任何智能体策略在对抗固定且已知的对手策略
πopp
时的最大期望效用。其计算如下:
Vexptmax(s)=⎩⎨⎧Utility(s)maxa∈Actions(s)Vexptmax(Succ(s,a))∑a∈Actions(s)πopp(s,a)Vexptmax(Succ(s,a))IsEnd(s)Player(s)=agentPlayer(s)=opp
备注: 期望最大是 MDP 值迭代的类比。
最小最大 最小最大策略的目标是通过假设最坏情况,即对手做一切来最小化智能体的效用,找到对抗对手的最优策略。其操作如下:
Vminimax(s)=⎩⎨⎧Utility(s)maxa∈Actions(s)Vminimax(Succ(s,a))mina∈Actions(s)Vminimax(Succ(s,a))IsEnd(s)Player(s)=agentPlayer(s)=opp
备注: 我们可以从最小最大值
Vminimax
中提取
πmax
和
πmin
。
最小最大性质 记
V
为价值函数,关于最小最大有 3 个性质需要记住:
性质 1: 如果智能体将其策略更改为任何
πagent
,则智能体的境况不会更好。
∀πagent,V(πmax,πmin)⩾V(πagent,πmin)
性质 2: 如果对手将其策略从
πmin
更改为
πopp
,则他的境况不会更好。
∀πopp,V(πmax,πmin)⩽V(πmax,πopp)
性质 3: 如果已知对手不采取对抗策略,则最小最大策略可能不是智能体的最优策略。
最后,我们有以下关系:
加速最小最大
评估函数 评估函数是 的领域特定且近似的估计。它记为 。
备注: 是搜索问题的类比。
Alpha-beta 剪枝 Alpha-beta 剪枝是一种领域通用的精确方法,通过避免不必要地探索博弈树的部分来优化最小最大算法。为此,每个玩家跟踪他们能期望的最佳值(对于最大化玩家存储在 中,对于最小化玩家存储在 中)。在给定步骤,条件 意味着最优路径不会在当前分支中,因为较早的玩家有更好的选择可供使用。
TD 学习 时差(TD)学习在我们不知道转移/奖励时使用。价值基于探索策略。为了能够使用它,我们需要知道游戏规则
Succ(s,a)
。对于每个
(s,a,r,s′)
,更新如下:
w←w−η[V(s,w)−(r+γV(s′,w))]∇wV(s,w)
同时博弈
这与回合制博弈相反,其中玩家的移动没有顺序。
单步同时博弈 设有两个玩家
A
和
B
,具有给定的可能动作。我们记
V(a,b)
为如果
A
选择动作
a
、
B
选择动作
b
时
A
的效用。
V
称为支付矩阵。
策略 有两种主要类型的策略:
•
纯策略是单个动作:
•
混合策略是动作上的概率分布:
博弈评估 当玩家 遵循 且玩家 遵循 时,博弈的价值 满足:
最小最大定理 记 在混合策略上变化,对于每个具有有限动作数的同时双人零和博弈,我们有:
非零和博弈
支付矩阵 我们定义
Vp(πA,πB)
为玩家
p
的效用。
纳什均衡 纳什均衡是
(πA∗,πB∗)
,使得没有玩家有动机改变其策略。我们有:
∀πA,VA(πA∗,πB∗)⩾VA(πA,πB∗)
以及
∀πB,VB(πA∗,πB∗)⩾VB(πA∗,πB)