基于变量的模型
约束满足问题
在本节中,我们的目标是找到基于变量的模型的最大权重分配。与基于状态的模型相比,一个优势是这些算法更适合编码问题特定的约束。
因子图
定义 因子图,也称为马尔可夫随机场,是一组变量 ,其中 ,以及 个因子 ,每个 。
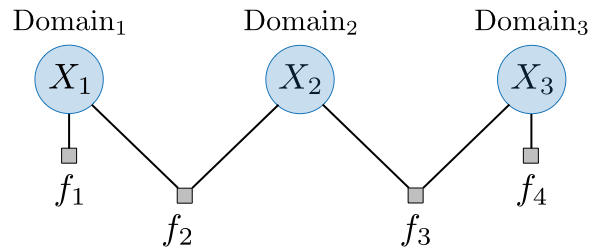
作用域与元数 因子 的作用域是它所依赖的变量集合。这个集合的大小称为元数。
备注: 元数为 1 和 2 的因子分别称为一元和二元因子。
分配权重 每个分配 产生一个权重 ,定义为应用于该分配的所有因子 的乘积。其表达式为:
约束满足问题 约束满足问题(CSP)是一个所有因子都是二值的因子图;我们称它们为约束:
这里,当且仅当 时,分配 下的约束 被称为满足的。
一致分配 CSP 的分配 当且仅当 时被称为一致的,即所有约束都满足。
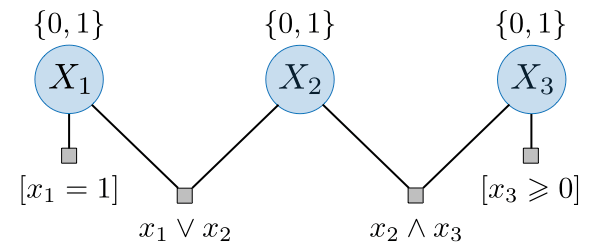
动态排序
依赖因子 变量 在部分分配 下的依赖因子集合称为 ,表示将 链接到已分配变量的因子集合。
回溯搜索 回溯搜索是一种用于找到因子图最大权重分配的算法。在每一步,它选择一个未分配的变量并通过递归探索其值。动态排序(即变量和值的选择)和前瞻(即早期消除不一致选项)可用于更高效地探索图,尽管最坏情况运行时间仍为指数级:。
前向检查 它是一种一步前瞻启发式,抢先移除邻近变量域中的不一致值。它具有以下特征:
•
在分配变量 后,它从其所有邻居的域中消除不一致值。
•
如果这些域中任何一个变为空,我们停止局部回溯搜索。
•
如果我们取消分配变量 ,我们必须恢复其邻居的域。
最受约束变量 它是一种变量级排序启发式,选择具有最少一致值的下一个未分配变量。这具有使不一致分配在搜索中更早失败的效果,从而实现更高效的剪枝。
最少约束值 它是一种值级排序启发式,分配产生最多邻近变量一致值的下一个值。直观地说,该过程首先选择最有可能成功的值。
备注: 在实践中,当所有因子都是约束时,这种启发式很有用。
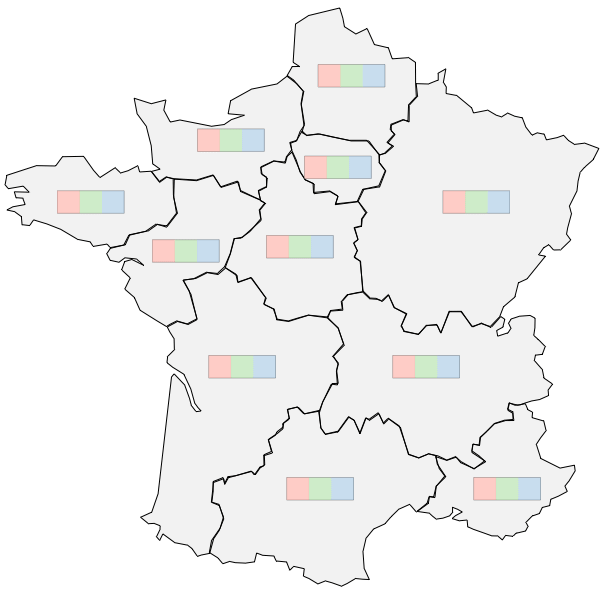
具有最受约束变量和最少约束值的前向检查
上面的例子是 3 色问题的图示,结合了回溯搜索、最受约束变量探索和最少约束值启发式,以及每一步的前向检查。
弧一致性 当对于每个
xl∈Domainl
,以下条件成立时,我们称变量 关于 的弧一致性被强制执行:
•
的一元因子非零,
•
存在至少一个 ,使得 和 之间的任何因子非零。
AC-3 AC-3 算法是一种多步前瞻启发式,将前向检查应用于所有相关变量。在给定分配后,它执行前向检查,然后对在过程中域发生变化的变量的邻居相继强制执行弧一致性。
备注: AC-3 可以迭代和递归地实现。
近似方法
束搜索 束搜索是一种近似算法,通过在每一步探索
K
条顶部路径,扩展
n
个变量、分支因子
b=∣Domain∣
的部分分配。束大小
K∈{1,...,bn}
控制效率与准确性之间的权衡。该算法的时间复杂度为
O(n⋅Kblog(Kb))
。
下面的例子说明了参数 、和 的可能束搜索。
备注:
K=1
对应于贪婪搜索,而
K→+∞
等价于 BFS 树搜索。
迭代条件模式 迭代条件模式(ICM)是一种迭代近似算法,一次修改因子图的一个变量的分配直到收敛。在第
i
步,我们将最大化连接到该变量的所有因子乘积的值
v
分配给
Xi
。
备注: ICM 可能会陷入局部最小值。
Gibbs 采样 Gibbs 采样是一种迭代近似方法,一次修改因子图的一个变量的分配直到收敛。在第 步:
•
我们为每个元素 分配一个权重 ,该权重是连接到该变量的所有因子的乘积,
•
我们从 诱导的概率分布中采样 并将其分配给 。
备注: Gibbs 采样可以看作是 ICM 的概率对应物。它的优点是能够在大多数情况下逃离局部最小值。
因子图变换
独立性 设 为变量 的划分。如果 和 之间没有边,我们说 和 是独立的,我们写作:
备注: 独立性是允许我们并行解决子问题的关键性质。
条件独立性 如果以
C
为条件产生一个图,其中
A
和
B
是独立的,我们说
A
和
B
在给定
C
下是条件独立的。在这种情况下,写作:
A⊥⊥B∣C
条件化 条件化是一种旨在使变量独立的变换,它将因子图分解为可以并行解决且可以使用回溯的更小部分。为了以变量
Xi=v
为条件,我们操作如下:
•
考虑所有依赖于
Xi
的因子
f1,...,fk
•
移除
Xi
和
f1,...,fk
•
为
j∈{1,...,k}
添加
gj(x)
,定义如下:
gj(x)=fj(x∪{Xi:v})
马尔可夫毯 设
A⊂X
为变量子集。我们定义
MarkovBlanket(A)
为不在
A
中的
A
的邻居。
命题 设
C=MarkovBlanket(A)
且
B=X\(A∪C)
。那么我们有:
消元 消元是一种因子图变换,它从图中移除
Xi
并以其马尔可夫毯为条件解决一个小子问题,如下所示:
•
考虑所有依赖于
Xi
的因子
fi,1,...,fi,k
•
移除 和
•
添加 ,定义如下:
fnew,i(x)=ximaxl=1∏kfi,l(x)
树宽 因子图的树宽是变量消元以最佳变量排序创建的任何因子的最大元数。换句话说,
Treewidth=orderingsmini∈{1,...,n}maxarity(fnew,i)
下面的例子说明了树宽为 3 的因子图的情形。
备注: 找到最佳变量排序是一个 NP 难问题。
贝叶斯网络
在本节中,我们的目标将是计算条件概率。给定证据,查询的概率是多少?
简介
** explaining away** 假设原因 和 影响效果 。以效果 和其中一个原因(比如 )为条件会改变另一个原因(比如 )的概率。在这种情况下,我们说 解释了 。
有向无环图 有向无环图(DAG)是一个没有有向环的有限有向图。
贝叶斯网络 贝叶斯网络是一个有向无环图(DAG),它将随机变量
X=(X1,...,Xn)
上的联合分布指定为局部条件分布的乘积,每个节点一个:
备注: 贝叶斯网络是赋予概率语言的因子图。
局部归一化 对于每个
xParents(i)
,所有因子都是局部条件分布。因此它们必须满足:
xi∑p(xi∣xParents(i))=1
因此,子贝叶斯网络和条件分布是一致的。
备注: 局部条件分布是真实的条件分布。
边缘化 叶节点的边缘化产生一个没有该节点的贝叶斯网络。
概率程序
概念 概率程序随机化变量分配。这样,我们可以写下复杂的贝叶斯网络来生成分配,而无需我们显式指定相关的概率。
备注: 概率程序的例子包括隐马尔可夫模型(HMM)、因子 HMM、朴素贝叶斯、潜在狄利克雷分配、疾病与症状以及随机块模型。
总结 下表总结了常见的概率程序及其应用:
| | | |
| | 附件不支持打印 | |
| | 附件不支持打印 | |
| | | |
| | | |
| | | |
推理
一般概率推理策略 计算给定证据
E=e
时查询
Q
的概率
P(Q∣E=e)
的策略如下:
•
步骤 1: 通过边缘化移除不是查询 或证据 祖先的变量
•
步骤 2: 将贝叶斯网络转换为因子图
•
步骤 3: 以证据 为条件
•
步骤 4: 通过边缘化移除与查询 断开的节点
•
步骤 5: 运行概率推理算法(手动、变量消元、Gibbs 采样、粒子滤波)
备注: 该算法将每个分配解释为一条路径,其中每条边 的权重为 。
Gibbs 采样 该算法是一种迭代近似方法,使用一小组分配(粒子)来表示大型概率分布。从随机分配 开始,Gibbs 采样对 执行以下步骤直到收敛:
•
对于所有 ,计算分配 的权重 ,其中
•
从 诱导的概率分布中采样 :
•
设置
备注:
X−i
表示
X\{Xi}
,
x−i
表示相应的分配。
粒子滤波 该算法通过一次跟踪
K
个粒子,在给定观测变量证据的情况下近似状态变量的后验密度。从大小为
K
的粒子集
C
开始,我们迭代运行以下 3 个步骤:
•
步骤 1:提议 - 对于每个旧粒子
xt−1∈C
,从转移概率分布
p(x∣xt−1)
中采样
x
并将
x
添加到集合
C′
。
•
步骤 2:加权 - 用
w(x)=p(et∣x)
对集合
C′
中的每个
x
加权,其中
et
是在时间
t
观测到的证据。
•
步骤 3:重采样 - 使用
w
诱导的概率分布从集合
C′
中采样
K
个元素并将它们存储在
C
中:这些是当前粒子
xt
。
备注: 该算法的更昂贵版本还在提议步骤中跟踪过去的粒子。
最大似然 如果我们不知道局部条件分布,我们可以使用最大似然来学习它们。
θmaxx∈Dtrain∏p(X=x;θ)
拉普拉斯平滑 对于每个分布
d
和部分分配
(xParents(i),xi)
,将
λ
添加到
countd(xParents(i),xi)
,然后归一化以获得概率估计。
算法 期望最大化(EM)算法通过反复构造似然的下界(E 步)并优化该下界(M 步),提供了一种通过最大似然估计来估计参数
θ
的高效方法,具体如下:
E 步: 计算每个数据点
e
来自特定聚类
h
的后验概率
q(h)
,如下所示:
q(h)=P(H=h∣E=e;θ)
M 步: 使用后验概率
q(h)
作为数据点
e
的聚类特定权重,通过最大似然确定
θ
。