机器学习技巧与窍门
分类指标
在二分类的背景下,以下是评估模型性能时需要跟踪的主要指标。
混淆矩阵 混淆矩阵用于在评估模型性能时获得更全面的图景。其定义如下:
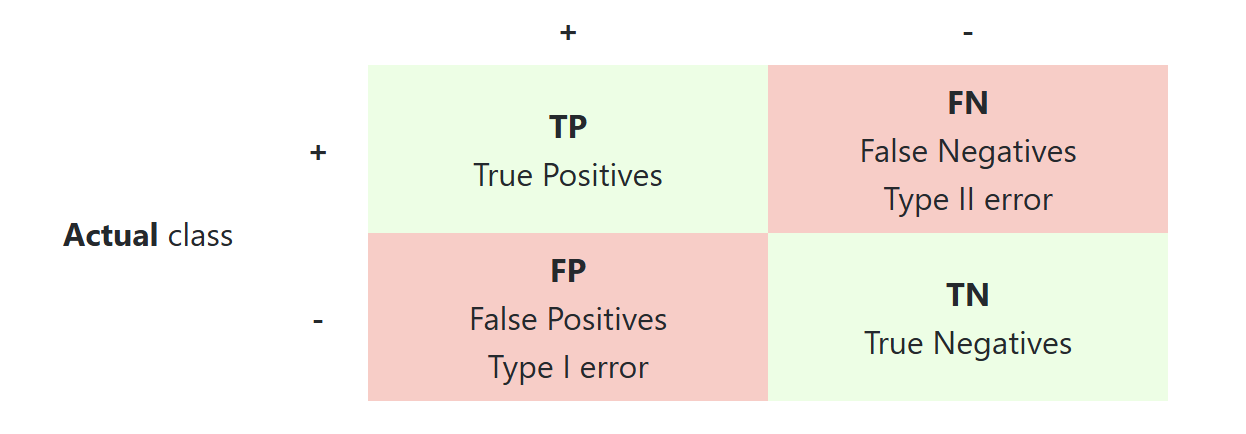
主要指标 以下指标常用于评估分类模型的性能:
| | |
| | |
| | |
| | |
| | |
| | |
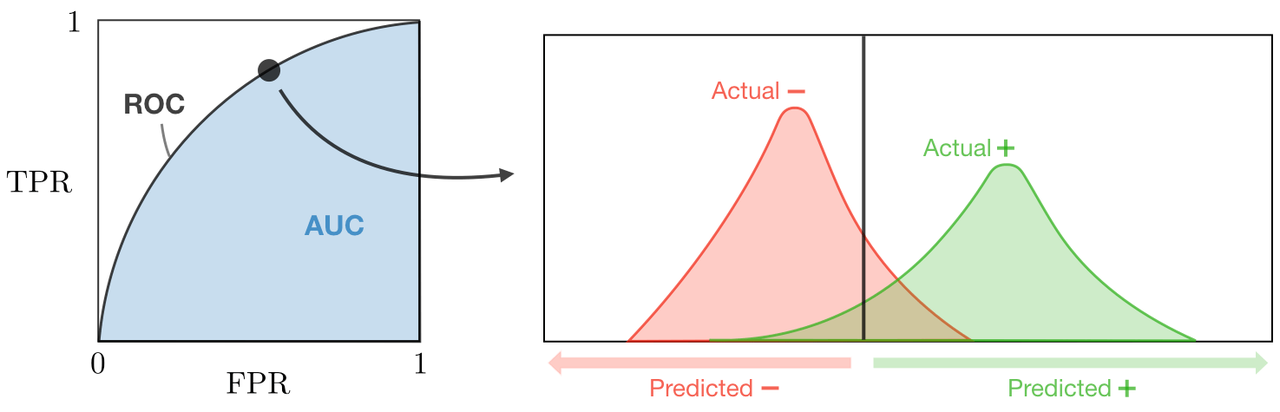
ROC 受试者工作特征曲线,也记为 ROC,是通过改变阈值绘制的 TPR 与 FPR 的关系图。这些指标总结如下表:
| | |
| | |
| | |
AUC 受试者工作特征曲线下面积,也记为 AUC 或 AUROC,是 ROC 曲线下方的面积,如下图所示:
回归指标
基本指标 给定回归模型
f
,以下指标常用于评估模型的性能:
| | |
| | |
决定系数 决定系数通常记为 或 ,提供了观测结果被模型复现程度的度量,定义如下:
主要指标 以下指标通过考虑模型所考虑的变量数量 ,常用于评估回归模型的性能:
| | | |
| | | |
其中 是似然,是与每个响应相关的方差的估计。
模型选择
术语 在选择模型时,我们将所拥有的数据区分为以下 3 个不同部分:
| | |
| | |
| | |
| | |
一旦模型被选定,它就在整个数据集上训练,并在未见的测试集上测试。如下图所示:
数据集的划分
交叉验证 交叉验证,也记为 CV,是一种用于选择不太依赖初始训练集的模型的方法。不同类型总结如下表:
| |
| |
| |
最常用的方法称为 折交叉验证,将训练数据分成 折,在一折上验证模型,同时在另外 折上训练模型,整个过程重复 次。然后对 折的误差取平均,称为交叉验证误差。
正则化 正则化过程旨在避免模型对数据过拟合,从而处理高方差问题。下表总结了常用的不同类型正则化技术:
| | |
| | |
附件不支持打印 | 附件不支持打印 | 附件不支持打印 |
| | |
诊断
偏差 模型的偏差是给定数据点时,期望预测与我们试图预测的正确模型之间的差异。
方差 模型的方差是给定数据点时,模型预测的可变性。
偏差/方差权衡 模型越简单,偏差越高;模型越复杂,方差越高。
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
误差分析 误差分析是分析当前模型与完美模型之间性能差异的根本原因。
消融分析 消融分析是分析当前模型与基线模型之间性能差异的根本原因。