循环神经网络
一、概述
传统 RNN 的架构:循环神经网络(也称为 RNN)是一类神经网络,它允许先前的输出在拥有隐藏状态的同时被用作输入。它们通常如下所示:
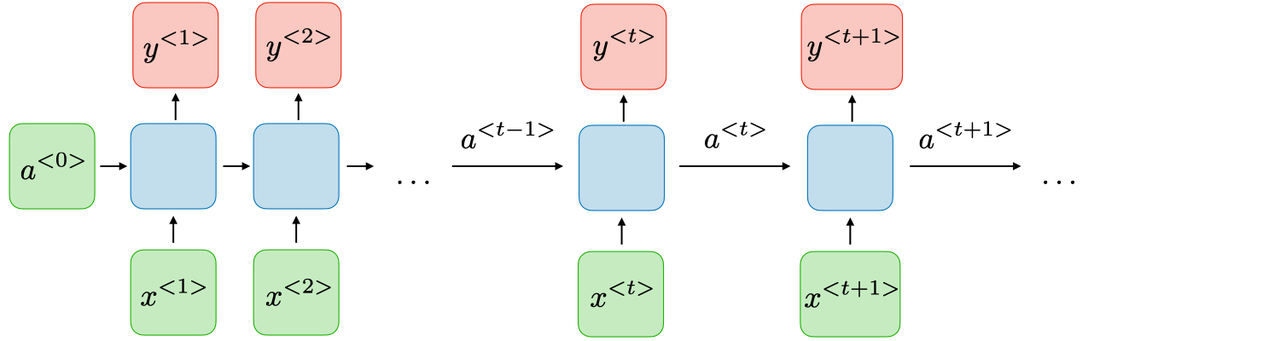
对于每个时间步 ,激活值 和输出 表示如下:
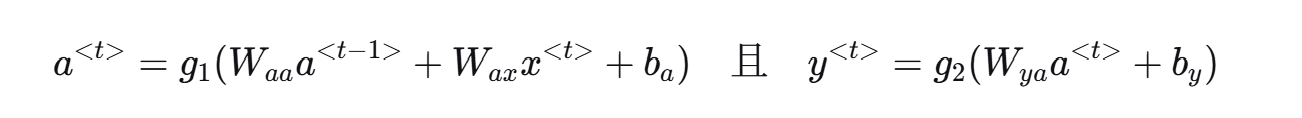
其中 是在时间上共享的系数,是激活函数。
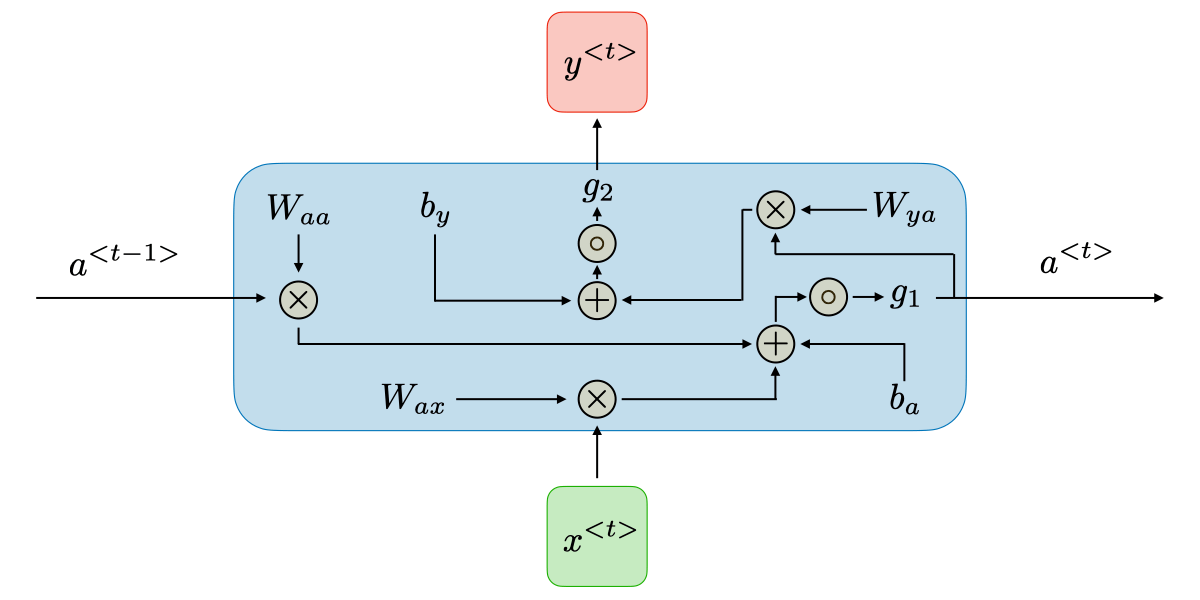
典型 RNN 架构的优缺点总结在下表中:
| |
| |
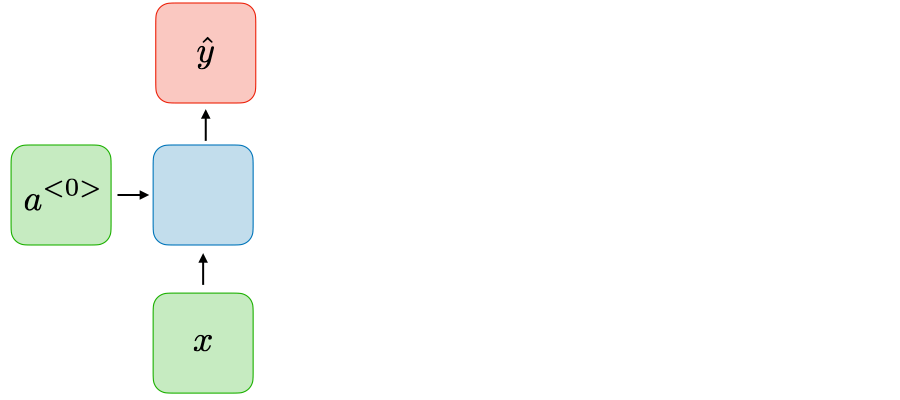
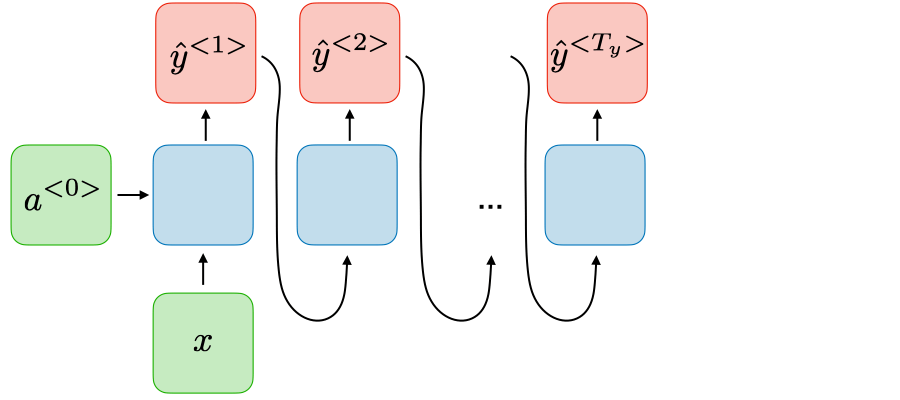
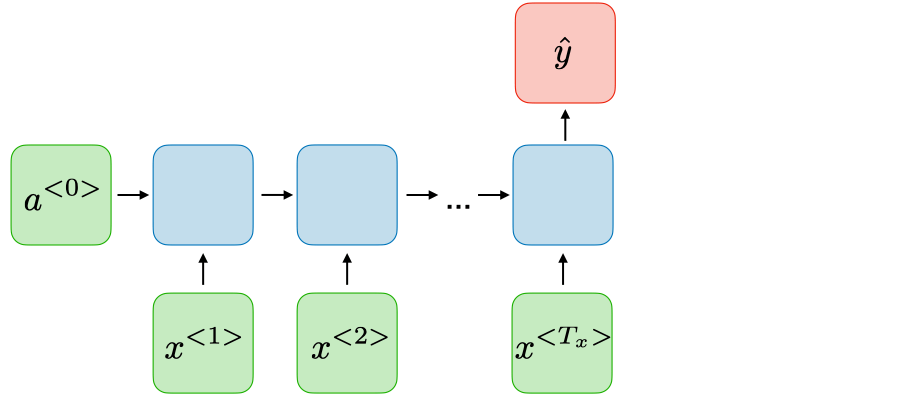
RNN 的应用:RNN 模型主要用于自然语言处理和语音识别领域。不同的应用总结在下表中:
| | |
| |  |
| |  |
| |  |
| | |
| | |
损失函数:在循环神经网络的情况下,所有时间步的损失函数 基于每个时间步的损失定义如下:
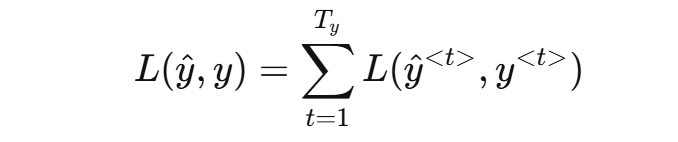
随时间反向传播:反向传播在每个时间点进行。在时间步 ,损失 对权重矩阵 的导数表示如下:
处理长期依赖
常用的激活函数:RNN 模块中最常用的激活函数描述如下:
| | |
| | |
附件不支持打印 | 附件不支持打印 | 附件不支持打印 |
梯度消失/爆炸:梯度消失和爆炸现象在 RNN 中经常遇到。它们发生的原因是难以捕捉长期依赖,因为乘法梯度可能随层数呈指数级下降/增加。
梯度裁剪:这是一种用于应对在执行反向传播时有时遇到的梯度爆炸问题的技术。通过限制梯度的最大值,这种现象在实践中得到控制。
门的类型:为了解决梯度消失问题,在某些类型的 RNN 中使用了特定的门,通常有明确的目的。它们通常记为
Γ
,等于:
其中
W,U,b
是门特定的系数,
σ
是 sigmoid 函数。主要的门总结在下表中:
| | |
| | |
| | |
| | |
| | |
GRU/LSTM:门控循环单元(GRU)和长短期记忆单元(LSTM)处理传统 RNN 遇到的梯度消失问题,其中 LSTM 是 GRU 的推广。下表总结了每种架构的特征方程:
| | |
| | |
| | |
| | |
| 附件不支持打印 | 附件不支持打印 |
备注:符号 表示两个向量之间的逐元素乘法。
RNN 的变体:下表总结了其他常用的 RNN 架构:
| |
附件不支持打印 | 附件不支持打印 |
学习词表示
在本节中,我们记 为词汇表,为其大小。
动机与符号
表示技术:表示单词的两种主要方法总结在下表中:
| |
| |
附件不支持打印 | 附件不支持打印 |
嵌入矩阵:对于给定的单词
w
,嵌入矩阵
E
是一个矩阵,将其独热表示
ow
映射到其嵌入
ew
,如下所示:
备注:学习嵌入矩阵可以使用目标/上下文似然模型来完成。
词嵌入
Word2vec:Word2vec 是一个旨在通过估计给定单词被其他单词包围的似然来学习词嵌入的框架。流行的模型包括 skip-gram、负采样和 CBOW。
Skip-gram:skip-gram word2vec 模型是一个监督学习任务,通过评估任何给定目标词
t
与上下文词
c
一起出现的似然来学习词嵌入。记
θt
为与
t
相关的参数,概率
P(t∣c)
由下式给出:
备注:在 softmax 部分的分母中对整个词汇表求和使该模型计算成本高昂。CBOW 是另一个 word2vec 模型,使用周围的词来预测给定的词。
负采样:它是一组使用逻辑回归的二元分类器,旨在评估给定上下文和给定目标词同时出现的可能性,模型在
k
个负例和 1 个正例的集合上训练。给定上下文词
c
和目标词
t
,预测表示为:
备注:这种方法比 skip-gram 模型计算成本更低。
GloVe:GloVe 模型(全局词表示向量的缩写)是一种词嵌入技术,使用共现矩阵
X
,其中每个
Xi,j
表示目标
i
与上下文
j
一起出现的次数。其代价函数
J
如下:
其中
f
是一个加权函数,使得
Xi,j=0⇒f(Xi,j)=0
。
鉴于
e
和
θ
在该模型中扮演的对称性,最终词嵌入
ew(final)
由下式给出:
备注:学习到的词嵌入的各个分量不一定可解释。
比较单词
余弦相似度:单词
w1
和
w2
之间的余弦相似度表示如下:
备注:
θ
是单词
w1
和
w2
之间的夹角。
t-SNE:t-SNE(t-分布随机邻域嵌入)是一种旨在将高维嵌入降维到低维空间的技术。在实践中,它通常用于在 2D 空间中可视化词向量。
语言模型
概述:语言模型旨在估计句子
P(y)
的概率。
n-gram 模型:该模型是一种朴素方法,旨在通过计算表达式在训练数据中出现的次数来量化其在语料库中出现的概率。
困惑度:语言模型通常使用困惑度(也称为 PP)指标进行评估,它可以解释为数据集概率的倒数除以单词数
T
的归一化。困惑度越低越好,定义如下:
备注:PP 常用于 t-SNE。
机器翻译
概述:机器翻译模型类似于语言模型,只是它前面放置了一个编码器网络。因此,它有时被称为条件语言模型。
目标是找到一个句子 ,使得:
束搜索:它是一种启发式搜索算法,用于机器翻译和语音识别,以在给定输入
x
的情况下找到最可能的句子
y
。
• 步骤 1:找到前
B
个可能的单词
y<1>
• 步骤 2:计算条件概率
y<k>∣x,y<1>,...,y<k−1>
• 步骤 3:保留前
B
个组合
x,y<1>,...,y<k>
备注:如果束宽设置为 1,则等同于朴素的贪婪搜索。
束宽:束宽
B
是束搜索的一个参数。较大的
B
值产生更好的结果,但性能较慢且内存增加。较小的
B
值导致较差的结果,但计算强度较低。
B
的标准值约为 10。
长度归一化:为了提高数值稳定性,束搜索通常应用于以下归一化目标,通常称为归一化对数似然目标,定义为:
备注:参数 可以看作是一个软化剂,其值通常在 0.5 到 1 之间。
误差分析:当获得一个糟糕的预测翻译
y^
时,人们可能会想为什么我们没有通过执行以下误差分析得到一个好的翻译
y∗
:
| 情况 |
P(y∗∣x)>P(y^∣x)
|
P(y∗∣x)⩽P(y^∣x)
|
|---|---|---|---|
| 根本原因 | 束搜索故障 | RNN 故障 |
| 补救措施 | 增加束宽 | • 尝试不同的架构
• 正则化
• 获取更多数据 |
BLEU 分数:双语评估替补(bleu)分数通过计算基于
n
-gram 精度的相似度分数来量化机器翻译的好坏。其定义如下:
其中
pn
是仅
n
-gram 的 bleu 分数,定义如下:
备注:可以对短的预测翻译应用简短惩罚,以防止人为夸大 bleu 分数。
注意力
注意力模型:该模型允许 RNN 关注输入中被认为重要的特定部分,这在实践中提高了所得模型的性能。记
α<t,t′>
为输出
y<t>
应该对激活
a<t′>
施加的注意力,
c<t>
为时间
t
的上下文,我们有:
备注:注意力分数常用于图像描述和机器翻译。
50%
50%
注意力权重:输出
y<t>
应该对激活
a<t′>
施加的注意力由
α<t,t′>
给出,计算如下:
备注:计算复杂度相对于
Tx
是二次的。