无监督学习
无监督学习简介
动机 无监督学习的目标是在无标签数据中寻找隐藏的模式。
Jensen 不等式 设为凸函数,为随机变量。我们有如下不等式:
聚类
期望最大化
隐变量 隐变量是隐藏的/未观测到的变量,它们使估计问题变得困难,通常记为。以下是最常见的存在隐变量的情形:
| | | |
| | | |
| | | |
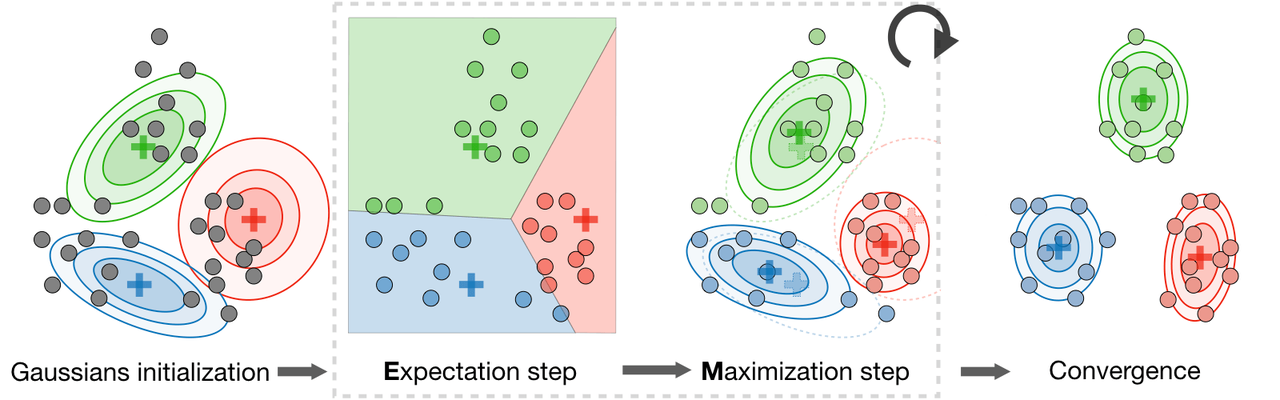
算法 期望最大化(EM)算法通过反复构造似然的下界(E 步)并优化该下界(M 步),提供了一种通过最大似然估计来估计参数的高效方法,具体如下:
E 步: 计算每个数据点来自特定聚类的后验概率,如下所示:
M 步: 使用后验概率作为数据点的聚类特定权重,分别重新估计每个聚类模型,如下所示:
均值聚类
我们记为数据点所属的聚类,为聚类的中心。
算法 在随机初始化聚类中心之后,均值算法重复以下步骤直到收敛:
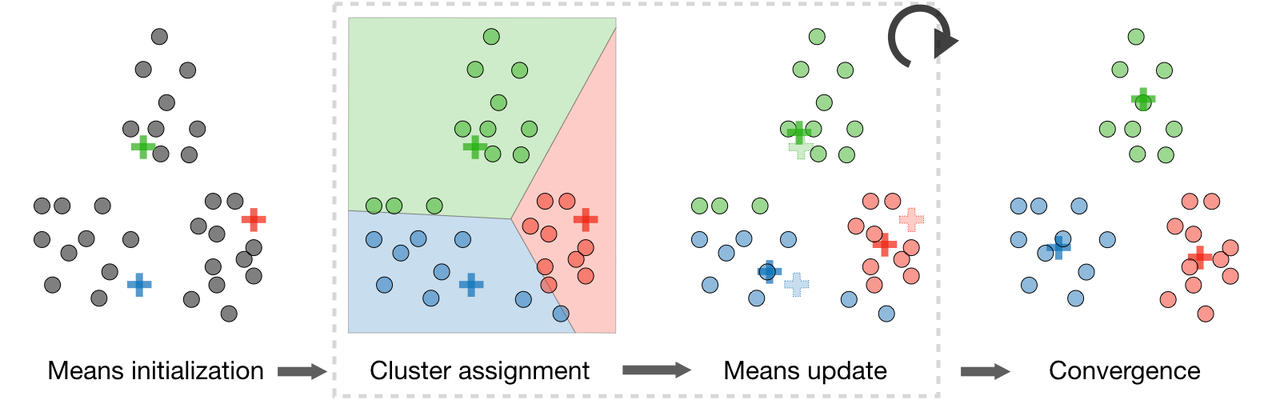
畸变函数 为了判断算法是否收敛,我们观察如下定义的畸变函数:
层次聚类
算法 它是一种采用凝聚层次方法的聚类算法,以逐次的方式构建嵌套的聚类。
类型 有不同的层次聚类算法,旨在优化不同的目标函数,总结如下表:
| | |
| | |
聚类评估指标
在无监督学习环境中,评估模型的性能通常很困难,因为不像监督学习那样有真实标签。
轮廓系数 记 为样本与同一类中所有其他点之间的平均距离,为样本与下一个最近聚类中所有其他点之间的平均距离,则单个样本的轮廓系数 定义如下:
Calinski-Harabaz 指数 记 为聚类数,和 分别为簇间和簇内离散矩阵,定义如下:
Calinski-Harabaz 指数 表示聚类模型定义其聚类的效果,分数越高,聚类越密集且分离得越好。其定义如下:
降维
主成分分析
它是一种降维技术,寻找方差最大化的方向以将数据投影到其上。
特征值、特征向量 给定矩阵 ,如果存在向量 (称为特征向量),使得:
则称 为 的特征值。
谱定理 设 。如果 是对称的,则 可由实正交矩阵 对角化。记 ,我们有:
备注: 与最大特征值相关联的特征向量称为矩阵 的主特征向量。
算法 主成分分析(PCA)过程是一种降维技术,通过最大化数据的方差将数据投影到 维上,具体如下:
步骤 1: 将数据归一化,使其均值为 0,标准差为 1。
步骤 2: 计算 ,它是对称的且具有实特征值。
步骤 3: 计算 ,即 的 个正交主特征向量,也就是 个最大特征值对应的正交特征向量。
步骤 4: 将数据投影到 上。
该过程在所有 维空间中最大化方差。
独立成分分析
它是一种旨在寻找潜在生成源的技术。
假设 我们假设数据 是由 维源向量 生成的,其中 是独立随机变量,通过混合且非奇异的矩阵 生成,如下所示:目标是找到解混矩阵 。
Bell 和 Sejnowski ICA 算法 该算法通过以下步骤找到解混矩阵 :
写出 的概率为:
写出给定训练数据 的对数似然,并记 为 Sigmoid 函数:
因此,随机梯度上升学习规则使得对于每个训练样本 ,我们按如下方式更新 :