深度学习技巧与提示
数据处理
数据增强:深度学习模型通常需要大量数据才能得到正确训练。使用数据增强技术从现有数据中获取更多数据通常很有用。主要技术总结在下表中。更准确地说,给定以下输入图像,我们可以应用以下技术:
| | | |
| | | |
 |  |  |  |
| | | |
| | | |
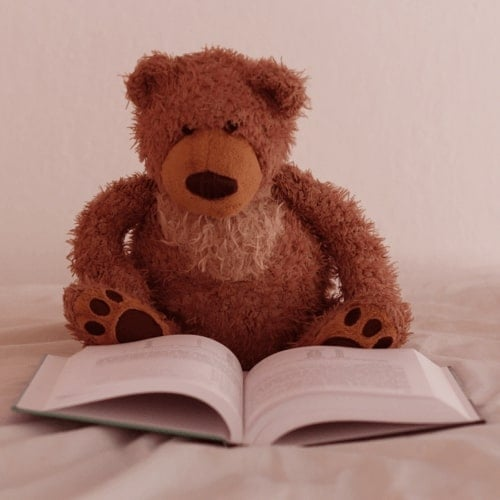 | 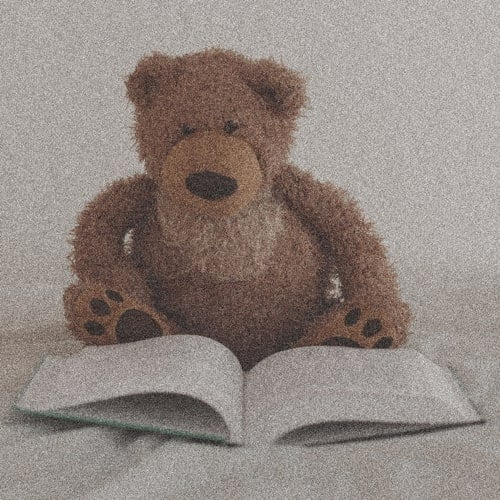 | 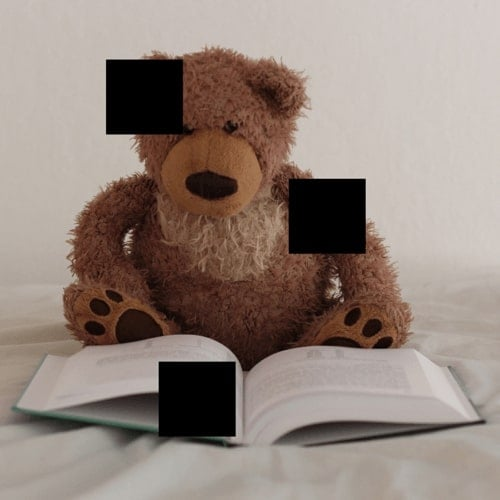 | 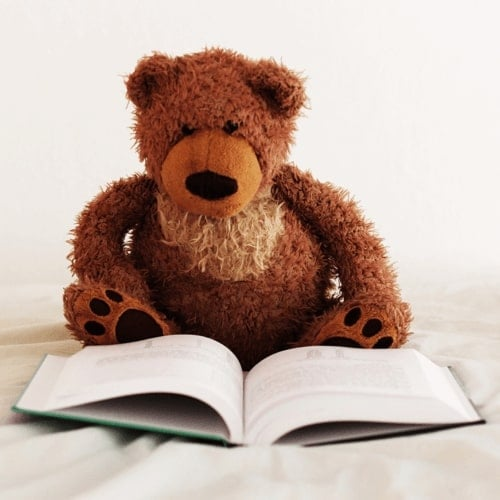 |
备注:数据通常在训练期间动态增强。
批量归一化:这是一个超参数为 的步骤,用于归一化批次 。记 为我们想要针对批次校正的均值和方差,其操作如下:
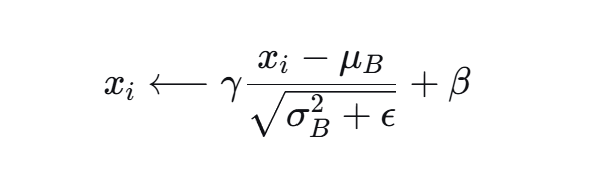
它通常在全连接层/卷积层之后、非线性层之前进行,旨在允许更高的学习率并减少对初始化的强烈依赖。
训练神经网络
定义
Epoch(轮次):在训练模型的背景下,epoch 是一个术语,指的是模型看到整个训练集以更新其权重的一次迭代。
小批量梯度下降:在训练阶段,由于计算复杂性,通常不会一次基于整个训练集更新权重,也不会由于噪声问题而基于单个数据点更新。相反,更新步骤是在小批量上完成的,其中批次中的数据点数量是我们可以调整的超参数。
损失函数:为了量化给定模型的表现,损失函数 通常用于评估模型输出 在多大程度上正确预测了实际输出 。
交叉熵损失:在神经网络二元分类的背景下,交叉熵损失 被广泛使用,定义如下:
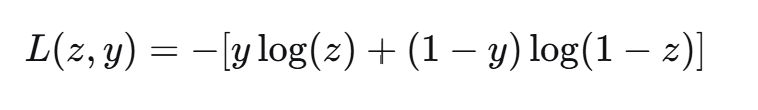
寻找最优权重
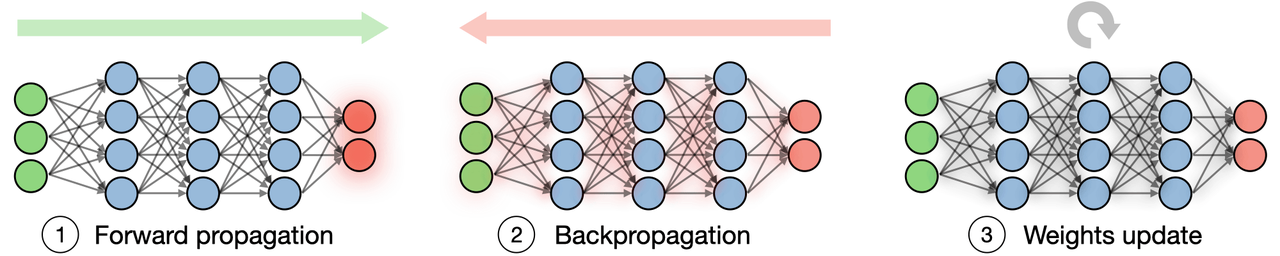
反向传播:反向传播是一种通过考虑实际输出和期望输出来更新神经网络中权重的方法。对每个权重 的导数使用链式法则计算。
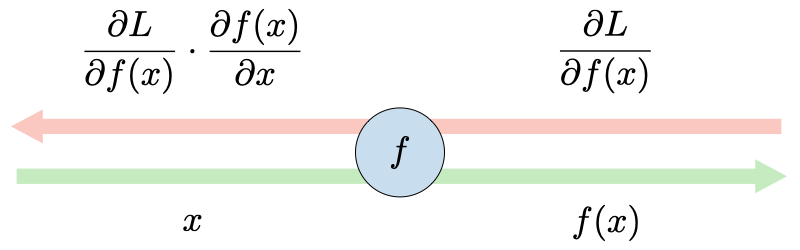
使用这种方法,每个权重按照以下规则更新:
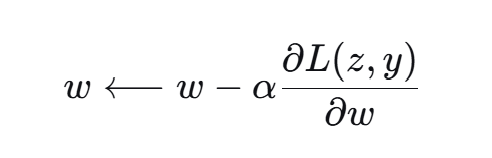
更新权重:在神经网络中,权重更新如下:
• 步骤 1:取一批训练数据并执行前向传播以计算损失。
• 步骤 2:反向传播损失以获得损失对每个权重的梯度。
• 步骤 3:使用梯度更新网络的权重。
参数调整
权重初始化
Xavier 初始化:Xavier 初始化不是以纯随机方式初始化权重,而是使初始权重考虑到该架构特有的特征。
迁移学习:训练深度学习模型需要大量数据,更重要的是需要大量时间。利用在大型数据集上预训练的权重(这些权重可能花费了数天/数周训练)并将其用于我们的用例通常很有用。根据我们手头有多少数据,以下是利用它的不同方式:
| | |
| 附件不支持打印 | |
| 附件不支持打印 | |
| | |
优化收敛
学习率:学习率(通常记为 或有时记为 )表示权重更新的速度。它可以是固定的或自适应变化的。当前最流行的方法称为 Adam,这是一种自适应调整学习率的方法。
自适应学习率:在训练模型时让学习率变化可以减少训练时间并改善数值最优解。虽然 Adam 优化器是最常用的技术,但其他方法也可能有用。它们总结在下表中:
| | | |
| | | |
| | | |
| | | |
备注:其他方法包括 Adadelta、Adagrad 和 SGD。
正则化
Dropout:Dropout 是神经网络中用于防止过拟合训练数据的一种技术,它以概率 丢弃神经元。它迫使模型避免过度依赖特定的特征集。
备注:大多数深度学习框架通过 'keep' 参数 来参数化 dropout。
权重正则化:为了确保权重不会太大并且模型不会过拟合训练集,通常对模型权重执行正则化技术。主要的方法总结在下表中:
| | |
| | |
附件不支持打印 | 附件不支持打印 | 附件不支持打印 |
| | |
早停:这种正则化技术在验证损失达到平台期或开始增加时立即停止训练过程。
良好实践
小批量过拟合:在调试模型时,进行快速测试以查看模型架构本身是否存在任何重大问题通常很有用。特别是,为了确保模型能够正确训练,将一个小批量传入网络以查看它是否能对其进行过拟合。如果不能,这意味着模型要么太复杂,要么不够复杂,甚至无法对一个小批量过拟合,更不用说正常大小的训练集了。
梯度检查:梯度检查是在神经网络反向传播实现期间使用的一种方法。它在给定点比较解析梯度的值与数值梯度的值,起到正确性健全检查的作用。
| | |
| | |
| | |