基于反射的模型
线性预测器
在本节中,我们将介绍可以通过经验改进的基于反射的模型,通过处理具有输入-输出对的样本进行学习。
特征向量 输入 的特征向量记为 ,其定义如下:
得分 与权重为 的线性模型相关联的样本 的得分 由内积给出:
分类
线性分类器 给定权重向量 和特征向量 ,二分类线性分类器 由下式给出:
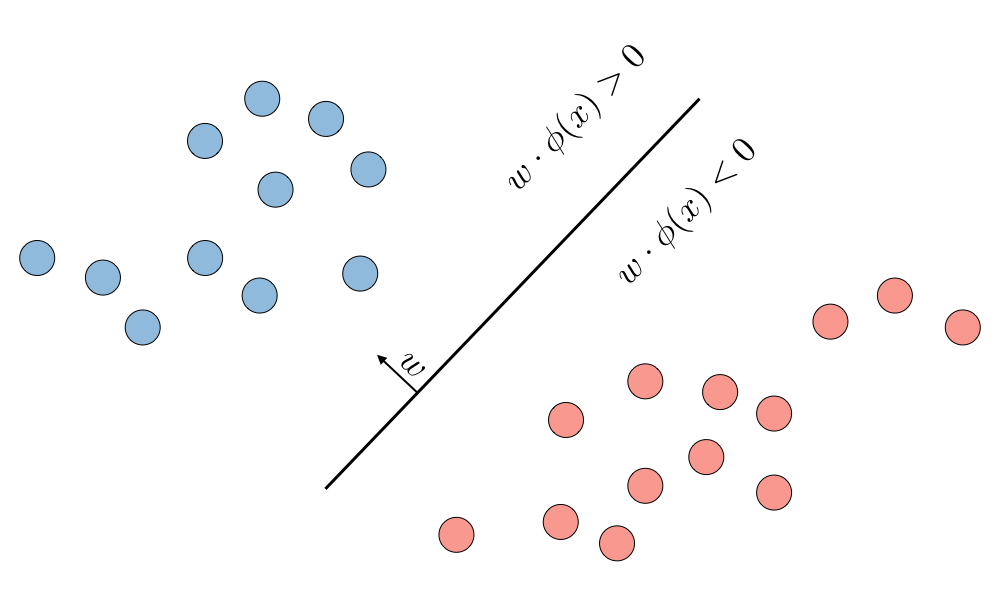
线性分类器
间隔 与权重为 的线性模型相关联的样本 的间隔 量化了预测的置信度:值越大越好。它由下式给出:
回归
线性回归 给定权重向量 和特征向量 ,权重为 的线性回归的输出记为 ,由下式给出:
残差 残差 定义为预测 超出目标 的量:
损失最小化
损失函数 损失函数 量化了我们对模型权重 在从输入 预测输出 任务中的不满程度。它是我们在训练过程中想要最小化的量。
分类情形 使用权重为 的线性模型对真实标签为 的样本 进行分类,可以通过预测器 完成。在这种情况下,量化分类质量的指标由间隔 给出,可与以下损失函数一起使用:
| | | |
| | | |
| | | |
回归情形 使用权重为 的线性模型对真实标签为 的样本 进行预测,可以通过预测器 完成。在这种情况下,量化回归质量的指标由间隔 给出,可与以下损失函数一起使用:
| | |
| | |
| 附件不支持打印 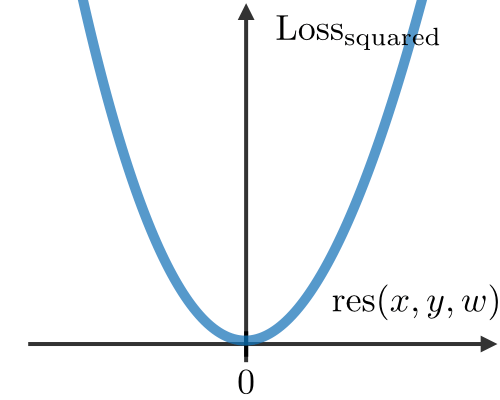 | 附件不支持打印 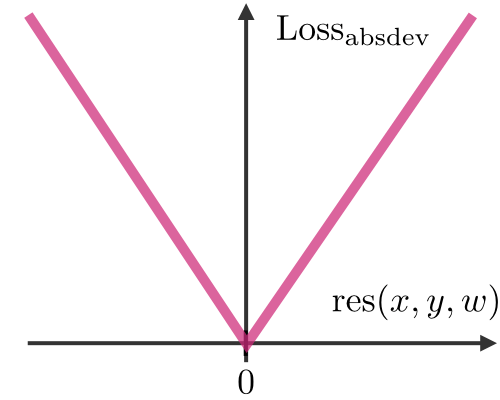 |
损失最小化框架 为了训练模型,我们希望最小化如下定义的训练损失:
非线性预测器
近邻 近邻算法,通常称为 -NN,是一种非参数方法,其中数据点的响应由其训练集中 个邻居的性质决定。它可用于分类和回归场景。
备注: 参数
k
越大,偏差越高;参数
k
越小,方差越高。
神经网络 神经网络是一类由层构建的模型。常用的神经网络类型包括卷积神经网络和循环神经网络。神经网络架构相关的术语如下图所示:
记
i
为网络的第
i
层,
j
为该层的第
j
个隐藏单元,我们有:
其中我们记 、、、分别为神经元的权重、偏置、输入和未激活输出。
随机梯度下降
梯度下降 记 为学习率(也称为步长),梯度下降的更新规则用学习率和损失函数 表示如下:
梯度下降
随机更新 随机梯度下降(SGD)一次更新模型的一个训练样本 的参数。这种方法有时会导致噪声较大的更新,但更新速度快。
批量更新 批量梯度下降(BGD)一次更新模型的一批样本(例如整个训练集)的参数。这种方法计算稳定的更新方向,但计算成本更高。
微调模型
假设类 假设类 是具有固定 和变化 的可能预测器的集合:
F={fw:w∈Rd}
逻辑函数 逻辑函数
σ
,也称为 Sigmoid 函数,定义为:
∀z∈]−∞,+∞[,σ(z)=1+e−z1
备注: 我们有 。
反向传播 前向传播通过 完成,是以 为根的子表达式的值;而后向传播通过 完成,表示 如何影响输出。
近似误差与估计误差 近似误差 表示整个假设类 与目标预测器 的距离,而估计误差 量化预测器 相对于假设类 中最佳预测器 的好坏。
正则化 正则化旨在防止模型对数据过拟合,从而处理高方差问题。下表总结了常用的不同类型正则化技术:
| | |
| | |
附件不支持打印 | 附件不支持打印 | 附件不支持打印 |
| | |
超参数 超参数是学习算法的属性,包括架构相关特征、正则化参数 、迭代次数 、步长 等。
集合术语 在选择模型时,我们将所拥有的数据区分为以下 3 个不同部分:
| | |
| | |
| | |
| | |
一旦模型被选定,它就在整个数据集上训练,并在未见的测试集上测试。如下图所示:
无监督学习
这类无监督学习方法旨在发现数据的结构,数据可能具有丰富的潜在结构。
k
均值
聚类 给定包含
n
个输入点的训练集
Dtrain
,聚类算法的目标是将每个点
φ(xi)
分配给一个聚类
zi∈{1,...,k}
。
目标函数 主要聚类算法之一
k
均值的损失函数由下式给出:
Lossk-means(x,μ)=i=1∑n∣∣φ(xi)−μzi∣∣2
算法 在随机初始化聚类中心
μ1,μ2,...,μk∈Rd
之后,
k
均值算法重复以下步骤直到收敛:
主成分分析
特征值、特征向量 给定矩阵
A∈Rd×d
,如果存在向量
z∈Rd\{0}
(称为特征向量),使得:
Az=λz
则称
λ
为
A
的特征值。
谱定理 设
A∈Rd×d
。如果
A
是对称的,则
A
可由实正交矩阵
U∈Rd×d
对角化。记
Λ=diag(λ1,...,λd)
,我们有:
∃Λ 对角,A=UΛUT
备注: 与最大特征值相关联的特征向量称为矩阵
A
的主特征向量。
算法 主成分分析(PCA)过程是一种降维技术,通过最大化数据的方差将数据投影到
k
维上,具体如下:
•
步骤 1: 将数据归一化,使其均值为 0,标准差为 1。
φj(xi)←σjφj(xi)−μj其中μj=n1i=1∑nφj(xi)和σj2=n1i=1∑n(φj(xi)−μj)2
•
步骤 2: 计算
Σ=n1i=1∑nφ(xi)φ(xi)T∈Rd×d
,它是对称的且具有实特征值。
•
步骤 3: 计算
u1,...,uk∈Rd
,即
Σ
的
k
个正交主特征向量,也就是
k
个最大特征值对应的正交特征向量。
•
步骤 4: 将数据投影到
spanR(u1,...,uk)
上。
该过程在所有
k
维空间中最大化方差。