监督学习
监督学习简介
给定一组数据点 以及与之对应的一组结果 ,我们希望构建一个分类器,学习如何从 预测 。
模型类型
不同的模型总结如下表:
| | |
| | |
| | |
| 附件不支持打印 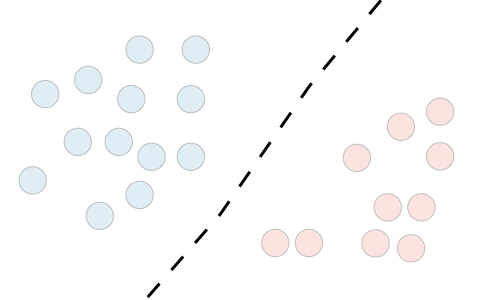 | 附件不支持打印 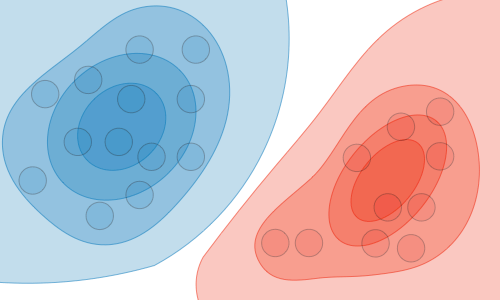 |
| | |
符号与一般概念
假设
假设记为 ,是我们选择的模型。对于给定的输入数据 ,模型的预测输出为 。
损失函数
损失函数是一个函数 ,它以对应于真实数据值 的预测值 为输入,输出它们之间的差异程度。常见的损失函数总结如下表:
| | | |
| | | |
附件不支持打印 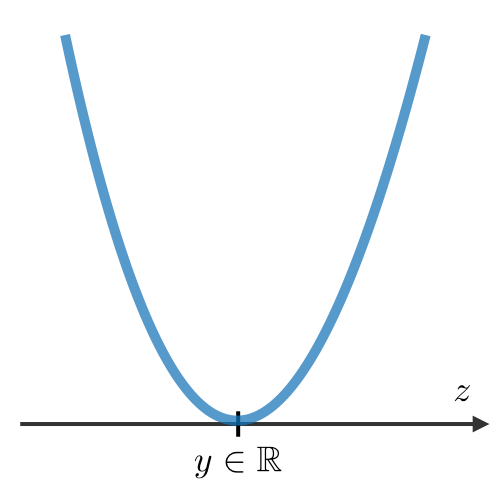 | 附件不支持打印 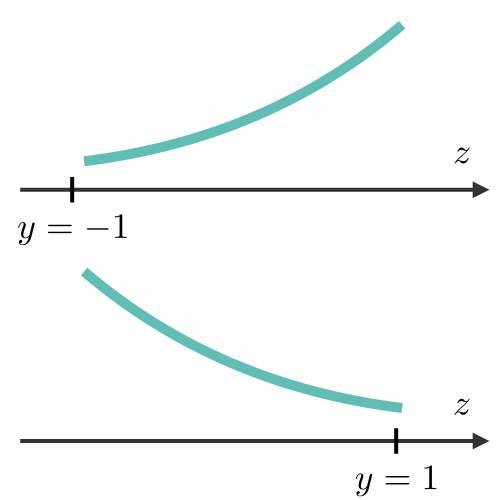 | 附件不支持打印 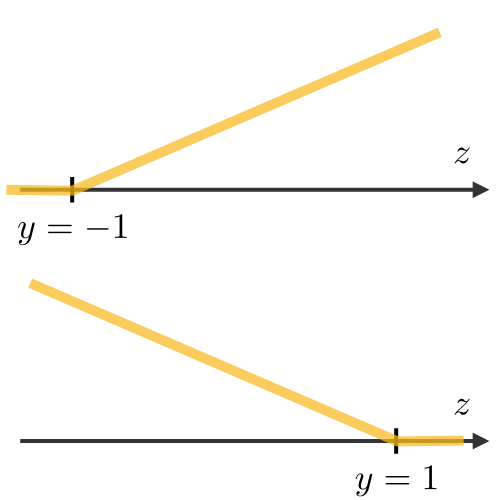 | 附件不支持打印 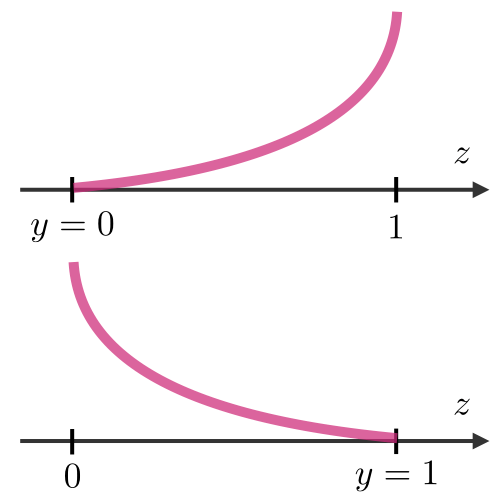 |
| | | |
代价函数
代价函数 通常用于评估模型的性能,由损失函数 定义如下:
梯度下降
记 为学习率,梯度下降的更新规则用学习率和代价函数 表示如下:
备注: 随机梯度下降(SGD)基于每个训练样本更新参数,而批量梯度下降基于一批训练样本更新参数。
似然
给定参数 时,模型 的似然用于通过似然最大化来寻找最优参数 。我们有:
备注: 在实践中,我们使用对数似然 ,因为它更容易优化。
牛顿算法
牛顿算法是一种数值方法,用于找到使 的 。其更新规则如下:
备注: 多维推广,也称为牛顿-拉夫逊方法,其更新规则如下:
线性模型
线性回归
我们在此假设 。
正规方程
记 为设计矩阵,使代价函数最小化的 值有一个闭式解,如下所示:
LMS 算法
记 为学习率,对于包含 个数据点的训练集,最小均方(LMS)算法的更新规则(也称为 Widrow-Hoff 学习规则)如下:
备注: 该更新规则是梯度上升的一个特例。
LWR
局部加权回归(LWR)是线性回归的一种变体,它在代价函数中通过
w(i)(x)
对每个训练样本进行加权,
w(i)(x)
由参数
τ∈R
定义如下:
分类与逻辑回归
Sigmoid 函数
Sigmoid 函数 ,也称为逻辑函数,定义如下:
逻辑回归
我们在此假设 。我们有如下形式:
备注: 逻辑回归没有闭式解。
Softmax 回归
Softmax 回归,也称为多类逻辑回归,用于在结果类别超过 2 个时推广逻辑回归。按照惯例,我们设 ,这使得每个类别 的 Bernoulli 参数 满足:
广义线性模型
指数族
如果一类分布可以用自然参数(也称为典范参数或连接函数)、充分统计量 和对数配分函数 表示如下,则称该类分布属于指数族:
备注: 我们经常会有 。此外,可以看作是一个归一化参数,确保概率之和为一。
最常见的指数分布总结如下表:
| | | | |
| | | | |
| | | | |
| | | | |
| | | | |
GLM 的假设
广义线性模型(GLM)旨在将随机变量 预测为 的函数,并依赖以下 3 个假设:
备注: 普通最小二乘法和逻辑回归是广义线性模型的特例。
支持向量机
支持向量机的目标是找到一条直线,使其到该直线的最小距离最大化。
最优间隔分类器
最优间隔分类器 满足:
其中 是以下优化问题的解:
备注: 决策边界定义为 。
合页损失
合页损失用于 SVM 场景中,定义如下:
核函数
给定特征映射 ,我们定义核函数 如下:
在实践中,由 定义的核函数 称为高斯核,被广泛使用。
备注: 我们说使用“核技巧”来利用核函数计算代价函数,因为我们实际上不需要知道显式的映射 ,它通常非常复杂。相反,只需要 的值。
拉格朗日函数
我们定义拉格朗日函数 如下:
备注: 系数 称为拉格朗日乘子。
生成学习
生成模型首先尝试通过估计 来学习数据是如何生成的,然后我们可以使用贝叶斯规则来估计 。
高斯判别分析
高斯判别分析假设 以及 和 满足:
(3)x∣y=1∼N(μ1,Σ)
估计
下表总结了我们在最大化似然时得到的估计值:
| | |
| | |
朴素贝叶斯
假设
朴素贝叶斯模型假设每个数据点的特征都是相互独立的:
解
最大化对数似然得到以下解:
其中 且 。
备注: 朴素贝叶斯广泛用于文本分类和垃圾邮件检测。
基于树的方法和集成方法
这些方法可用于回归和分类问题。
CART
分类与回归树(CART),通常称为决策树,可以表示为二叉树。它们的优点是具有很好的可解释性。
随机森林
它是一种基于树的技术,使用大量由随机选择的特征集构建的决策树。与简单的决策树相反,它高度不可解释,但其通常良好的性能使其成为一种流行的算法。
备注: 随机森林是一种集成方法。
提升
提升方法的思想是将多个弱学习器组合成一个更强的学习器。主要方法总结如下表:
| |
| |
| |
其他非参数方法
近邻
k
近邻算法,通常称为
k
-NN,是一种非参数方法,其中数据点的响应由其训练集中
k
个邻居的性质决定。它可用于分类和回归场景。
备注: 参数
k
越大,偏差越高;参数
k
越小,方差越高。
学习理论
联合界
设 为 个事件。我们有:
Hoeffding 不等式
设 为从参数为 的伯努利分布中抽取的 个独立同分布变量。设 为它们的样本均值,固定。我们有:
备注: 该不等式也称为 Chernoff 界。
训练误差
对于给定的分类器 ,我们定义训练误差 ,也称为经验风险或经验误差,如下:
可能近似正确(PAC)
PAC 是一个框架,许多学习理论结果都在其下得到证明,它具有以下一组假设:
•
训练集和测试集遵循相同的分布
•
训练样本是独立抽取的
打散
给定集合 和一组分类器 ,如果对于任何标签集 ,我们都有:
则称 打散 。
上界定理
设
H
为一个有限假设类,使得
∣H∣=k
,并设
δ
和样本大小
m
固定。那么,以至少
1−δ
的概率,我们有:
ϵ(h^)⩽(h∈Hminϵ(h))+22m1log(δ2k)
VC 维
给定无限假设类 的 Vapnik-Chervonenkis(VC)维,记为 ,是被 打散的最大集合的大小。
备注: 二维线性分类器集合的 VC 维是 3。
定理(Vapnik)
设
H
给定,
VC(H)=d
,
m
为训练样本数。以至少
1−δ
的概率,我们有:
ϵ(h^)⩽(h∈Hminϵ(h))+O(mdlog(dm)+m1log(δ1))