基于Obsidian 搭建可持续运行的个人AI知识库
很多人的「第二大脑」最终都会走向烂尾:素材随意堆放、链接断裂、信息矛盾、长期缺乏维护,堆积成无法复用的信息垃圾堆。依托Karpathy开源知识库规范,搭配Obsidian可以搭建一套由AI自主录入、自动维护、可供AI持续读取的长效本地Wiki知识库,把知识库维护的人力成本降到最低。
一、5分钟初始化整套Wiki基础框架
搭建流程极简,无需手动创建繁杂文件夹:
在Obsidian中新建一个Vault(知识库根目录);
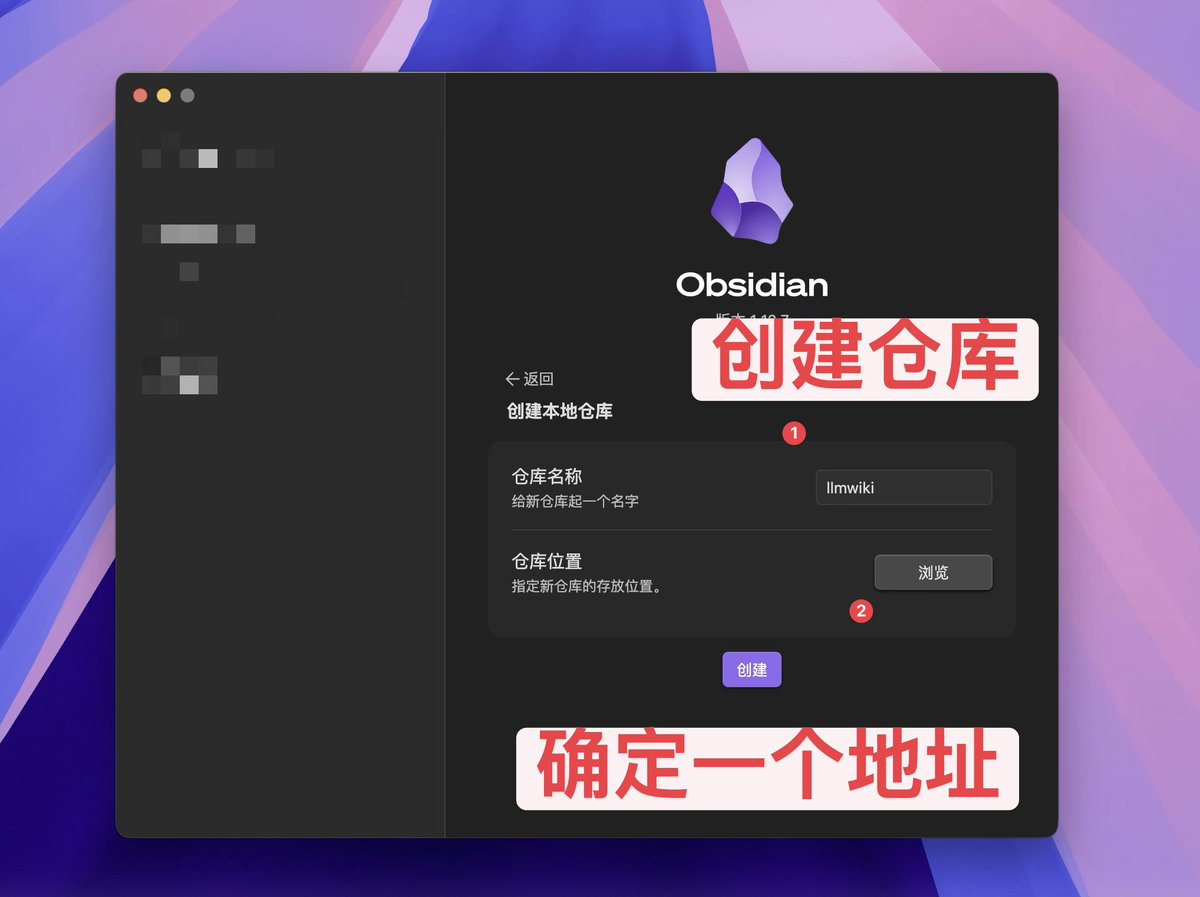
48%
52%
启动Codex,指定该Vault文件夹作为工作目录;
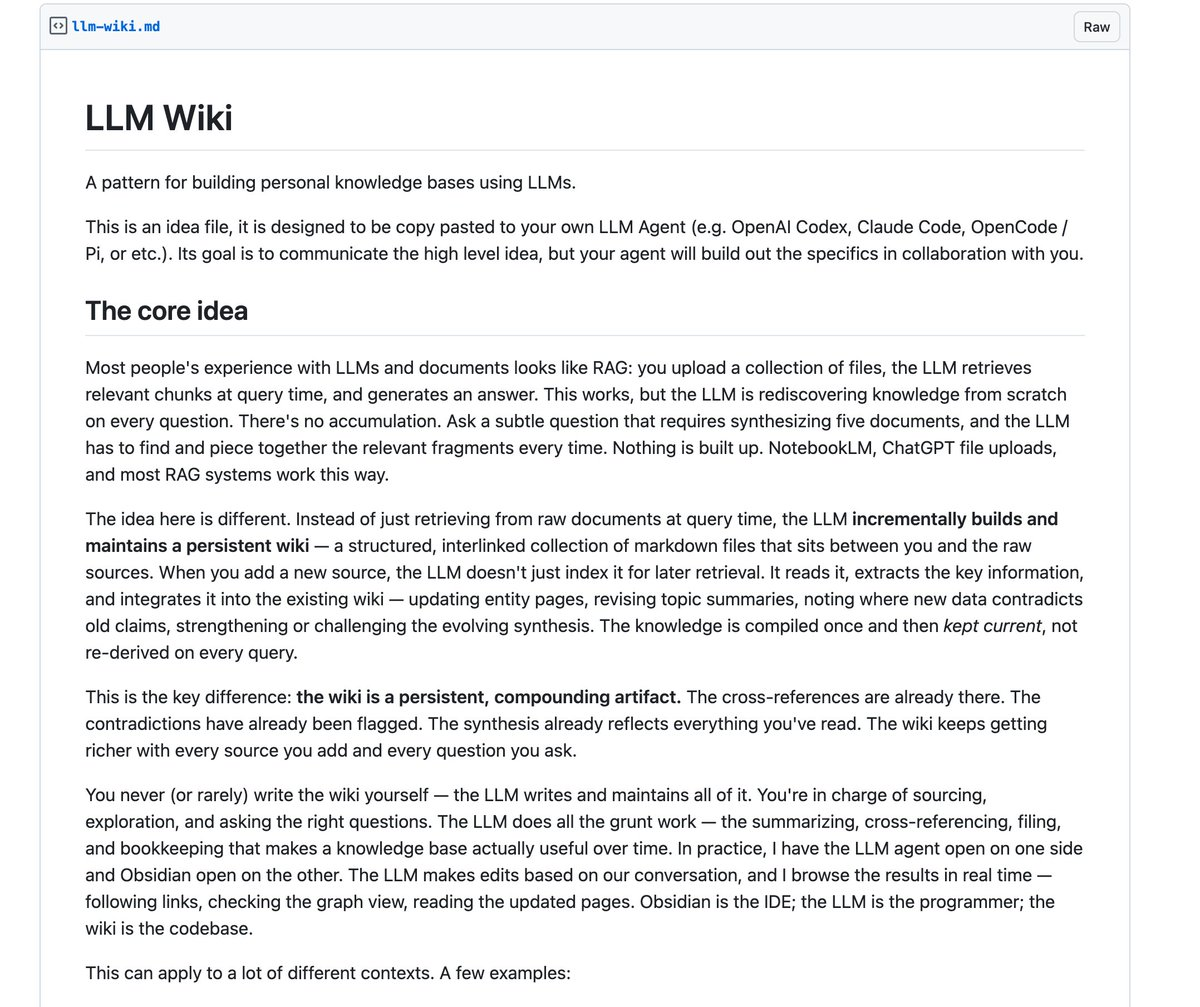
将Karpathy知识库规则文档导入项目:
50%
50%
✅
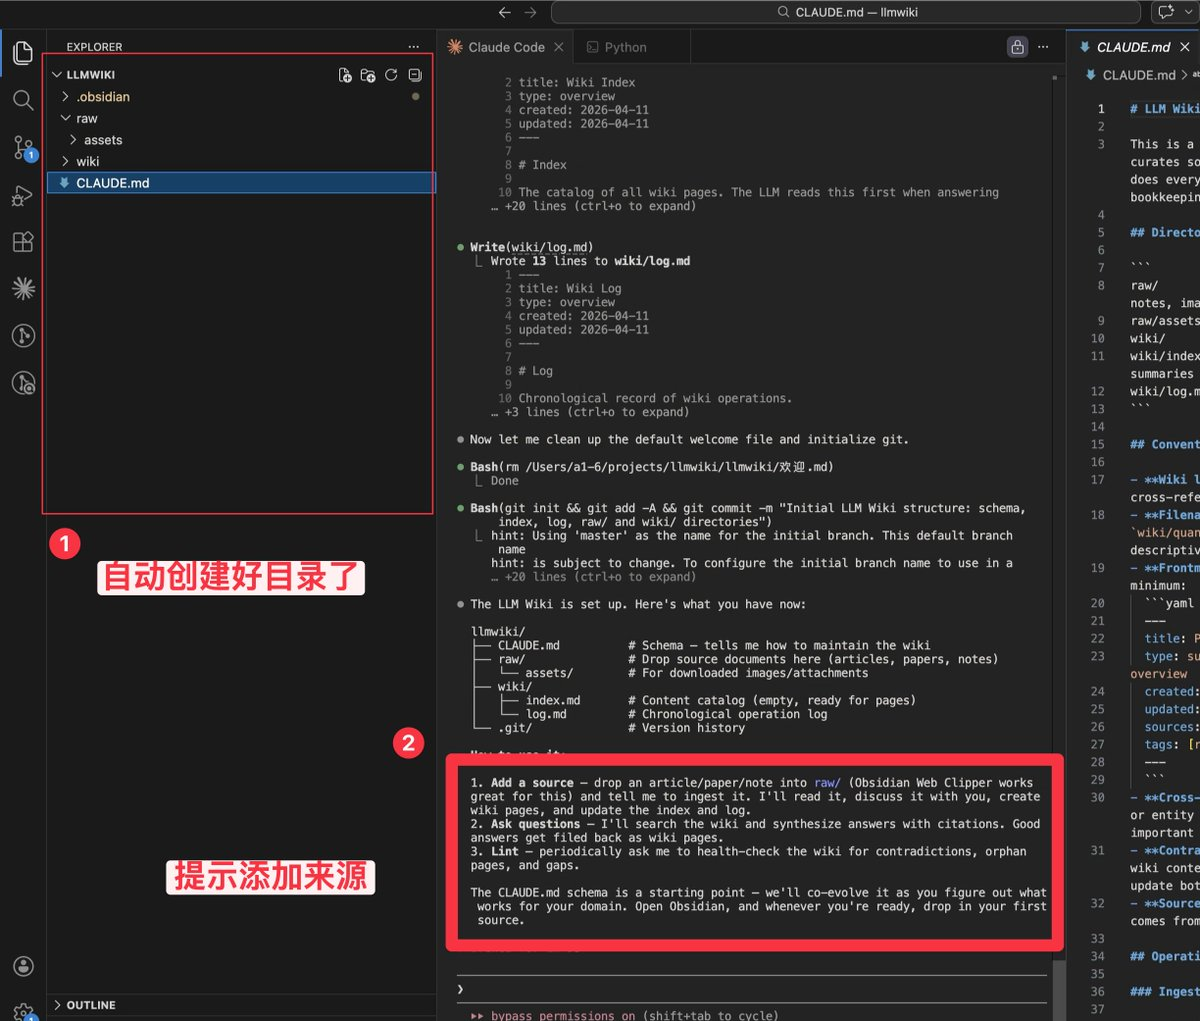
Codex 会自动生成标准化目录:
raw/存放原始素材、wiki/承载结构化知识页面、index.md作为全局索引、shturl持续记录所有变更历史。目录搭建完成后,Claude Code会主动提示:是否录入第一篇素材。
此时仅仅搭建好了目录骨架,系统真正的价值,从导入第一篇正式素材开始体现。
二、自动化知识拆解与双链构建
素材入库存在两种方式:
•
手动收集可以使用Obsidian官方Web Clipper插件,浏览网页时一键将文章保存至raw/目录;
•
长期批量采集,可借助Hermes等具备爬虫能力的AI Agent持续搜集资料,统一存入素材目录。
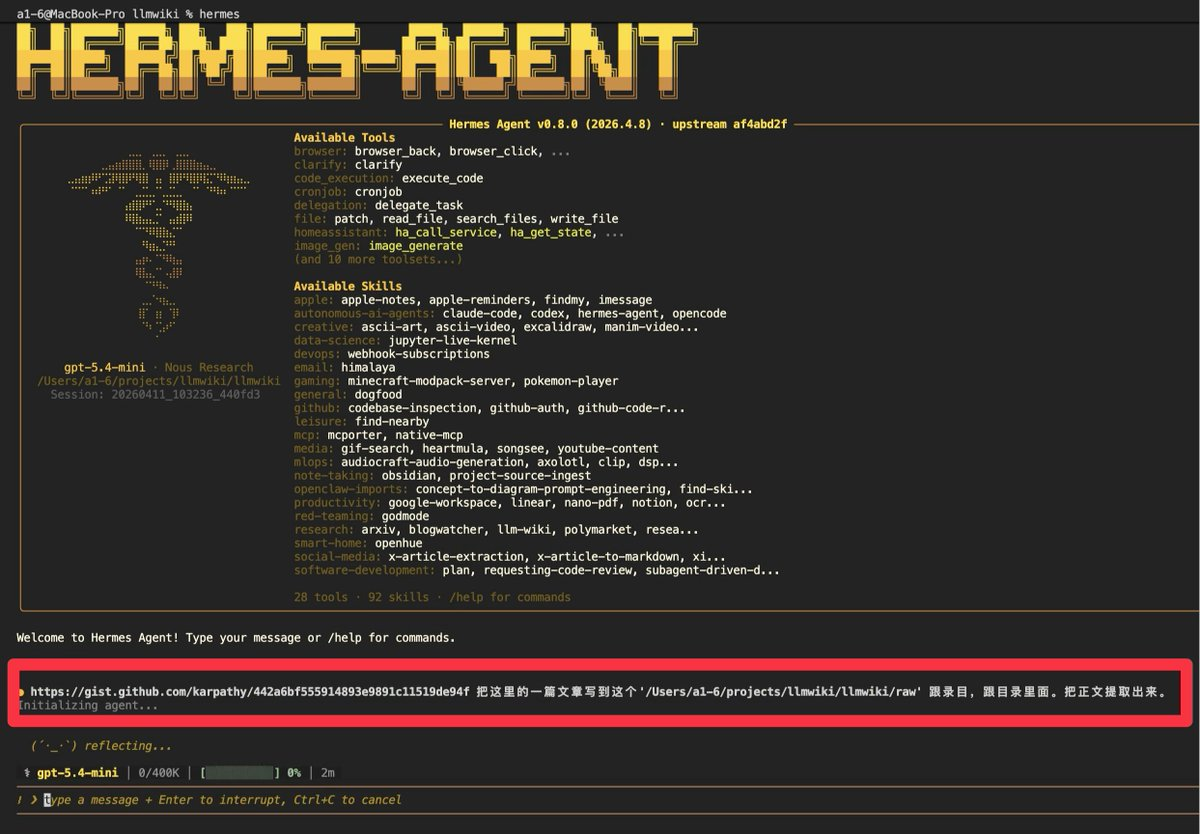
素材就位后,在Claude Code中执行指令:帮我录入最新文章。
AI将全自动完成整套知识加工链路:
通读全文生成文章摘要,提取文中所有核心概念、人物、工具、方法论,为每一项实体单独创建独立Wiki页面;自动生成双向链接,实现素材与概念页面互相引用;同步更新index.md登记新增页面,并在shturl记录入库时间、变更范围。
56%
44%
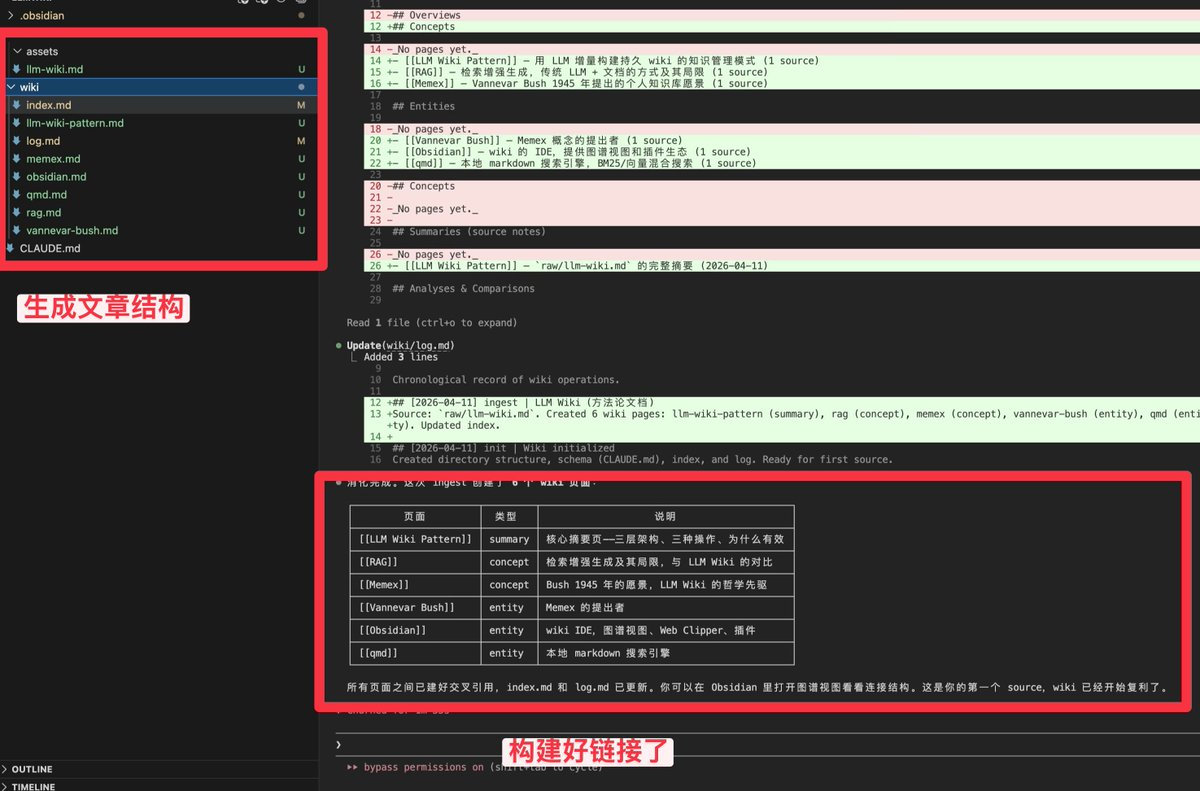
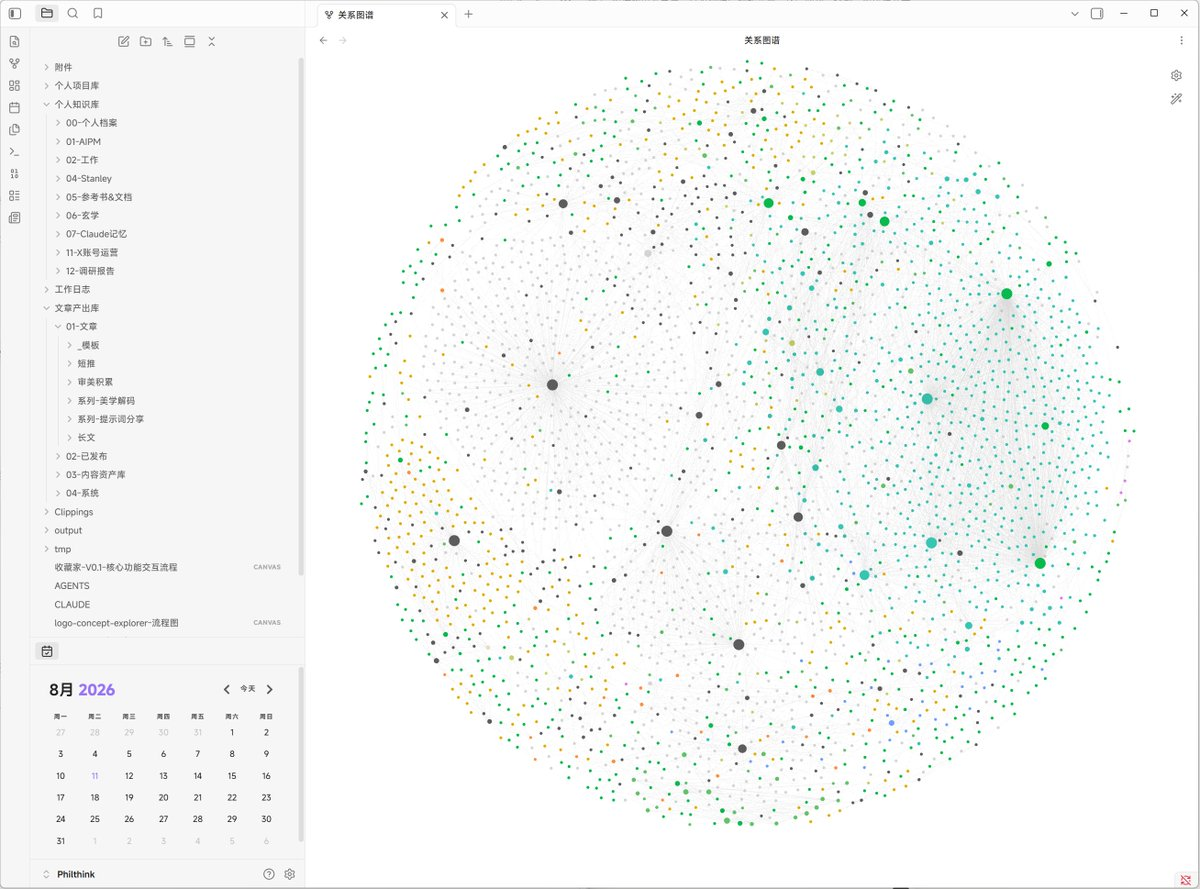
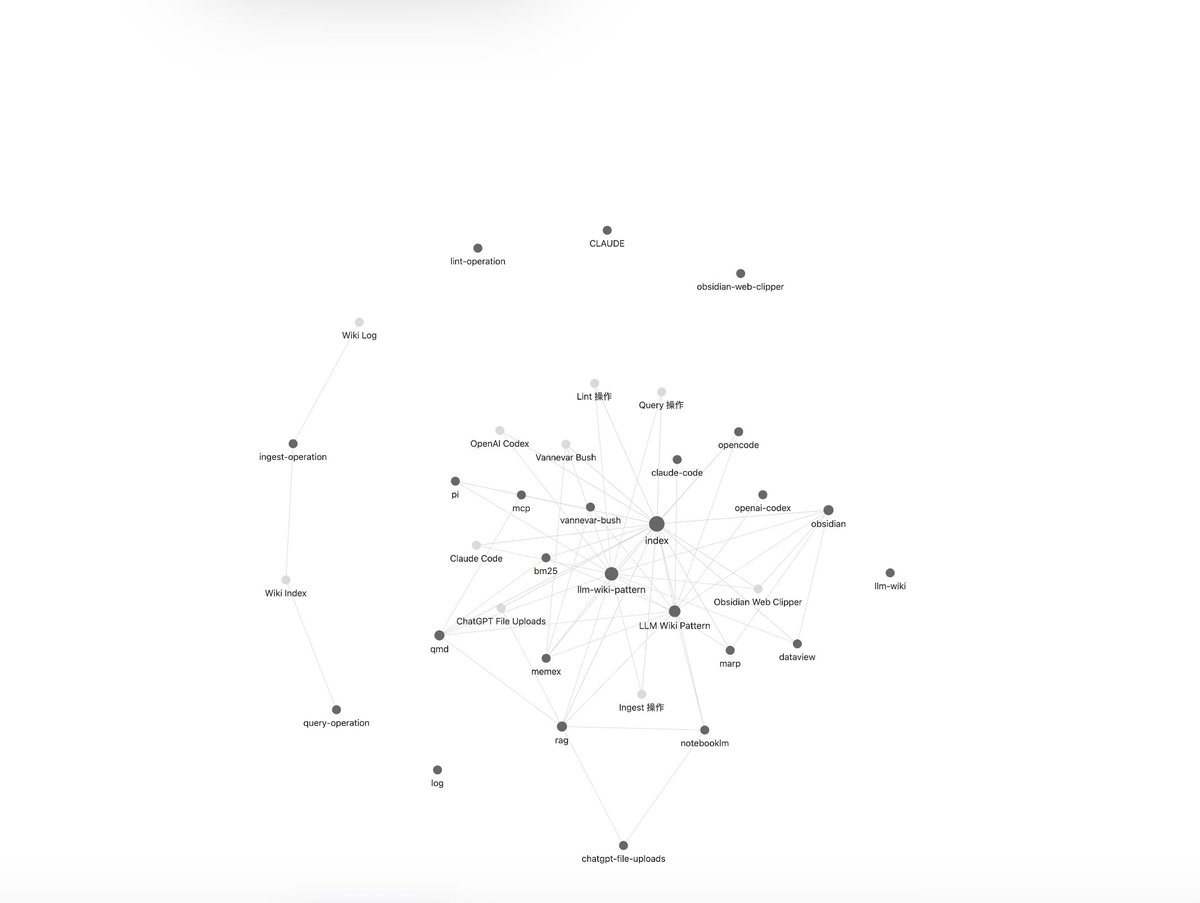
仅仅一条指令,一篇文章就能衍生出十余个关联知识页面。打开Obsidian图谱视图,可以直观看到知识点(节点)与引用关系(连线),零散信息自动形成网状知识结构。使用者只需要持续投喂素材,AI负责完成知识串联、结构化归档。
三、AI自主巡检,解决知识库烂尾核心痛点
所有人都会面临同一个疑问:素材持续增加,知识库会不会再次变成无序垃圾?
Karpathy方案内置一套「Wiki健康检查」机制,专门用来持续维护知识库。
在Claude Code输入指令:帮我检查一下Wiki的健康状况,程序会遍历整个wiki/目录,主动识别四类典型问题:页面观点互相矛盾、无任何引用的孤儿页面、多次提及但尚未建立文档的概念、被新信息推翻的过时内容。
检测完成输出完整问题报告,确认执行修复指令后,自动完成整改。
四、不止是个人笔记,构建AI可读取的私有认知库
知识库的价值,远不止作为个人阅读资料库。
1. 作为个人学习系统
面对陌生领域,直接向系统输入研究主题,Claude Code能够自动拆解多层子概念,逐一生成独立Wiki页面,形成体系化学习脉络。
2. 沉淀独属于你的私有思考
除网络文章外,你可以存入复盘记录、个人观点、项目经验。这类互联网不存在的私有认知,是知识库最核心的资产。长期积累后,AI能够熟悉你的思考习惯、决策偏好、过往踩过的坑,输出内容更加贴合你的需求。
3. 打通AI上下文,告别重复自我介绍
index.md汇总所有知识页面标题与摘要,支持快速导入任意大模型对话窗口,让AI基于你的私有知识库作答,避免模型凭空编造通用信息。
最优方案是将知识库路径写入CLAUDE.md配置文件,约定Agent需要了解你的背景时,自动读取本地Wiki。此后每次对话,AI能够随时调取你的知识沉淀,不必反复解释你的目标、项目与偏好。
同时这套分级查询机制十分节省Token:AI优先读取索引定位相关页面,再加载目标内容,无需一次性灌入全部笔记。
五、长期价值:具备复利效应的认知资产
不可否认,这套系统存在入门门槛。前期搭建仅需5分钟,但知识库需要持续投喂素材,初期内容较少时很难立刻感受到收益。
但我们可以对比两种选择:不搭建私有知识库,每次和AI协作都要重复传递背景信息,大量个人思考无法留存,每隔一段时间就要重建知识体系,最终再次荒废。
而持续运营的Wiki具备复利属性:每新增一份素材,后续所有查询、创作、决策工作都会持续受益。
知识库不是一次性工具,是可以长期迭代、持续增值的个人认知资产。现在新建Vault,导入Karpathy规范,录入第一篇素材,就可以开启属于自己的AI驱动第二大脑。
如果你需要,我可以再精简一版适配知识星球/公众号,增加小标题分割线,更适合直接发布。