Codex+Obsidian:搭建个人知识库保姆级教程
堆栈及其工作原理
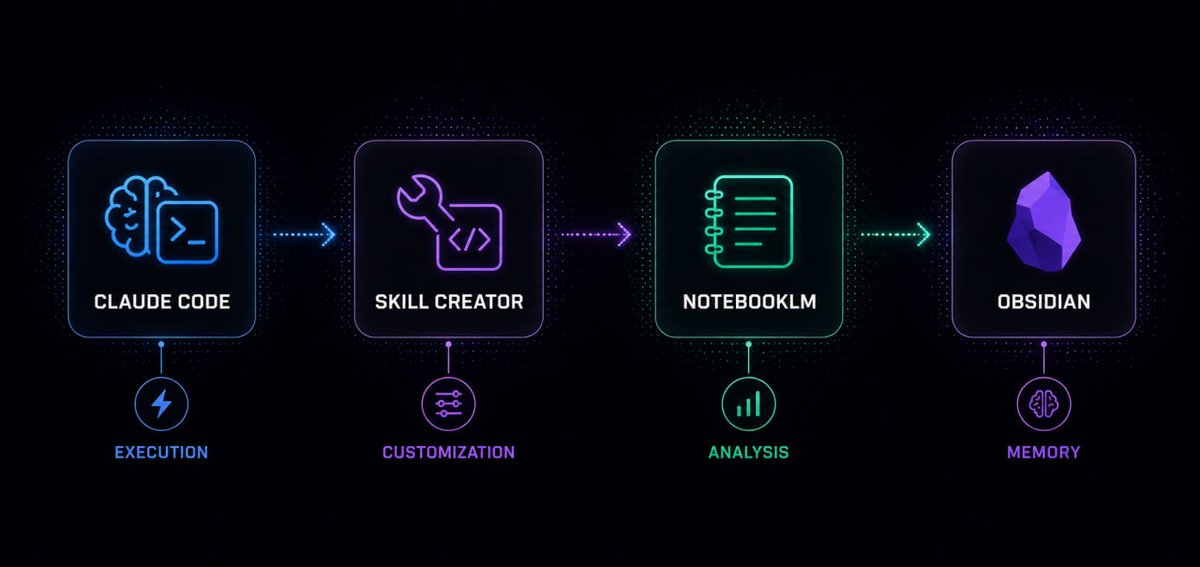
四种工具。每种工具针对问题的不同层面。
•
Codex— 执行引擎。它运行命令、调用技能、管理文件,并协调整个流程。您用通俗语言与它交流,它便为您完成工作。
•
Skills 创建器 — 定制化层。一款Claude Code插件,可让您用自然语言构建可重用的技能。您只需描述所需内容,它便会生成代码并安装该技能。无需编程知识。
•
NotebookLM — 分析引擎。可读取您的资料来源并生成深度分析、摘要、信息图表、抽认卡、播客脚本等。
•
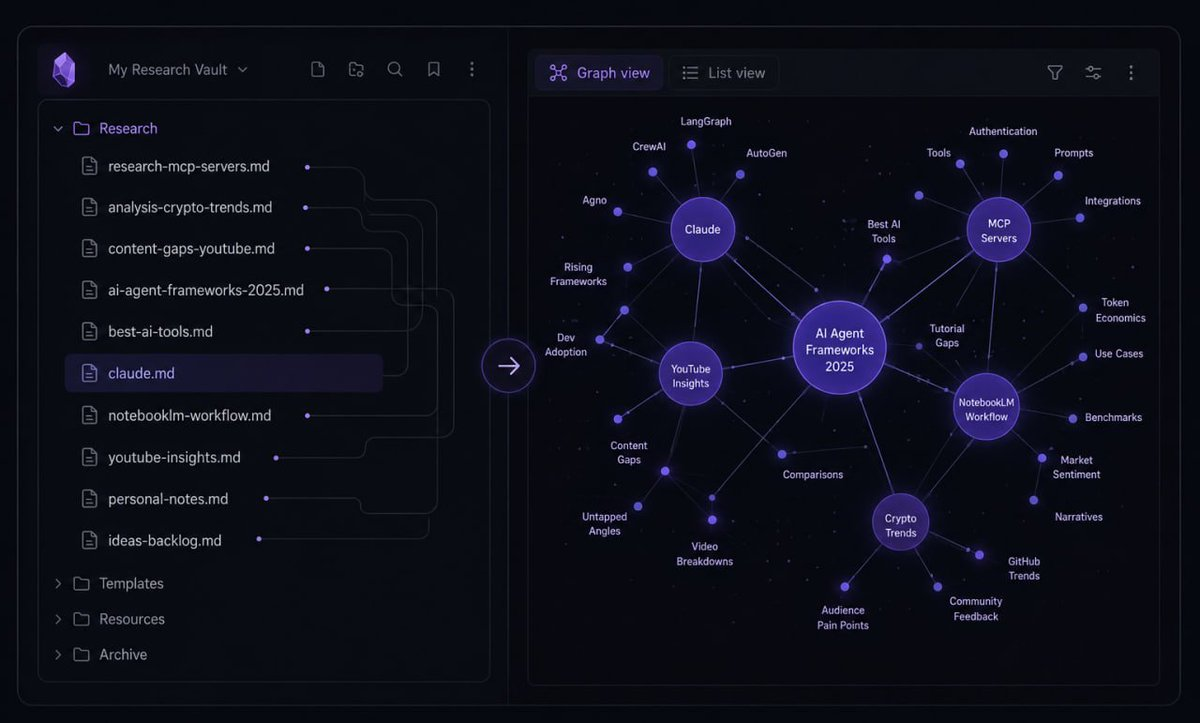
Obsidian — 记忆层。一个基于本地 Markdown 的知识系统,可存储工作流生成的所有内容。随着时间推移,Claude Code会读取这些文件,从而了解你的思考方式、你所关注的事项,以及你希望以何种方式呈现分析结果。
联合:一种按命令执行、大规模分析并随使用而不断改进的研究系统。
步骤1:安装技能创建器
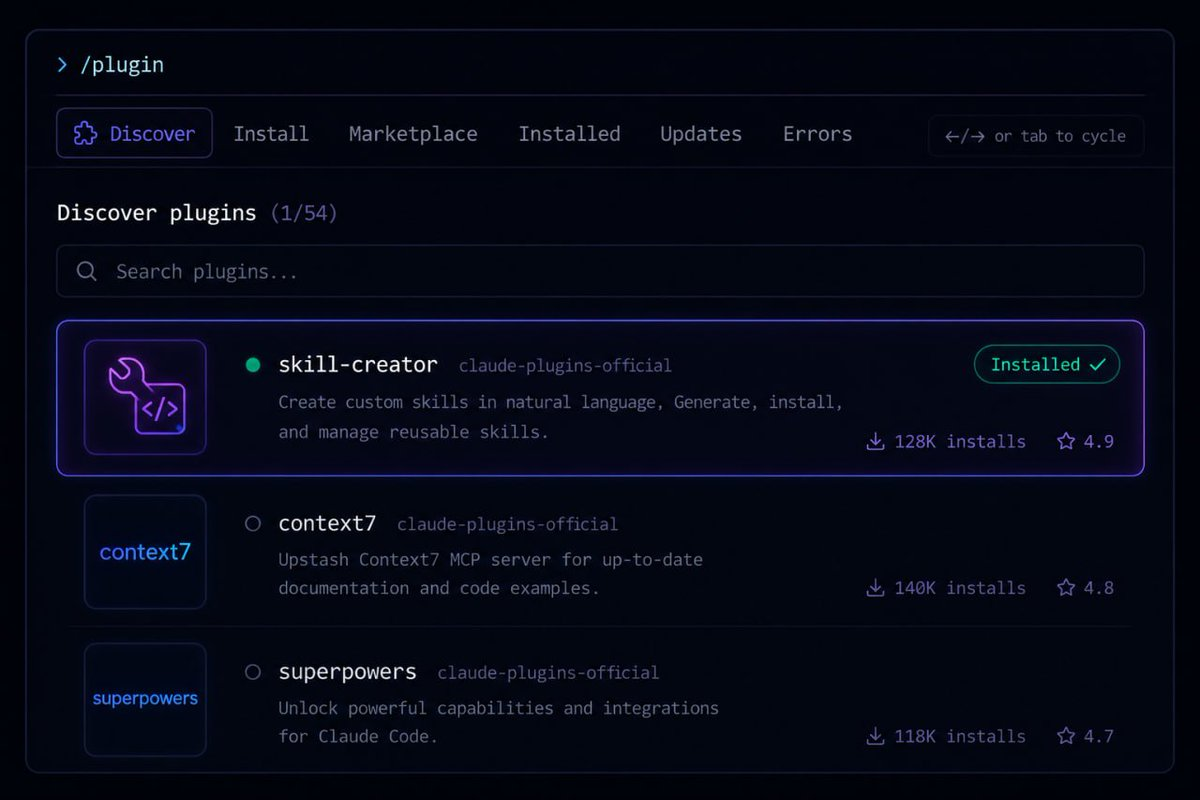
打开Codex。请确保您位于Obsidian保险库文件夹内——这一点对Obsidian识别Claude Code生成的文件至关重要。运行此命令:
/plugin
搜索技能创建者。安装,退出,重新启动Codex。
步骤2:创建小红书搜索技能
这项技能能够搜索小红书并提取结构化的视频数据——标题、频道、订阅者数量、观看次数、上传日期、URL以及互动率。
运行此命令:
代码块
YAML
/ 技能创建器 我要创建一个可搜索 小红书 并返回结构化视频结果的自定义技能。
该技能需满足以下要求:
使用 yt-dlp 工具根据关键词搜索视频;
默认返回前 20 条结果;
每条结果必须包含完整元数据:视频标题、频道名称、频道订阅数、播放量、视频时长、上传日期、视频链接;
默认仅筛选近 6 个月内的视频,同时支持通过 --months 参数自定义时间范围;
自动计算播放量 / 订阅数比率作为视频互动指标;
Claude Code 将生成该技能,安装它并进行确认。现在您已可使用 /yt-search 命令。
步骤3:NotebookLM-py
将Claude Code连接到NotebookLM,我们使用了一个名为notebooklm-py.
仓库:github/teng-lin/notebooklm-py
在您的终端中运行以下命令(不要在Claude Code中运行——请打开一个单独的终端窗口):
代码块
Bash
pip install notebooklm-py
然后进行身份验证:
代码块
Bash
步骤4:创建NotebookLM技能
现在你需要教 Claude Code 如何使用 notebooklm-py。在Claude Code中运行以下内容:
代码块
YAML
/ 技能创建器 请创建一个最大化利用 notebooklm-py 工具的自定义技能。 请参考 GitHub 仓库:github.com/teng-lin/notebooklm-py 进行开发,该技能需支持以下核心功能:
创建全新笔记文档
添加素材来源(YouTube 视频链接、纯文本、本地文件)
对已添加的素材来源执行分析处理
生成各类交付成果:音频概要、思维导图、记忆抽认卡、信息图
这使Claude Code拥有了完整的NotebookLM功能,支持NotebookLM所涵盖的每项操作的命令——每个笔记本最多可包含50个来源,涵盖所有可交付类型。
步骤5:将所有内容整合到一个流水线技能中
这才是工作流真正发挥强大功能的地方。
无需手动执行 小红书 搜索,再将结果发送至NotebookLM,最后请求分析——只需构建一项技能,即可通过一条指令依次完成所有操作。
在Claude Code中运行此代码:
代码块
YAML
/ 技能创建 我要搭建一套小红书 调研流程技能,将油管搜索功能与 NotebookLM 功能结合使用。
启用该流程技能后,执行逻辑如下:
接收你提出的调研主题,调用油管搜索功能,检索出10 个相关视频;
调用 NotebookLM 功能新建笔记文档,将上述视频作为素材源添加至文档中;
结合你下达的调研需求,围绕主题展开分析;
主动询问你是否需要生成交付成果(NotebookLM 支持制作抽认卡、信息图、思维导图、语音概要);若你未指定成果类型,则默认不生成;
分析完成后,将全部内容整理为Markdown 文件保存至知识库,同时在对话窗口直接展示内容;
输出内容中需包含所有油管视频的搜索元数据:所用素材来源、播放量、账号名称、互动率。
运行工作流
代码块
YAML
/ 小红书流程任务 我需要调研2026 年人工智能智能体框架。
目前开发者实际主流选用哪些框架,包括 LangGraph、CrewAI、AutoGen、Agno 以及其他同类工具。
我希望了解:该话题的热门原因、社区中存在的争议点、表现突出
/ 另类的小众框架,以及目前尚未被深入探讨的方向。
请检索10 条相关资料,将其导入新建的 NotebookLM 笔记,完成全面分析,并制作一张展示行业格局的信息图。
主题:AI智能体框架。2026年真正兴起的领域、被过度炒作的领域,以及现有内容中的空白之处。
一份全面分析,涵盖哪些框架正在崛起 vs. 处于平台期,开发者实际抱怨的内容、参与度的异常值,以及迄今无人涉足的内容空白
一张描绘人工智能代理框架格局的信息图
一个直接保存到你的Obsidian知识库中的Markdown文件,所有内容均已结构化并相互链接——随时可用于未来的研究环节
模块化要点
PDF文件- 学术论文、行业报告、白皮书
公共网页- 新闻文章、文档、博客帖子
✔️
工作流模板保持不变。交换源,保留结构。通过白皮书和公开文档研究加密生态系统。借助小红书上的会议演讲分析一项新兴技术。通过分析表现优异的内容,定位一个内容细分市场。利用公开报告研究市场动态。无论用例如何——管道、分析层和内存系统始终保持一致。
您最终将获得
一个研究系统,它:
•
通过单个命令执行完整的研究流程
•
通过NotebookLM将繁重的分析任务卸载至基础设施
•
自动生成结构化交付成果——信息图、思维导图、音频、闪卡
•
将每个结果保存到本地知识库
•
随着时间推移学习您的偏好,并据此改进其输出
30分钟的设置,第一次使用时就能收回成本