把 Codex 变成全栈网页抓取器 | 获得实时网络访问
为什么 AI 辅助开发需要实时网络数据
模型擅长针对给定的上下文进行推理。它们的弱点不是编程,而是训练之后发生变化的信息。文档在不断演进:SDK 会新增参数,API 会弃用端点,认证要求会发生变化,而发布说明里携带的实现细节往往从来不会出现在教程中。
•
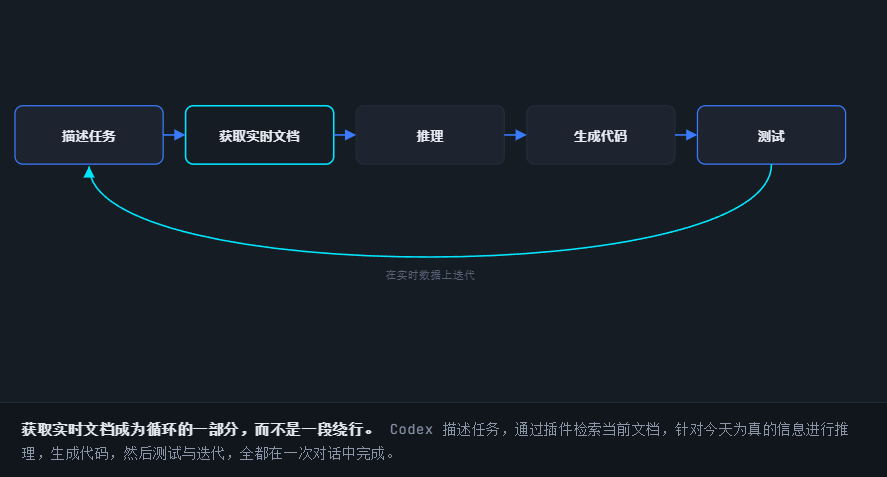
没有实时网络访问,这个循环就是手动的:让 Codex 集成一个 API,得到大体正确的代码,对照当前文档进行比较,把差异粘贴回对话,再重新生成。有了这个插件,Codex 自己就能闭合这个循环。
•
获取实时文档成为循环的一部分,而不是一段绕行。Codex 描述任务,通过插件检索当前文档,针对今天为真的信息进行推理,生成代码,然后测试与迭代,全都在一次对话中完成。
Codex 不再靠人工去收集文档,而是在写下第一行代码之前就检索到当前版本。
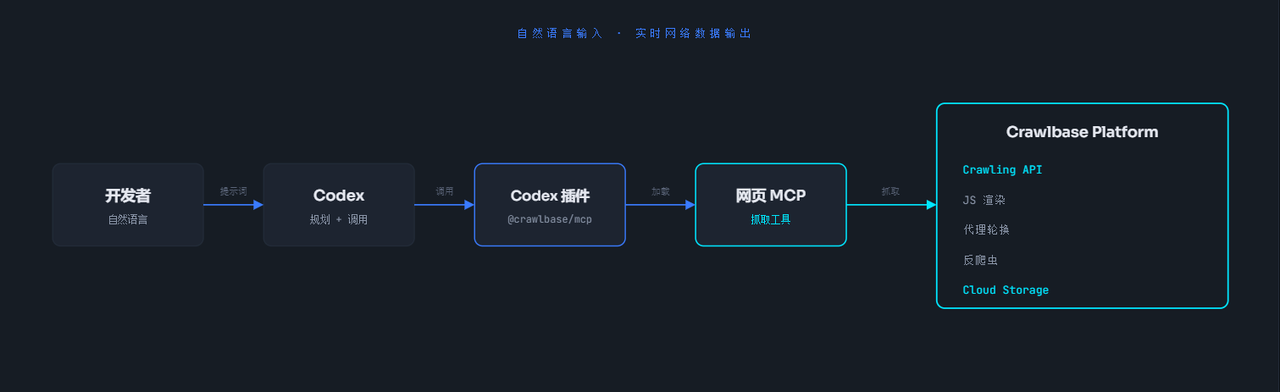
Crawlbase Codex Plugin 是什么
你将构建什么
目标不只是抓取某一个站点,而是构建一套可重复的工程工作流,把实时文档与 AI 辅助开发结合起来。在接下来的五个步骤里,你将安装插件、用冒烟测试验证它、从 GitHub 获取最新的 Web MCP 文档、用这份文档生成一个最小的全栈抓取器,并了解截图和 Cloud Storage 在更大的工作流中处于什么位置。
第 1 步:安装插件
把插件克隆到 Codex 的插件目录中:
代码块
PowerShell
git clone https://github.com/crawlbase/crawlbase-codex-plugin ~/.codex/plugins/crawlbase-mcp
导出你的 Crawlbase API 令牌(如果你还没有账户,请先注册 Crawlbase)。配套仓库包含一个 .env.example,列出了它所需的变量:
代码块
PowerShell
export CRAWLBASE_TOKEN=your_token_hereexport CRAWLBASE_JS_TOKEN=your_js_token_here
重启 Codex。之后插件会显示为 Crawlbase Web Scraper,暴露出诸如 crawl、crawl_markdown、crawl_screenshot 以及各项 Cloud Storage 操作之类的工具。随附的 .mcp.json 会启动 npx -y @crawlbase/mcp 并从环境中读取你的凭据,因此没有任何密钥存在于插件本身之中,这让它在共享的、纳入版本控制的环境里也能保持安全。
第 2 步:用冒烟测试验证
在生成应用代码之前,先确认整条流水线可以正常工作。把 prompts/00-smoke-test.txt 粘贴进 Codex,或者直接询问:
代码块
PowerShell
Get the markdown content of https://example.com
这个请求刻意几乎什么都不做。如果一切都接好了,Codex 会调用 crawl_markdown,返回干净的 Markdown(标题、各级小标题、正文),而不是原始 HTML。这就验证了完整的执行路径:从你的提示词,经过 Codex、插件和 Web MCP Server,一直到 Crawling API。这条路径是本教程其余部分的主干:你描述想要的结果,服务器就把实时的网络内容喂进 Codex 的上下文。如果失败了,请检查 CRAWLBASE_TOKEN 是否已导出,并在安装插件之后重启 Codex。
第 3 步:在写代码之前获取最新文档
与其让 Codex 凭记忆来集成 Crawlbase,不如先把 GitHub 上的当前文档交给它。把 prompts/01-fetch-api-readme.txt 粘贴进 Codex;它会从原始的 GitHub URL 检索 Web MCP 的 README,涵盖环境变量、各个 MCP 工具、store=true、Cloud Storage 的检索方式,以及与令牌相关的存储行为。
训练数据会过时。直接从 GitHub 拉取 README,意味着 Codex 所依据的正是今天 main 分支上的那份文档。如果 README 很大,可以用 store=true 抓取它,之后再用 storage_get 配合 as=markdown 把它取回(参见 Cloud Storage 文档)。
第 4 步:生成全栈抓取器
在上下文中已经有了当前文档,就用 prompts/02-build-full-stack-scraper.txt 让 Codex 生成这个应用。该提示词要求三个层次:
#yGEHStsdbexX text { white-space: pre; }#yGEHStsdbexX .fb0 { stroke: var(--N900-FG, 0.15); }#yGEHStsdbexX .fb0 {stroke: rgba(31,35,41, 0.15)}#yGEHStsdbexX .fx0 { stroke-miterlimit: 10; }#yGEHStsdbexX .fx0 {stroke-miterlimit: 10}#yGEHStsdbexX .fa1 { fill: rgb(187, 191, 196); }#yGEHStsdbexX .fa1 {fill: rgb(187, 191, 196)}#yGEHStsdbexX .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#yGEHStsdbexX .fx1 {font-style: normal}#yGEHStsdbexX .fx2 { text-anchor: middle; }#yGEHStsdbexX .fx2 {text-anchor: middle}#yGEHStsdbexX .fx3 { dominant-baseline: central; }#yGEHStsdbexX .fx3 {dominant-baseline: central}#yGEHStsdbexX .fx4 { stroke: none; }#yGEHStsdbexX .fx4 {stroke: none}#yGEHStsdbexX .fc0 { fill: var(--text-caption); }#yGEHStsdbexX .fc0 {fill: #646a73}#yGEHStsdbexX .fa2 { fill: var(--text-link-disabled); }#yGEHStsdbexX .fa2 {fill: rgb(187, 191, 196)}#yGEHStsdbexX .fa3 { fill: rgb(17, 22, 29); }#yGEHStsdbexX .fa3 {fill: rgb(17, 22, 29)}#yGEHStsdbexX .fx5 { font: 700 12px LarkHackSafariFont, LarkEmojiFont, "JetBrains Mono", -apple-system, BlinkMacSystemFont, "Helvetica Neue", Helvetica, "Noto Sans", Tahoma, "Nimbus Sans L", Arial, "Liberation Sans", "PingFang SC", "Hiragino Sans GB", "Noto Sans CJK SC", "Source Han Sans SC", "Source Han Sans CN", "Microsoft YaHei", "Wenquanyi Micro Hei", "WenQuanYi Zen Hei", STHeiti, SimHei, sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji", system-ui; }#yGEHStsdbexX .fx5 {font-style: normal}#yGEHStsdbexX .fx6 { text-anchor: start; }#yGEHStsdbexX .fx6 {text-anchor: start}#yGEHStsdbexX .fx7 { dominant-baseline: alphabetic; }#yGEHStsdbexX .fx7 {dominant-baseline: alphabetic}#yGEHStsdbexX .fc1 { fill: rgb(138, 149, 168); }#yGEHStsdbexX .fc1 {fill: rgb(138, 149, 168)}#yGEHStsdbexX .fx8 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#yGEHStsdbexX .fx8 {font-style: normal}#yGEHStsdbexX .fc2 { fill: rgb(216, 220, 230); }#yGEHStsdbexX .fc2 {fill: rgb(216, 220, 230)}#yGEHStsdbexX .fx9 { font: 400 12px LarkHackSafariFont, LarkEmojiFont, "JetBrains Mono", -apple-system, BlinkMacSystemFont, "Helvetica Neue", Helvetica, "Noto Sans", Tahoma, "Nimbus Sans L", Arial, "Liberation Sans", "PingFang SC", "Hiragino Sans GB", "Noto Sans CJK SC", "Source Han Sans SC", "Source Han Sans CN", "Microsoft YaHei", "Wenquanyi Micro Hei", "WenQuanYi Zen Hei", STHeiti, SimHei, sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji", system-ui; }#yGEHStsdbexX .fx9 {font-style: normal}#yGEHStsdbexX .fc3 { fill: rgb(0, 230, 255); }#yGEHStsdbexX .fc3 {fill: rgb(0, 230, 255)}#yGEHStsdbexX .fb1 { fill: var(--N900-FG, 0.15); }#yGEHStsdbexX .fb1 {fill: rgba(31,35,41, 0.15)}#yGEHStsdbexX .fb2 { fill: rgb(34, 43, 56); }#yGEHStsdbexX .fb2 {fill: rgb(34, 43, 56)}#yGEHStsdbexX .fa4 { fill: var(--bg-body); }#yGEHStsdbexX .fa4 {fill: #fff}AB1234层次职责后端前端项目,调用 Crawlbase Crawling APIURL 输入框、提交按钮、结果面板README、、、运行说明POST /scrape.env.example.gitignore
现在 Codex 已经有了你的需求、你的项目上下文和最新的文档,因此它是对照当前的 API 参考来生成的,而不是历史训练数据。用 books.toscrape.com 或另一个公开的练习站点来测试这个应用。如果因为站点依赖 JavaScript 而导致返回的 Markdown 为空,就按照你在第 3 步检索到的文档,改用 CRAWLBASE_JS_TOKEN 重试。
第 5 步:用实时网络数据进行迭代
打开 prompts/03-iterate-with-live-data.txt。它汇集了多种工作流:比较 Markdown 输出、捕获截图、用 store=true 存储文档,以及重试由 JavaScript 渲染的页面。到了这一步,调研、实现和调试全都存在于同一次 Codex 对话之中,而不再散落在各个标签页里。
用 Cloud Storage 持久化抓取结果
许多抓取工作流并不会在一次请求之后就结束。你可能需要回访文档、比较页面发生了怎样的变化,或者在不再次访问目标站点的前提下重新处理同一次抓取。在任意一次抓取上设置 store: true,Crawlbase 就不会把页面内联返回,而是把底层的 HTML 保存在 Cloud Storage 中,并返回诸如 rid、stored_at、storage_url 和 token_type 之类的元数据。你可以用以下工具来管理已存储的内容:
•
storage_get 和 storage_bulk_get
•
storage_list 和 storage_count
•
storage_delete 和 storage_bulk_delete
有一个细节值得了解:无论你调用的是 crawl、crawl_markdown 还是 crawl_screenshot,被存储下来的产物始终是底层的 HTML。当你以 Markdown 形式取回一个已存储的页面时,Crawlbase 会在检索时从那份 HTML 现场生成它。截图不会保存在 Cloud Storage 中;它们会通过一个临时的截图 URL 单独返回。
理解存储分区
Cloud Storage 会按抓取时所用的 API 令牌,对抓取到的页面进行分区。用 CRAWLBASE_TOKEN 获取的页面,与用 CRAWLBASE_JS_TOKEN 获取的页面处于不同的存储仓,因为标准抓取和由 JavaScript 渲染的抓取运行在不同的基础设施上。
两个令牌,两个存储仓。每一次抓取响应都会携带一个值为 normal 或 js 的 token_type;把这个相同的值(通过 use_js_token)传给存储工具,你才能查询到页面实际落入的那个分区。
每一次成功的抓取响应都包含一个 token_type 字段(normal 或 js),告诉你文档被存储在了哪里。在之后的存储操作中复用这个值:如果某个页面是用 JavaScript 令牌抓取的,就把 use_js_token: true 传给 storage_get、storage_list 或 storage_bulk_get。一个 "Not found" 响应通常并不意味着文档不见了;它意味着你查询的是错误的分区。查看原始抓取的 token_type,通常就足以找到正确的存储仓。
工程最佳实践
上面的工作流非常适合做原型;而有几项实践能让它在项目成长时依然稳固。
•
在生成集成代码之前先获取当前文档。API 和 SDK 演进得很快,把今天的文档交给模型,能大幅减少已弃用的端点、错误的参数和过时的认证流程。
•
把凭据保存在环境变量中。提交一个 .env.example,让别人知道需要哪些变量,但绝不要提交真实的令牌。
•
存储大型抓取结果,而不是把它们内联进来。对于大型文档页面或数据集,store: true 能让对话保持聚焦,并让你在之后再取回内容。
•
把生成的代码当作生产代码来对待。校验状态码、设置合理的超时,并抛出有意义的错误。无论是否借助 AI,健壮的错误处理才是让一个应用可靠的关键。
随着项目从原型阶段成长起来,并发、重试、监控和基础设施可靠性也开始变得重要;我们关于扩展网页抓取项目的指南涵盖了这些生产层面的考量。
结论
AI 编码助手在能够针对当前信息而非历史训练数据进行推理时,才会发挥出最佳状态。把 Crawlbase Codex Plugin 与 Crawlbase Web MCP Server 搭配起来,就赋予了 Codex 对实时网络内容的直接访问能力:它可以检索文档、提取干净的 Markdown、捕获截图,并依据可获得的最新信息构建应用,全都在一次对话之内。
Crawlbase Web MCP Server
在一次工具调用中,就为 Codex(以及任何 MCP 客户端)提供实时网络访问。每一次抓取都在轮换的住宅 IP 背后渲染 JavaScript,并返回干净的 Markdown,还可选用 Cloud Storage 以便复用。无需代理池,无需无头集群,无需维护抓取代码。获取你的 API 令牌,在免费层级上开始构建。
免费开始
常见问题
Crawlbase Codex Plugin 是什么?
它是一个面向 OpenAI Codex 的扩展,把 Crawlbase Web MCP Server 集成进你的开发工作流。安装之后,Codex 就能通过自然语言提示词来抓取网页、提取干净的 Markdown、捕获截图,并管理 Crawlbase Cloud Storage。你不必自己编写抓取基础设施,而是让 Codex 去检索实时的网络内容,并把它用作代码生成的上下文。
为什么要用 Web MCP Server,而不是让 Codex 生成一个抓取器?
Codex 擅长生成抓取代码,但除非你提供,否则它无法访问实时的站点或文档。这个插件通过 Crawlbase 的基础设施赋予 Codex 实时网络访问能力,因此它能拉取最新的 API 文档、抓取站点、渲染 JavaScript 页面,并依据当前信息(而非可能已经过时的训练数据)来生成代码。
我可以把这个插件用于高度依赖 JavaScript 的网站吗?
可以。它同时支持静态页面和由 JavaScript 渲染的页面。在配置了 CRAWLBASE_JS_TOKEN 之后,Codex 会使用 Crawlbase 的 JavaScript 渲染来抓取动态站点、在脚本运行之后提取内容,并捕获渲染后的截图。
为什么在存储一个页面之后 storage_get 还会返回 "Not found"?
用 CRAWLBASE_TOKEN 抓取的页面,与用 CRAWLBASE_JS_TOKEN 抓取的页面是分开存储的。如果某个页面是用 JavaScript 令牌抓取的,就把 use_js_token: true 传给存储工具。大多数 "Not found" 响应只是意味着你查询的是错误的存储分区,而不是页面不见了。