Codex + Skills 让原始记录自动变成 KPI 与图表
一、痛点:从数据到结论的中间段最贵
真实场景里,数据往往来自多个渠道:CRM 导出、财务表、运营后台。把它们合到一起、算环比、排名次、画趋势,中间这段"加工"最耗人。更麻烦的是,一旦口径变了(比如"营收"要不要含税),整张表要重做。很多人因此干脆不做分析,只堆原始数字,决策层拿到的是原料而非结论。
最佳实践:让 skill 承担"聚合 + 指标 + 可视化 + 叙述"的全链路,人只定义"要看什么",机器产出"看到了什么"。
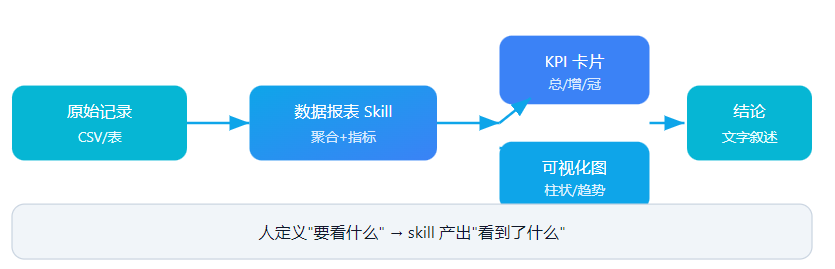
二、方法:指标先行,图表与叙述同源
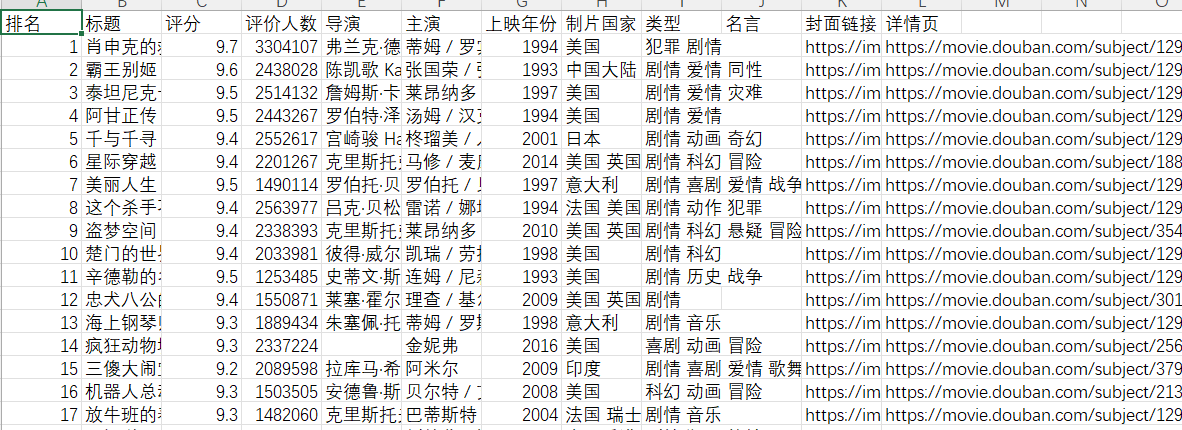
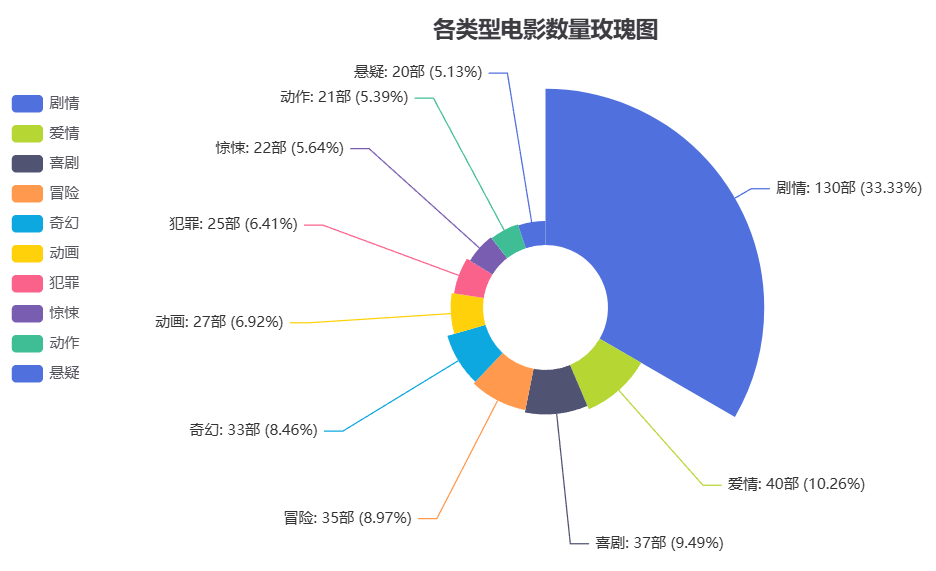
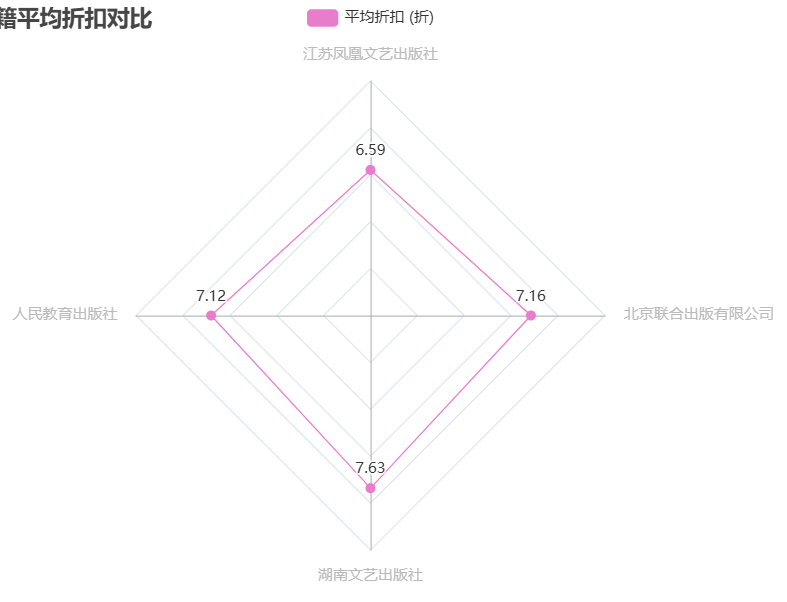
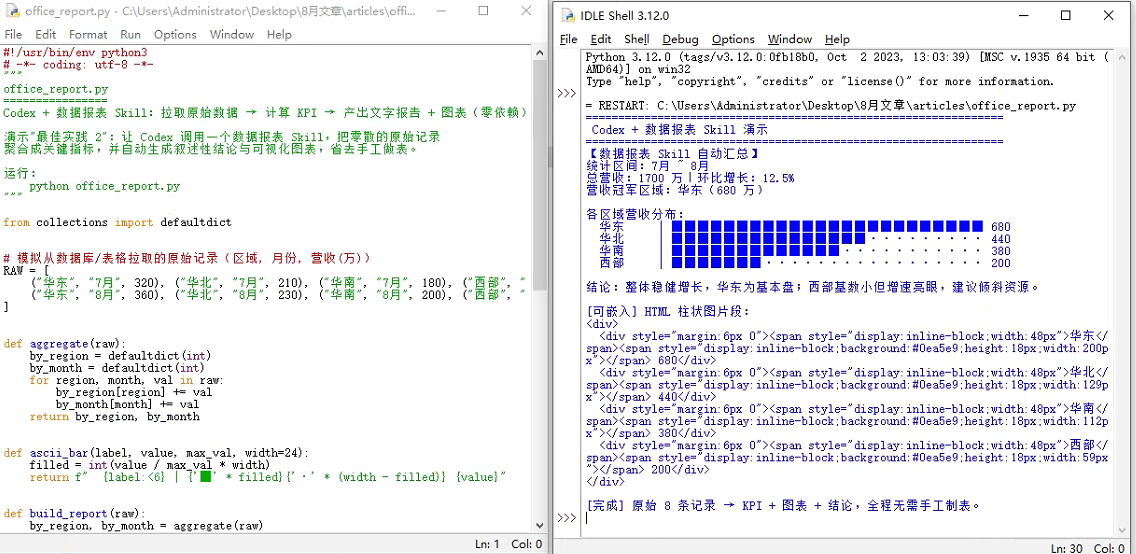
落地时要把"指标定义"和"呈现"解耦。先明确要看哪些 KPI(总额、环比、冠军项、异常项),skill 据此聚合;再让图表和文字叙述都从同一份聚合结果生成,避免"图一个数、文另一个数"的尴尬。下面是一段由 demo 跑出的真实汇总:
39%
34%
27%
50%
50%
报表 skill 还有一个隐性价值:它把"临时问一个数"也标准化了。过去同事问"西部这月涨了多少",你得开表、筛选、再算一遍;现在直接在对话里说"西部环比",skill 调同一套口径返回结果。提问方式统一了,口径就不会因人而异,团队对"数字从哪来"也有了共同信任,扯皮少了、决策快了。
•
把"拉数据 → 算 KPI → 出图 → 写结论"封装成一个可复用的 skill 逻辑,正是本篇方法的代码化身。
三、避坑:口径要写进 skill,而非脑子
报表最容易出问题的不是算错,而是口径不一致。A 月含退税、B 月不含,对比就失真。最佳实践是:把指标口径(计算公式、过滤条件、时间窗)固化为 skill 的配置,所有人跑出来都一样。此外,图表要"自解释"——带数值标签、有单位、有标题,不让看图的人猜。
另外,报表频率要匹配决策节奏:日报看异常、周报看趋势、月报看结构,别用月报粒度去盯日常。把不同频率拆成不同 skill,既省算力也省注意力。Codex 可按定时触发调用对应 skill,让报表像闹钟一样准时出现,而不是等人想起来才做。当"看数"变成零摩擦的日常,数据驱动才真正落地。
最后说一个常见误区:报表 skill 不是越复杂越好。很多团队一上来就堆几十个指标,结果没人看。正确的做法是"少而准"——先锁定老板和业务真正每天盯的那三五个数,把它们做扎实、做稳定,再逐步扩展。skill 的价值在于被用起来,而非功能堆得全。
可执行 Demo:office_report.py
零依赖 Python,内置 8 条原始记录(区域/月份/营收),aggregate 聚合后算出总额、环比、冠军区域,并用 ascii_bar 生成文本柱状图,同时输出可嵌入网页的 HTML 柱状图片段。你跑起来会直接看到一张带结论的报表。
代码块
Go
python office_report.py
#!/usr/bin/env python3# -*- coding: utf-8 -*-"""
office_report.py
================
演示"最佳实践 2":让 Codex 调用一个数据报表 Skill,把零散的原始记录
聚合成关键指标,并自动生成叙述性结论与可视化图表,省去手工做表。
四、总结
数据报表的最佳实践,是把"加工段"彻底交给 skill:指标口径固化、图表与叙述同源、异常自动预警。当每月的营收表、周度的运营看板都变成一条命令的事,团队就从"忙着做表"回到"忙着决策"。