Codex + 剪映自动化剪辑
工作流的底层逻辑
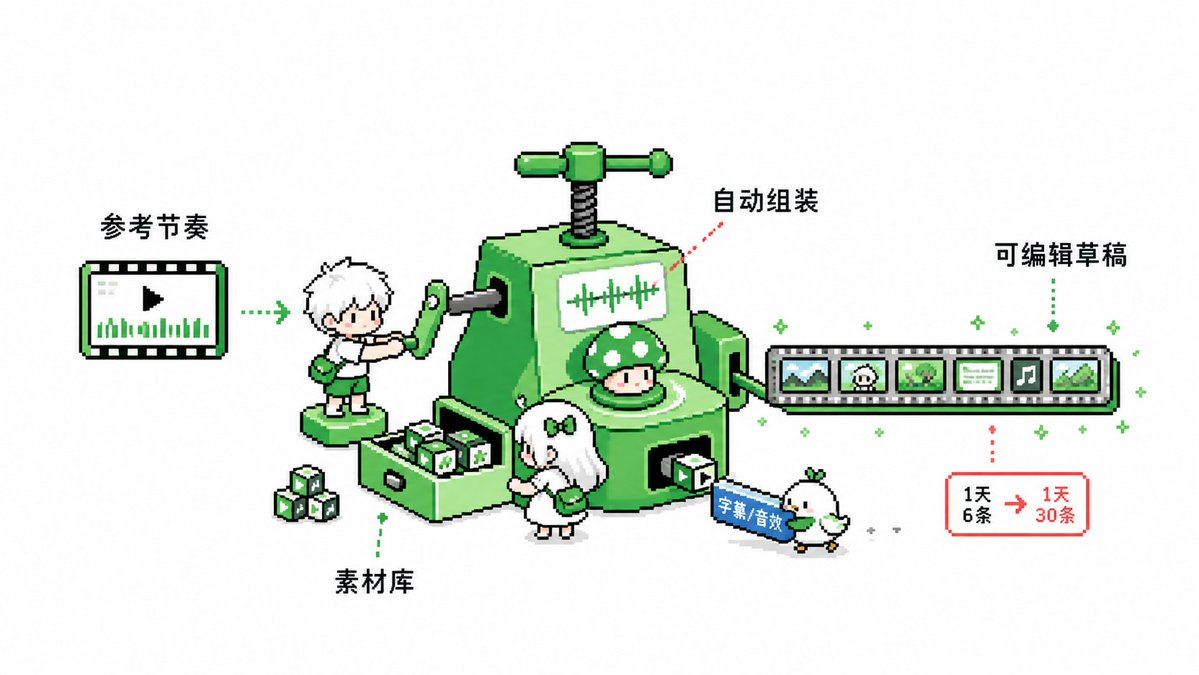
这套工作流的核心,就是抄爆款
Codex会自动识别参考视频的每个镜头切换点,自动从你的素材库里找到最匹配的素材,自动生成配音和字幕,最后直接给你一个可以打开编辑的剪映草稿。
这套工作流的定位是自动生产,不是精品创作。
工作流前期准备
安装对应工具
这套工作流是基于 Codex 实现的,所以你首先需要有 Codex。如果你还没用过 Codex,可以先去看我上周写的Codex入门文章。
具体来说,这套工作流需要这几个核心工具:
•
FFmpeg:用来处理视频拆分、合成、格式转换这些底层操作。这是整个流程的基础,必须要装。
•
Python 环境:因为整套流程是用 Python 写的,至少需要 Python 3.8 以上版本。
•
配音工具:如果你想要自动配音,最稳定的就是字节的豆包语音大模型,费用不高,效果稳定;如果你想要克隆声音就用VoxCPM,这是一个免费开源的声音克隆工具。
•
剪映:最后生成的草稿是剪映格式的,所以你需要在电脑上装一个剪映专业版。
你可以直接把下面这段话复制发给 Codex,让它帮你检查环境并安装缺失的工具:
代码块
Plain Text
请帮我检查视频自动化剪辑需要的环境:
1. 检查 FFmpeg 是否已安装,如果没有请帮我安装
2. 检查 Python 版本是否 >= 3.8,如果没有请帮我安装或升级
3. 检查是否安装了剪映专业版,如果没有请告诉我下载链接
4. 安装 Python 依赖包:opencv-python, numpy, pillow
检查完之后,告诉我哪些已经装好了,哪些需要我手动处理。
配音的话,看你需求。如果说你想做的是电商带货视频,豆包语音模型效果是最稳定的。
它用的是剪映同源的AI配音,基本上在剪映里能找到的配音,在豆包语音模型里都有。定价也不高,平常我们生成一条1分钟左右的视频,配音的费用大概是4-8毛。
如果你想用自己的声音,或者克隆别人的声音,用VoxCPM就行,是一个免费开源的工具。
在Github里面找到这个配音工具,然后把链接发给Codex让它安装就行。
创建文件夹
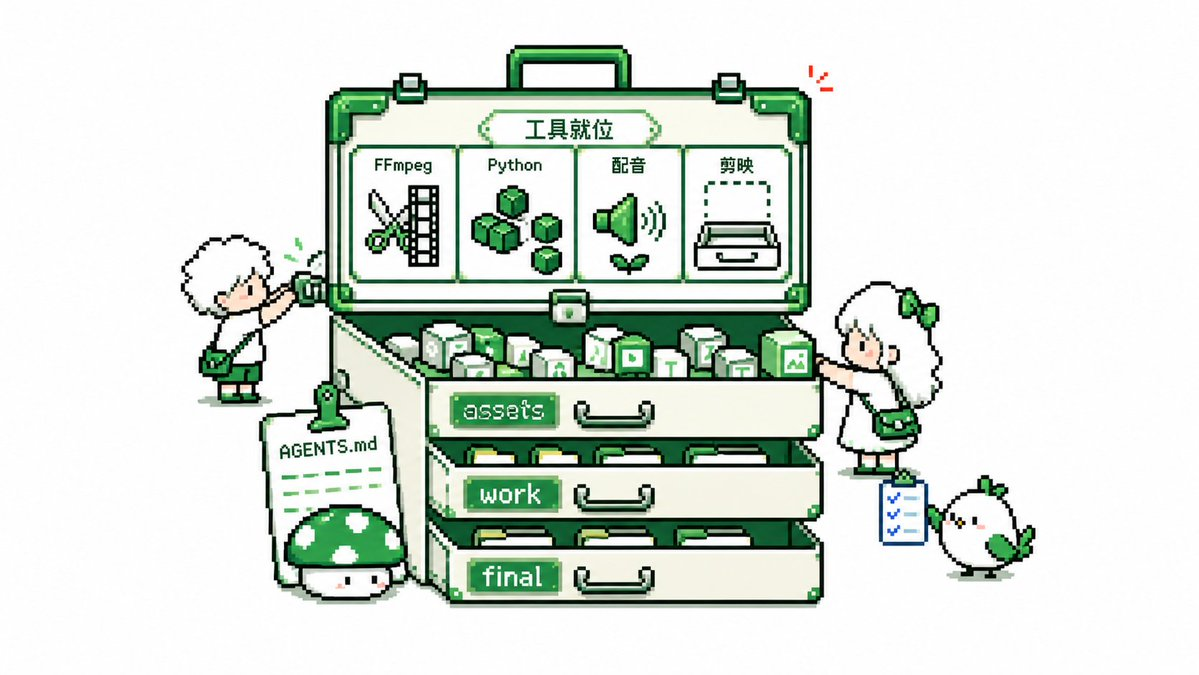
装好这些之后,你需要建一个项目文件夹。我一般是按照这样的结构来组织:
代码块
Plain Text
项目文件夹/
../assets/ # 你的素材库
work/ # 工作区,每次剪辑都在这里建一个日期文件夹
final/ # 最终成品
AGENTS.md # 项目配置文件
•
assets 文件夹就是你的素材库,把所有可能用到的素材都放进去。
•
work 文件夹是工作区,每次你要做一条新视频,就在这里建一个日期文件夹,比如 2026-07-05,然后把参考视频、生成的中间文件、最终的草稿都放在这个文件夹里。
✅
AGENTS.md 是项目的配置文件,里面记录了你这个项目的目标、输出规格、验收标准这些信息。这个文件很重要,因为 Codex 会根据这个文件来理解你的项目需求,然后帮你做出符合要求的视频。
剪辑工作流搭建
拆解参考视频
第一步是拆解参考视频。这一步的核心目的,是把参考视频拆分成一个个独立的镜头,然后提取每个镜头的关键帧,作为后面素材匹配的依据。
你需要先找到一个你想要参考的视频。这个视频可以是爆款视频,也可以是你自己剪过的觉得效果不错的视频。
把它下载下来,放到 work 文件夹里,写一个容易搜索和区分的文件名。
然后把下面这段话复制发给 Codex:
代码块
Plain Text
我需要拆解一个参考视频。
参考视频位置在@(输入你的文件名,Codex会自动搜索)
请帮我完成这几件事:
1. 用 FFmpeg 识别视频的镜头切换点(通过帧间差异分析)
这个 recipe.json 文件,就是后面整个流程的核心依据。
它记录了参考视频的完整结构,后面的素材匹配、配音生成、草稿制作,都是基于这个文件来做的。
拆解完之后,你会在对应文件夹里看到一堆小视频片段和截图。
打开看看,确认一下拆分的镜头是不是合理。如果有些地方切得不太对,比如把一个完整的镜头切成了两段,或者两个镜头没切开,你可以让Codex再调整一下。
但大部分情况下,自动识别的结果都是可以用的。
筛选和匹配素材
传统的做法是你要一个镜头一个镜头地去素材库里翻,找到合适的素材,然后拖到时间线上。这个过程很费时间,而且很容易漏掉一些更合适的素材。
但用这套工作流,你只需要告诉 Codex 你的素材库在哪里,它会自动帮你做视觉匹配。
下面是提示词,你可以直接发给Codex:
代码块
Plain Text
我需要从素材库中匹配替换素材。
项目信息:
- recipe.json 路径:(上一步的拆解路径)/recipe.json
- 素材库路径:../assets/
- 输出路径:work/(你的保存路径)
匹配要求:
1. 读取 recipe.json 中每个镜头的关键帧
2. 遍历素材库,为每个素材提取关键帧
3. 通过颜色、亮度、构图等视觉推荐最匹配的素材(给出置信度得分)
4. 应用这些规则:
- 避免连续3个镜头都用同 - 避免相邻镜头出现明显重复的房间或构图
6. 生成 fragment_plan.json 和 matches.json
7. 把选中的素材复制(不是移动)到 material/fragment01/, fragment02/ 等文件夹
大概的匹配逻辑就是,Codex 会读取参考视频每个镜头的关键帧,然后遍历你的素材库,给每个素材也提取关键帧。然后通过颜色、亮度、构图这些视觉特征,计算每个素材和参考镜头的相似度,给出一个匹配得分。
得分高的素材就会被优先推荐。
还有提示词里面提到的一些规则,都是我在实际使用中总结出来的。如果不加这些限制,自动匹配出来的视频可能会显得很单调,观众一看就知道是机器生成的。
匹配完之后,Codex 会生成一个 fragment_plan.json 和 matches.json。
fragment_plan.json 记录了每个镜头的需求。比如某个镜头需要什么样的场景、什么样的动作、什么样的景别、哪些素材是必须避免的。这个文件是给匹配算法看的。
matches.json 记录了最终的匹配结果。每个镜头用哪个素材、置信度是多少、是不是降级匹配 (找不到完美匹配,用了次优选择)。
匹配完成后,Codex 会把选中的素材复制到对应文件夹里,并且按照参考视频的镜头数量进行分类保存。
生成配音
素材筛选完成以后,下一步就是生成配音。
我们在最开始拆解视频的时候,其实有让Codex提取文案,并且每个文案都有对应镜头。
因为Codex通常使用的是OCR或ASR来提取,准确率很难做到百分之百,所以你需要先检查下文案有没有问题。
没有问题之后,就把下面这段提示词发给Codex:
代码块
Plain Text
我需要为视频生成配音。配音文本是@(你的文案.txt)
要求:
1. 调用豆包 TTS 接口,为每个镜头生成独立的语音文件
2. 读取每个生成的语音文件的实际时长
3. 如果配音时长和参考视频的镜头时长不一致,记录时长差异
4. 将所有片段拼接成完整的配音文件:final_voice.mp3
5. 更新 recipe.json,记录真实的配音时长
Codex 会读取每个语音文件的实际时长,然后调整视频的节奏。
比如某个镜头的配音实际读了 5 秒,但参考视频里这个镜头只有 3 秒,那最终生成的视频里,这个镜头会被拉长到 5 秒,保证配音和画面对齐。
生成样稿和剪映草稿
剪映草稿的生成是这套流程里最复杂的部分,因为剪映的草稿格式很严格,素材路径、时间轴、元数据 ID 这些信息必须完全准确,否则打开会报错或者显示不正常。
我在这里踩了很多坑。比如剪映草稿里有三个关键的 ID:内容 ID、元数据 ID、根索引 ID,这三个必须一致,而且不能和已有的草稿重复。如果 ID 冲突了,要么打开失败,要么会覆盖掉你之前的草稿。
还有素材路径的问题。剪映草稿里记录的素材路径必须是绝对路径,而且文件必须真实存在。如果你移动了素材文件,草稿就打不开了。
避免这些问题的规则,我都写在了提示词里面,你直接复制就可以。
代码块
Plain Text
我需要生成最终的视频和剪映草稿。
第一次生成会比较久,大概十几分钟。完成以后,你可以打开剪映检查一下。
主要检查这几个点:
•
草稿能不能正常打开?
•
素材是不是都能正常显示?
•
时间轴对不对?每个镜头的时长和顺序是不是和预期一致?
•
字幕对不对?有没有遮挡关键内容?
•
配音和画面是不是同步?
如果有问题,回到前面的步骤检查,看是素材匹配的问题,还是配音生成的问题,还是草稿格式的问题。
代码块
Markdown
# AGENTS.md
## 目标