第21章:广告点击事件聚合
简介
数字广告随着Facebook、YouTube、TikTok等平台的兴起,已成为一个庞大的产业。
因此,跟踪广告点击事件至关重要。在本章中,我们将探讨如何设计一个广告点击事件聚合系统,以满足 Facebook/Google 级别的规模需求。
数字广告有一个名为实时竞价(RTB)的流程,用于买卖数字广告资源:
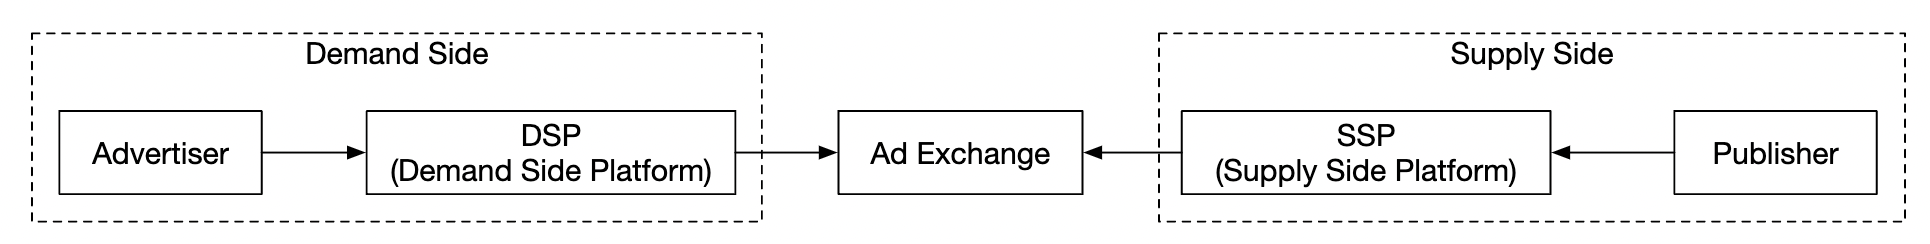
RTB 的响应速度至关重要,因为它通常在一秒内完成。数据的准确性同样非常重要,因为它直接影响广告主的出价金额。
基于广告点击事件的聚合数据,广告主可以做出诸如调整目标受众和关键词等决策。
第一步:理解问题并明确设计范围
•
C:输入数据的格式是什么?
•
I:每天有10亿次广告点击,广告总数为200万。广告点击事件数量同比每年增长30%。
•
C:我们的系统需要支持哪些最重要的查询?
•
I:需要重点考虑的查询:
◦
返回广告X在最近Y分钟内的点击事件数量
◦
返回过去1分钟内点击量最高的100条广告。两个参数均应支持配置。每分钟进行一次聚合。
◦
支持按以下条件进行数据过滤ip, user_id, country用于上述查询
•
C:我们需要担心边界情况吗?我能想到的有:
◦
可能会有一些事件到达的时间晚于预期
◦
可能会出现重复事件
◦
系统的不同部分可能会出现故障,因此我们需要考虑系统恢复方案
•
我:这是一份不错的清单,可以考虑一下
•
C:对时延有何要求?
•
一:广告点击聚合的端到端延迟为几分钟。而对于实时竞价(RTB),这一延迟通常不到一秒。由于广告点击聚合主要用于计费和报表,因此承受这样的延迟是完全可以接受的。
Functional requirements
•
这是一个 GitHub 仓库页面,标题为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”。上下文。
•
返回点击量最高的前100名ad_id每分钟
•
支持按不同属性进行聚合过滤
•
数据集规模达到Facebook或Google级别
Non-functional requirements
•
聚合结果的正确性至关重要,因为它用于实时竞价和广告计费
•
妥善处理延迟或重复的事件
•
健壮性——系统应能从容应对部分故障
•
延迟——端到端延迟最多几分钟
Back-of-the-envelope estimation
•
10亿DAU
•
假设用户每天点击1则广告 -> 每天10亿次广告点击
•
广告点击QPS = 10,000
•
峰值QPS是该数值的5倍 = 50,000
•
单次广告点击占用0.1KB存储空间,每日存储需求为100GB
•
月存储量 = 3TB
步骤2:提出高层次设计方案并获得认可
在本节中,我们将讨论查询API的设计、数据模型以及系统总体设计。
Query API Design
API 是客户端与服务器之间的契约。在我们的场景中,客户端即仪表板的用户——数据科学家、分析师、广告主等。
以下是我们的功能需求:
•
汇总ad_id过去Y分钟内的点击次数
•
返回过去M分钟内点击次数最多的前N个ad_id
•
支持按不同属性进行聚合过滤
我们需要两个端点来满足这些需求。其中的一个端点可以通过查询参数实现过滤。
统计过去M分钟内某个广告ID的点击总数:
查询参数:
响应:
•
from - 开始分钟。默认为当前时间减1分钟
•
ad_id - 广告标识符
•
to - 结束分钟。默认为当前时间
•
计数——起始分钟与结束分钟之间的聚合计数
•
filter - 用于区分不同过滤策略的标识符。例如,001表示“非美国地区的点击”。
返回过去M分钟内点击次数最多的前N个广告ID
代码块
Plain Text
GET /v1/ads/popular_ads
查询参数:
•
计数——点击次数最多的前N个广告
•
窗口——聚合窗口大小,单位为分钟
•
filter - 不同过滤策略的标识符
响应:
•
广告ID列表
Data model
在我们的系统中,我们有原始数据和聚合数据。
原始数据如下:
代码块
Plain Text
[AdClickEvent] ad001, 2021-01-01 00:00:01, user 1, 207.148.22.22, USA
以下是结构化格式的示例:
以下是聚合后的版本:
这filter_id有助于我们实现过滤需求。
为了支持快速返回过去M分钟内点击量最高的前N个广告,我们还将维护如下结构:
存储原始数据与存储聚合数据各有哪些优缺点?
•
原始数据能够充分利用全量数据集,并支持数据筛选与重新计算
•
另一方面,聚合数据使我们能够拥有更小的数据集,并实现更快的查询
•
原始数据意味着更大的数据存储和更慢的查询
•
然而,聚合数据是派生数据,因此会存在一定的数据损失。
在我们的设计中,我们将结合使用这两种方法:
•
为便于调试,最好保留原始数据。如果聚合过程中出现错误,我们就能及时发现并进行补全。
•
为了提升查询性能,还应存储聚合后的数据。
•
原始数据可以存储在冷存储中,以避免额外的存储成本。
在数据库方面,需要考虑以下几个因素:
•
数据的结构是怎样的?是关系型、文档型还是二进制大对象(Blob)类型?
•
工作负载是读多、写多,还是两者兼有?
•
是否需要事务?
•
查询是否依赖于诸如SUM、COUNT之类的OLAP函数?
从原始数据来看,平均QPS为1万,峰值QPS达5万,因此系统属于写多读少的场景。另一方面,由于原始数据主要用于在发生故障时作为备份,读流量相对较低。
另一种选择是使用 Amazon S3,并搭配 ORC、Parquet 或 AVRO 等列式数据格式。由于这种方案较为陌生,我们暂且采用 Cassandra。
关系型数据库也能胜任,但其写入扩展往往颇具挑战。作为替代方案,我们也可以选用 Cassandra 或 InfluxDB,它们对高负载的写入场景具有更原生的支持。
对于聚合数据而言,由于仪表盘和告警会频繁查询聚合后的数据,因此工作负载同时以读取和写入为主。此外,由于聚合服务每分钟都会对数据进行聚合并写入,写入压力也较大。因此,此处我们同样采用同一套数据存储(Cassandra)。
High-level design
我们的系统架构如下:
数据在输入和输出端均以无界数据流的形式流动。
为避免出现同步式数据接收端,以免某个消费者崩溃导致整个系统停滞,我们将借助消息队列(如 Kafka)实现异步处理,从而解耦消费者与生产者。
第一个消息队列存储广告点击事件数据:
第二个消息队列包含按分钟聚合的广告点击次数:
以及按分钟聚合的点击量排名前N的广告:
第二个消息队列的存在是为了实现端到端的精确一次原子性提交语义:
对于聚合服务而言,使用MapReduce框架是一个不错的选择:
43%
57%
每个节点只负责一项任务,并将处理结果发送给下游节点。
映射节点负责从数据源读取数据,然后对数据进行过滤和转换。
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
或者,我们也可以将广告数据分散到 Kafka 的各个分区,并让聚合节点在消费者组内直接进行订阅。不过,映射节点使我们能够在后续处理之前对数据进行清洗或转换。
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。 ad_id
聚合节点按统计广告点击事件ad_id每分钟在内存中进行。
归约节点从聚合节点收集汇总结果,并生成最终结果:
该DAG模型采用MapReduce范式,能够处理海量数据,并借助并行分布式计算将其转化为常规规模的数据。
在DAG模型中,中间数据存储在内存中,各个节点之间通过TCP或共享内存进行通信。
让我们来探讨一下,这种模型如何帮助我们实现各种应用场景。
用例1 - 聚合点击次数:
•
Ads are partitioned using ad_id % 3
用例2 - 返回点击次数最多的前N个广告:
•
在本例中,我们聚合了排名前3的广告,但这一方法可轻松扩展为聚合排名前N的广告
•
每个节点都维护一个堆数据结构,以便快速检索排名前N的广告
用例3 - 数据过滤:为了支持快速的数据过滤,我们可以预先定义过滤条件,并据此进行预聚合:
这种技术被称为星型模式,在数据仓库中被广泛使用。用于筛选的字段被称为维度.
这种方法具有以下优势:
•
易于理解和实现
•
当前的聚合服务可以复用,用于在星型模式中构建更多维度。
•
基于筛选条件的数据访问速度很快,因为结果已预先计算
这种方法的一个局限性在于,它会生成更多的桶和记录,尤其是在我们有大量筛选条件时。
步骤3:设计深度剖析
让我们深入探讨一些更有趣的话题。
Streaming vs. Batching
我们提出的高层次架构属于一种流处理系统。以下是三类系统的对比:
在我们的设计中,我们采用了批处理与流式处理相结合的方式。
我们采用流式处理来实时接收并处理数据,从而近乎实时地生成聚合结果。而针对历史数据的备份,则采用了批处理方式。
一种同时包含批处理与流式处理两条数据处理路径的系统,这种架构被称为Lambda架构。其缺点在于需要维护两条各具独立代码库的处理路径。
Kappa是一种替代架构,它将批处理与流处理整合到一条处理路径中。其核心思想是使用单一的流处理引擎。
Lambda架构:
Kappa架构:
我们的高层次设计采用Kappa架构,因为历史数据的重新处理同样会经过聚合服务。
每当由于聚合逻辑中的重大缺陷等原因需要重新计算聚合数据时,我们都可以基于所存储的原始数据重新进行聚合计算。
•
重新计算服务从原始存储中获取数据。这是一项批处理任务。
•
检索到的数据会被发送至专用的聚合服务,从而避免对实时处理聚合服务造成影响。
•
聚合后的结果会被发送到第二个消息队列,随后我们在聚合数据库中更新这些结果。
Time
我们需要一个时间戳来进行聚合。它可以在两个地方生成:
•
事件时间——广告点击发生的时间
•
处理时间——即服务器处理该事件时的系统时间
由于采用了异步处理(消息队列)和网络延迟,事件时间与处理时间之间可能存在显著差异。
•
如果使用处理时间,聚合结果可能会不准确
•
如果使用事件时间,我们就必须处理延迟事件
没有完美的解决方案,我们需要权衡取舍:
由于数据准确性至关重要,我们将采用事件时间进行聚合。
为缓解事件延迟问题,可以采用一种称为“水印”的技术。
在下面的示例中,事件2错过了它应当被聚合的时间窗口:
然而,如果我们有意延长聚合窗口,就能降低漏报事件的概率。窗口中被延长的部分被称为“水印”:
•
较短的水印会增加事件遗漏的可能性,但能降低延迟
•
较长的水印会降低事件遗漏的可能性,但会增加延迟
无论水印的大小如何,都始终存在事件遗漏的可能性。但针对这种低概率事件进行优化并无意义。
我们可以通过每日收盘后的对账来解决此类不一致问题。
Aggregation window
窗口函数共有四种类型:
•
滚动(固定)窗口
•
滑动窗口
•
滑动窗口
•
会话窗口
在我们的设计中,我们利用滚动窗口进行广告点击的聚合:
同时,我们还使用滑动窗口来统计M分钟内点击量排名前N的广告:
Delivery guarantees
由于我们所聚合的数据将用于计费,因此数据准确性至关重要。
因此,我们需要讨论:
•
如何避免处理重复事件
•
如何确保所有事件都被处理
我们可以采用三种交付保障机制——最多一次、至少一次和恰好一次。
在大多数情况下,只要能容忍少量重复,至少一次语义就已足够。然而,对于我们的系统而言并非如此——即使只有微小的差异,也可能导致数百万美元的账目不一致。因此,我们必须采用恰好一次的交付语义。
Data deduplication
最常见的数据质量问题之一是数据重复。
它可能来自多种不同的来源:
•
客户端——客户端可能会多次重发同一事件。对于出于恶意目的而重复发送的事件,最好由风险引擎进行处理。
•
服务器宕机——在聚合过程中,某个聚合服务节点发生故障,而上游服务尚未收到确认,因此事件被重新发送。
以下是由于在最后一跳未成功确认事件而导致数据重复的示例:
在本例中,偏移量100将被处理并多次发送至下游。
一种可用于缓解这一问题的方案是将最后看到的偏移量存储在HDFS或S3中,但这样做可能导致结果永远无法到达下游:
最后,我们可以在与下游交互时原子性地存储偏移量。为此,我们需要实现分布式事务:
个人备注:或者,如果下游系统能够以幂等的方式处理聚合结果,则无需使用分布式事务。
Scale the system
让我们讨论一下随着系统规模扩大,如何进行扩展。
我们有三个独立的组件——消息队列、聚合服务和数据库。由于它们彼此解耦,因此可以分别进行扩展。
我们如何对消息队列进行扩展:
•
我们不对生产者数量设限,因此它们可以轻松扩展
•
可以通过将消费者分配到消费者组并增加消费者数量来实现扩展。
•
为此,我们还需确保预先创建足够数量的分区
•
此外,当消费者数量达到数千时,消费者再平衡可能需要较长时间,因此建议在业务低峰时段执行。
•
我们也可以考虑按地域对主题进行分区,例如topic_na, topic_eu, 等等。
我们如何扩展聚合服务:
•
通过增加节点即可轻松扩展Map-Reduce节点
•
可通过使用多线程来提升聚合服务的吞吐量
•
或者,我们也可以借助 Apache YARN 等资源管理器来实现多进程
•
方案一更简单,但方案二在实际应用中更为普遍,因为它更具扩展性
•
以下是多线程的示例:
我们如何对数据库进行扩展:
•
如果使用Cassandra,它原生支持通过一致性哈希实现水平扩展
•
当集群中新增一个节点时,数据会自动在所有(虚拟)节点间重新均衡
•
采用这种方法,无需手动(重新)分片
另一个需要考虑的可扩展性问题是对热点的处理——如果某条广告更受欢迎、获得的关注度远高于其他广告,该怎么办?
•
在上述示例中,聚合服务节点可以通过资源管理器申请额外的资源
•
资源管理器会分配更多资源,从而避免原节点过载
•
原始节点将事件划分为3个分组,每个聚合节点负责处理100个事件
•
结果被写回原始聚合节点
应对热点问题的其他更复杂的方法:
•
全局-本地聚合
•
拆分去重聚合
Fault Tolerance
在聚合节点内部,我们是在内存中处理数据。如果某个节点宕机,已处理的数据就会丢失。
我们可以利用 Kafka 中的消费者偏移量,以便在其他节点接替处理时,从上次中断的地方继续消费。然而,由于我们要在 M 分钟内聚合排名前 N 的广告,因此还需要维护额外的中间状态。
我们可以针对正在进行的聚合,在特定分钟生成快照:
如果某个节点宕机,新节点可以读取最新的已提交消费偏移量以及最新的快照,从而继续执行任务:
Data monitoring and correctness
由于我们所汇总的数据用于计费,至关重要,因此必须建立严格的监控机制,以确保数据的准确性。
我们可能需要监控的一些指标:
•
延迟:可通过追踪不同事件的时间戳,了解系统的端到端延迟
•
消息队列大小:如果队列大小突然增大,我们需要增加更多的聚合节点。由于 Kafka 是基于分布式提交日志实现的,因此我们应改而关注 records-lag 指标。
•
聚合节点上的系统资源:CPU、磁盘、JVM 等。
我们还需要实现一个对账流程,它是一个批处理作业,在每天结束时运行。该流程会从原始数据中计算出汇总结果,并将其与存储在聚合数据库中的实际数据进行比对:
Alternative design
在一次通用型系统设计面试中,你并不需要掌握用于大数据处理的专用软件的内部原理。
阐述思考过程并探讨权衡取舍,比掌握具体工具更为重要,这也是本章采用通用解决方案的原因。
一种利用现成工具的替代方案是:将广告点击数据存储在 Hive 中,并在其上构建一层 Elasticsearch,以实现更快速的查询。
聚合通常在 OLAP 数据库中完成,例如 ClickHouse 或 Druid。
步骤4:总结
我们讨论的内容:
•
数据模型与API设计
•
使用MapReduce对广告点击事件进行聚合
•
消息队列、聚合服务与数据库的扩展
•
缓解热点问题
•
持续监控系统
•
通过一致性校验确保正确性
•
容错
广告点击事件的聚合是一个典型的大数据处理系统。
如果你事先了解相关技术,将更易于理解和设计:
•
Apache Kafka
•
Apache Spark
•
Apache Flink