第16章:设计邻近服务功能
简介
邻近服务旨在查找附近的地点,例如餐馆、酒店、加油站及其他商家。此功能广泛应用于Google 地图和Yelp等应用中,帮助用户在指定半径范围内发现各类场所。
步骤1:理解问题并明确范围
根据用户位置(纬度、经度)和搜索半径搜索企业。
允许企业主添加、更新或删除企业(非实时)。
在请求时提供详尽的业务信息。
步骤2:概要设计
API Design
搜索附近商家
GET /v1/search/nearby
•
请求参数:
◦
latitude:用户的地理位置纬度。
◦
longitude:用户的地理位置经度。
◦
radius:搜索半径(默认值:5000米)。
High-Level System Architecture
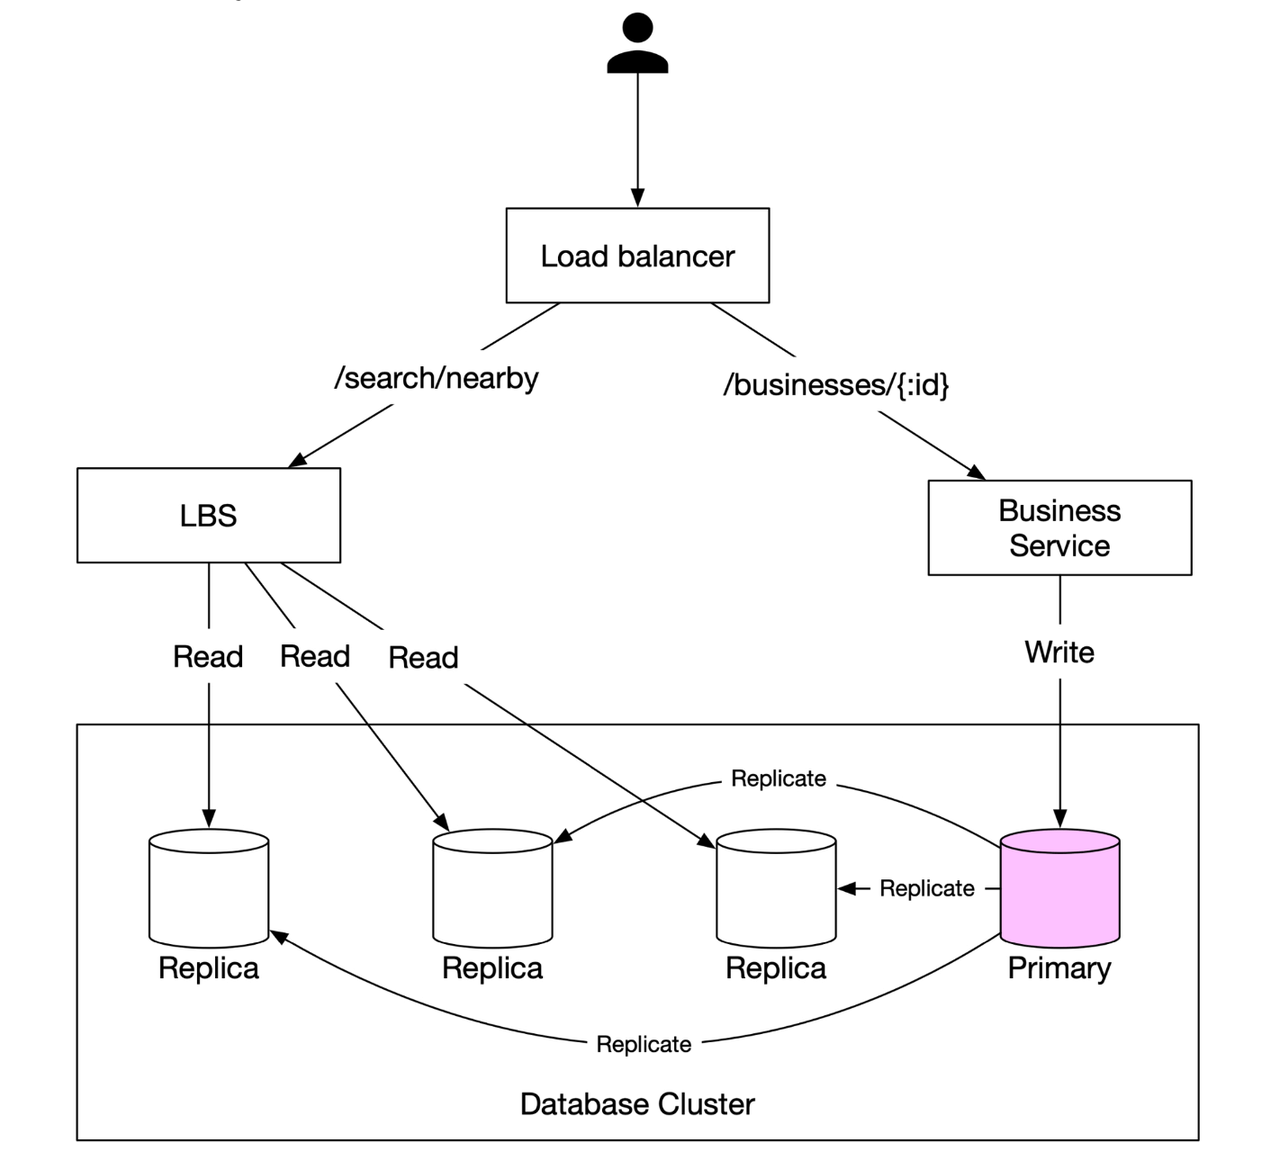
该系统由两部分组成:基于位置的服务(LBS)和业务相关服务。
•
基于位置的服务(LBS):
◦
处理基于位置的搜索查询。
◦
读多写少的服务,无写请求。
◦
QPS较高,尤其是在人口密集区域的高峰时段,且系统为无状态架构。
•
业务服务:处理两类请求。
◦
业务负责人负责创建、更新或删除业务。
◦
客户查看某项业务的详细信息。
•
负载均衡器:将流量路由至LBS和业务服务。
•
数据库集群:
◦
用途采用主从架构以应对读密集型工作负载。
◦
通过LBS读取的数据与主数据库写入的数据之间可能存在一定差异。
步骤3:获取附近商家的算法
Option 1: Two-Dimensional Search (Naive Approach)
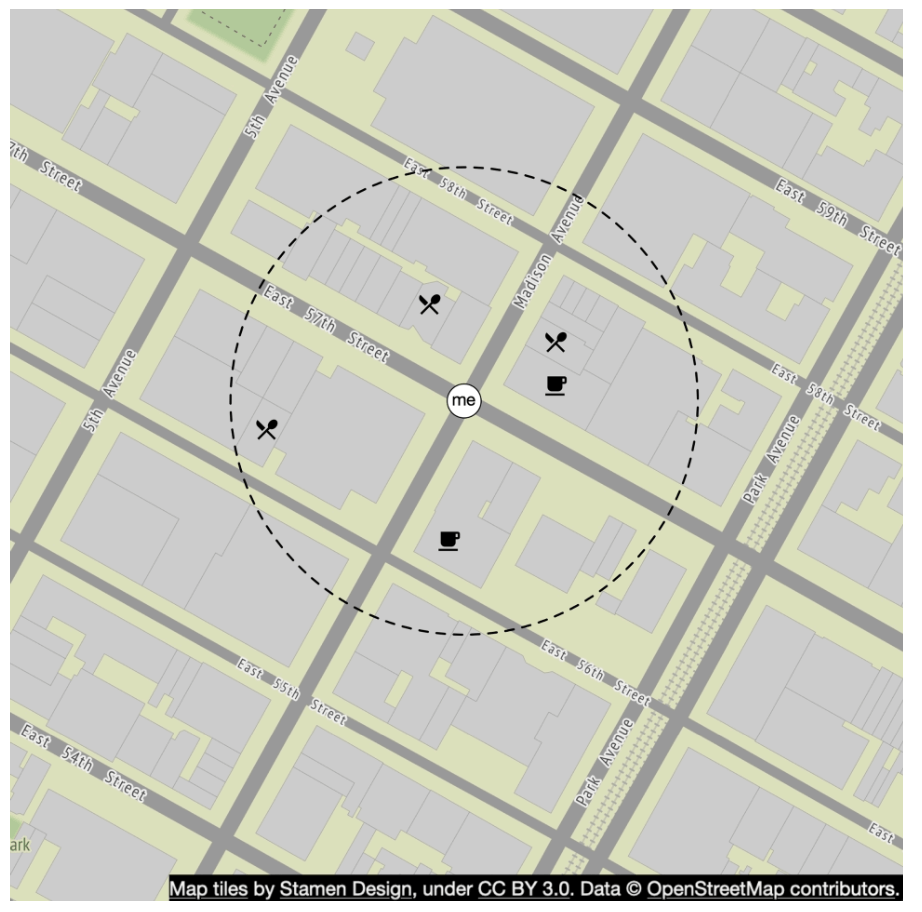
最直观的方法是绘制一个具有预设半径的圆,并找出该圆内的所有商家。
SQL 查询:
问题:
•
效率低下:需要扫描整个数据库。
•
受限于一维索引(纬度/经度)。
Better Approach
一种潜在的改进方案是在经度和纬度列上建立索引,尽管这样会略有改善,但速度仍然非常慢。
•
<b 上述方法的问题在于,数据库索引只能在单一维度上提升查询速度。
•
一种最优的方法是利用地理空间索引,将二维数据映射为一维。
◦
哈希:均匀网格、Geo Hash
◦
树:四叉树、Google S2、RTree
Option 2: Evenly Divided Grid
•
将世界划分为固定大小的网格.
•
问题:业务分布不均(城市密度高,农村稀疏)。
Option 3: Geohash
•
将地球沿本初子午线和赤道划分为四个象限,再将每个象限进一步细分为四个更小的网格。
•
每个网格都可以通过调整经度和纬度的位数来表示。
•
重复此细分
51%
49%
•
将纬度和经度编码为一个单一的字母数字字符串。它具有12个精度级别(共12级)
•
分层网格结构可实现高效查询。
•
根据表格选择合适的精度,采用最小的Geohash长度。
•
地理哈希保证:两个地理哈希的共同前缀越长,它们之间的距离就越近。
•
挑战:
•
边界问题(靠近网格边缘的业务可能会被排除在外)。
◦
两个地点可能相距很近,但却完全没有共同的前缀(甚至可能位于赤道的另一侧)
◦
两个地点可能拥有很长的共同前缀,但属于不同的地理哈希。
•
解决方案:需搜索相邻网格。
Option 4: Quadtree
四叉树是一种树形数据结构,它通过递归方式将二维空间划分为四个象限,每个内部节点恰好拥有四个子节点,分别对应该空间的四个子区域。
•
四叉树是一种内存中的数据结构,它在每台LBS服务器上运行,并在服务器启动时构建。
•
根节点被递归地划分为4个象限,直到每个象限中不再存在超过x个业务的节点(本例中为100个)。
•
四叉树索引占用的内存不多(通常以GB为单位),完全可以容纳在一台服务器中。
•
由于构建该树的时间复杂度为nlogn,因此构建过程可能需要几分钟。
•
适用于k近邻搜索查询(例如,查找最近的加油站)。
运行时注意事项
•
对于大约2亿家企业而言,服务器启动时构建一棵四叉树可能只需几分钟。
•
在构建四叉树期间,它无法对外提供服务,因此新版本应以渐进式方式逐步推送到部分服务器。
•
在更新业务或新增功能时,最简便的做法是逐步重建四叉树。(这会导致大量缓存失效)
•
也可以在运行时动态更新四叉树,但实现起来更为复杂。(需要加锁机制)
Option 5: Google S2
它基于希尔伯特曲线将球面映射为一维索引。在希尔伯特曲线上彼此接近的两个点,在一维空间中也彼此接近。
46%
54%
•
利用希尔伯特曲线将地球划分为多个小单元.
•
非常适合地理围栏,因为它能够以不同的精度覆盖任意区域。
•
地理围栏还允许定义围绕感兴趣区域的参数。
•
另一个优势是,与其采用固定的精度级别,我们可以在S2中指定最小、最大精度级别以及最大单元格数量。
权衡比较
地理哈希码
•
易于使用且易于实现——无需构建或重建树结构
•
支持固定半径的查询结果
•
索引更新简便。
•
无法根据人口密度动态调整网格大小。
四叉树
•
实现难度略高。
•
支持获取k个最近的商家。
•
可以根据人口密度动态调整网格大小。
•
更新索引更加复杂,可能需要重建整棵树。
步骤4:数据库与缓存策略的扩展
Scaling the Business Table
•
按业务ID进行分片可确保数据均匀分布。
•
我们在表中为每个业务单独设置一行。
Scaling the Geospatial Index
•
可能不太适合使用地理哈希表。在这种情况下,所有数据都可以容纳在单台服务器上,因此没有进行分片的技术理由。
•
更好的做法是部署只读副本,以分担读取负载。
Cache Strategy
最直观的缓存键选择是位置坐标,但它存在一些问题:
•
来自GPS的位置坐标并不精确。
•
用户移动时,位置坐标会发生变化。
•
更好的密钥是地理哈希码。
Step 5: Deployment Strategy and Final Architecture
Region and Availability Zones
•
Deploy LBS and Business Service across multiple regions.
Handling Real-Time Updates
•
Business updates are batch processed daily.
Final System Architecture
最终的算法如下:
获取附近商家的步骤
用户请求:
◦
用户搜索半径为500米.
◦
客户端将纬度(37.776720)、经度(-122.416730)以及半径(500米)发送至负载均衡器.
请求转发:
◦
负载均衡器(LB)将请求转发至基于位置的服务(LBS)。
Geohash 计算:
◦
LBS确定与半径相匹配的地理哈希长度。
◦
使用参考表,500米对应于geohash长度=6.
获取相邻的地理哈希值:
◦
LBS计算邻近的geohash以涵盖周边区域。
◦
结果是一个列表:
从 Redis 获取商家 ID:
◦
对于列表中的每个格雷沙,LBS会向格雷沙 Redis 服务器发起查询,以获取商家 ID.
◦
采用并行查询以最大限度地降低延迟。
检索并排序商家:
◦
LBS 从业务信息 Redis 服务器中获取完整的业务详情。
◦
企业按与用户位置的距离进行排序。
◦
排序后的结果被返回给客户端。
关键优化
•
并行调用 Redis:缩短响应时间。
•
Geohash 索引:确保高效的空间查询。
•
缓存:加快业务数据的查找与检索速度。
该方法可实现低延迟、可扩展的用户周边商家检索功能。
Choosing the Best Indexing Method