第7章:在分布式系统中设计一个唯一ID生成器
简介
本章探讨了为分布式系统设计唯一ID生成器这一挑战。由于可扩展性和同步方面的难题,传统的自增主键在分布式环境中并不适用。重点在于生成满足以下要求的、唯一且可排序的64位数字ID:
•
ID 必须唯一且按日期排序.
•
ID 必须在64 位.
•
系统应能每秒生成超过1万个ID.
步骤1:理解问题
Basic Requirements
•
ID 必须唯一且为数字,并且应能容纳于 64 位整数、ID 随时间递增,但并非严格按顺序递增+1.
•
ID 应当能够按日期排序、系统必须能够处理高吞吐量(10,000 个 ID/秒)。
步骤2:高层次设计选项
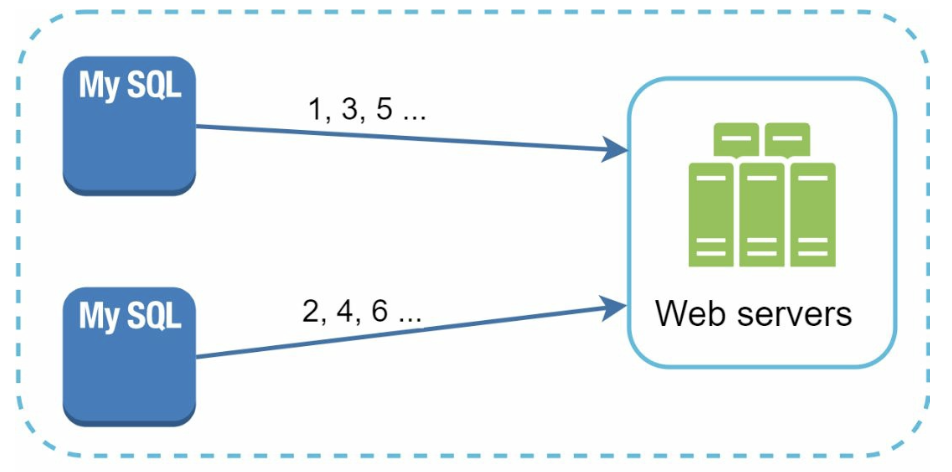
Multi-Master Replication
•
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
•
缺点:
◦
难以跨数据中心扩展。
◦
ID并不总是随时间递增。
◦
服务器增减时的扩展性问题。
UUID (Universally Unique Identifier)
•
方法:
◦
在每台服务器上独立生成128位唯一标识符,使用UUID。
◦
UUID可在各服务器间独立生成,无需协调
•
优势:
◦
服务器之间无需协调。
◦
可随Web服务器轻松扩展。
•
缺点:
◦
超出64位限制。
◦
ID 不支持按时间排序,且可能并非数字。
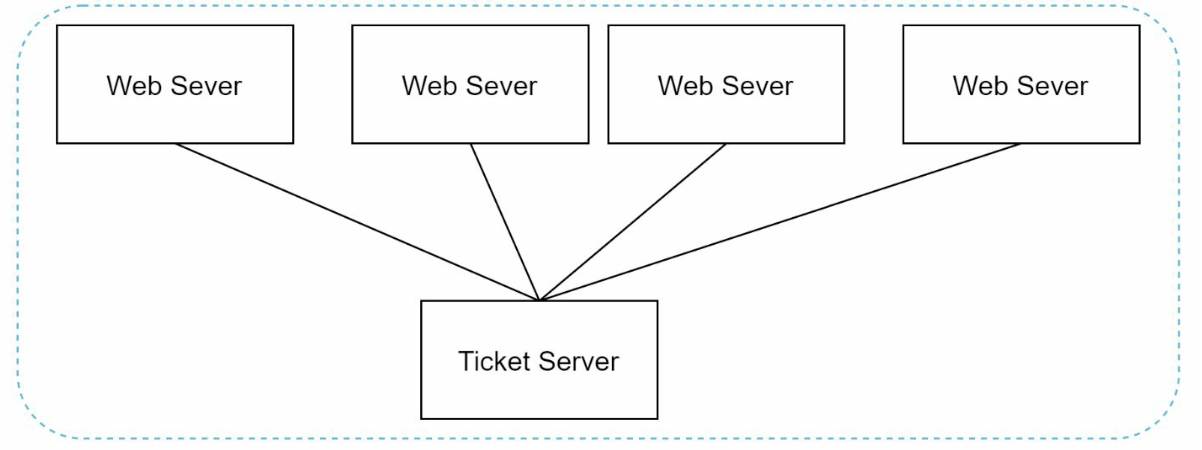
Ticket Server
•
方法:使用一台中心化的数据库服务器来递增并分配ID。
•
优势:
◦
适用于小型系统的简单实现。
◦
生成数字ID。
•
缺点:
◦
单点故障。
Twitter Snowflake Approach
•
方法:
•
优势:
◦
可扩展性:可在多台服务器上每秒处理超过1万个ID。
◦
时间顺序:确保ID可按时间排序。
◦
去中心化:不存在单点故障。
步骤4:其他注意事项
Clock Synchronization
•
挑战:ID生成假设各服务器之间的时间同步。
•
解决方案:使用网络时间协议(NTP)以尽量减少时钟漂移。
Section Length Tuning
•
根据具体应用场景调整各部分的大小(例如,减少序列位数、增加时间戳位数)。
High Availability
•
ID生成器至关重要,必须具备容错能力。
•
考虑冗余与故障转移机制。