第18章:设计类谷歌地图
第一步:理解问题并明确设计范围
Map 101
在开始设计之前,有一些与地图相关的概念我们需要先了解。
定位系统
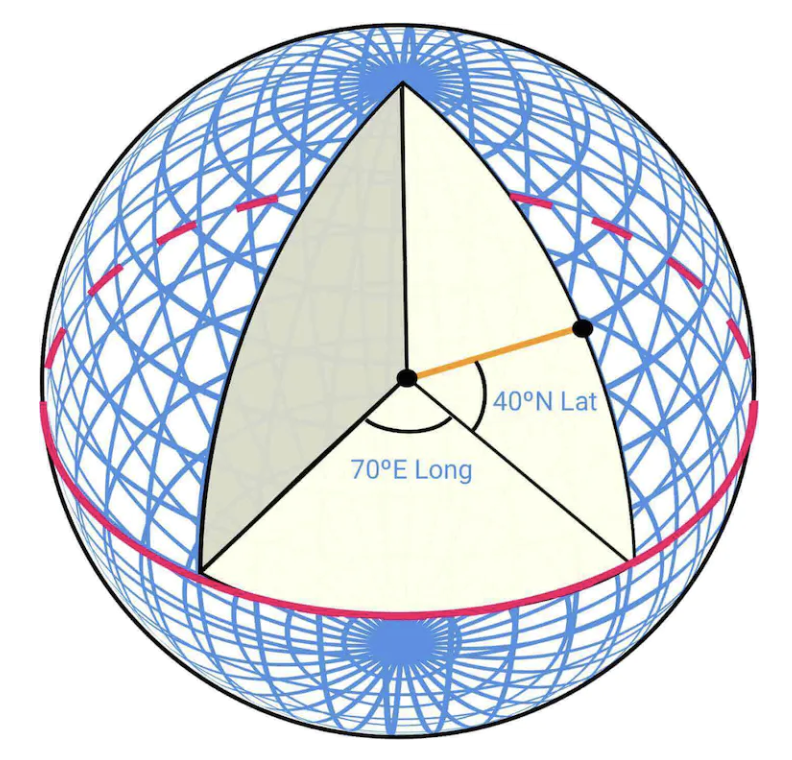
地球是一个球体,绕其自转轴旋转。位置由纬度(你位于北半球还是南半球)和经度(你位于东半球还是西半球)来确定:
从三维到二维的转换
将三维空间中的点映射到二维平面的过程称为“地图投影”。
实现方式多种多样,每种都有其优缺点。几乎所有的方法都会扭曲实际的几何形状。
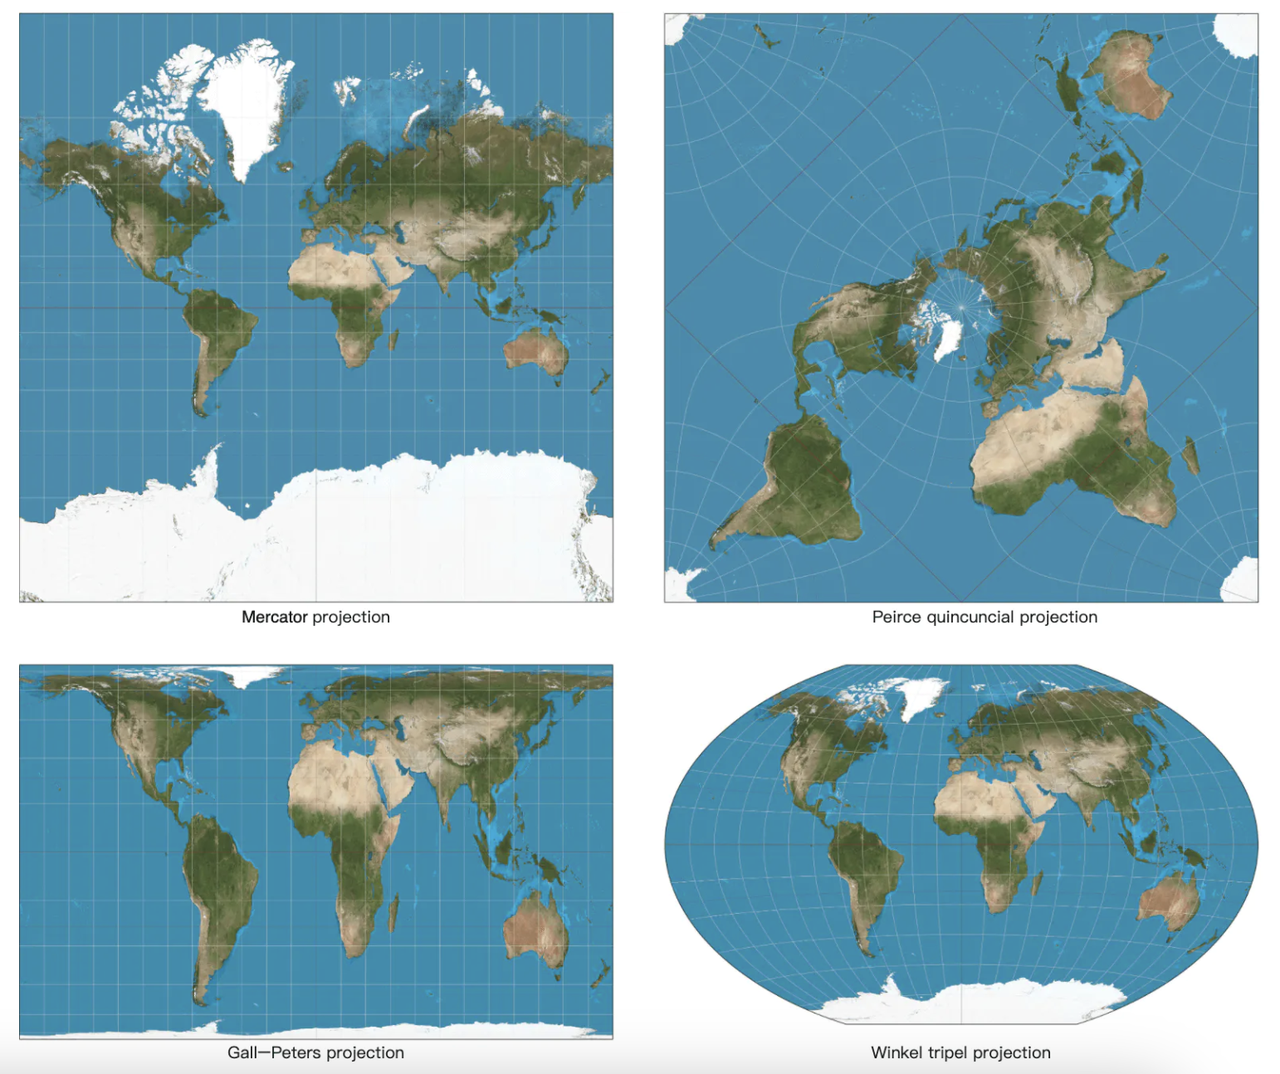
谷歌地图选用了一种经过改良的墨卡托投影,称为“Web墨卡托”。
地理编码
地理编码是将地址转换为地理坐标的过程。
逆向过程称为“逆向地理编码”。
实现这一目标的一种方法是使用插值——利用来自不同来源(例如GIS系统)的数据,将街道网络映射到地理坐标空间。
地理哈希
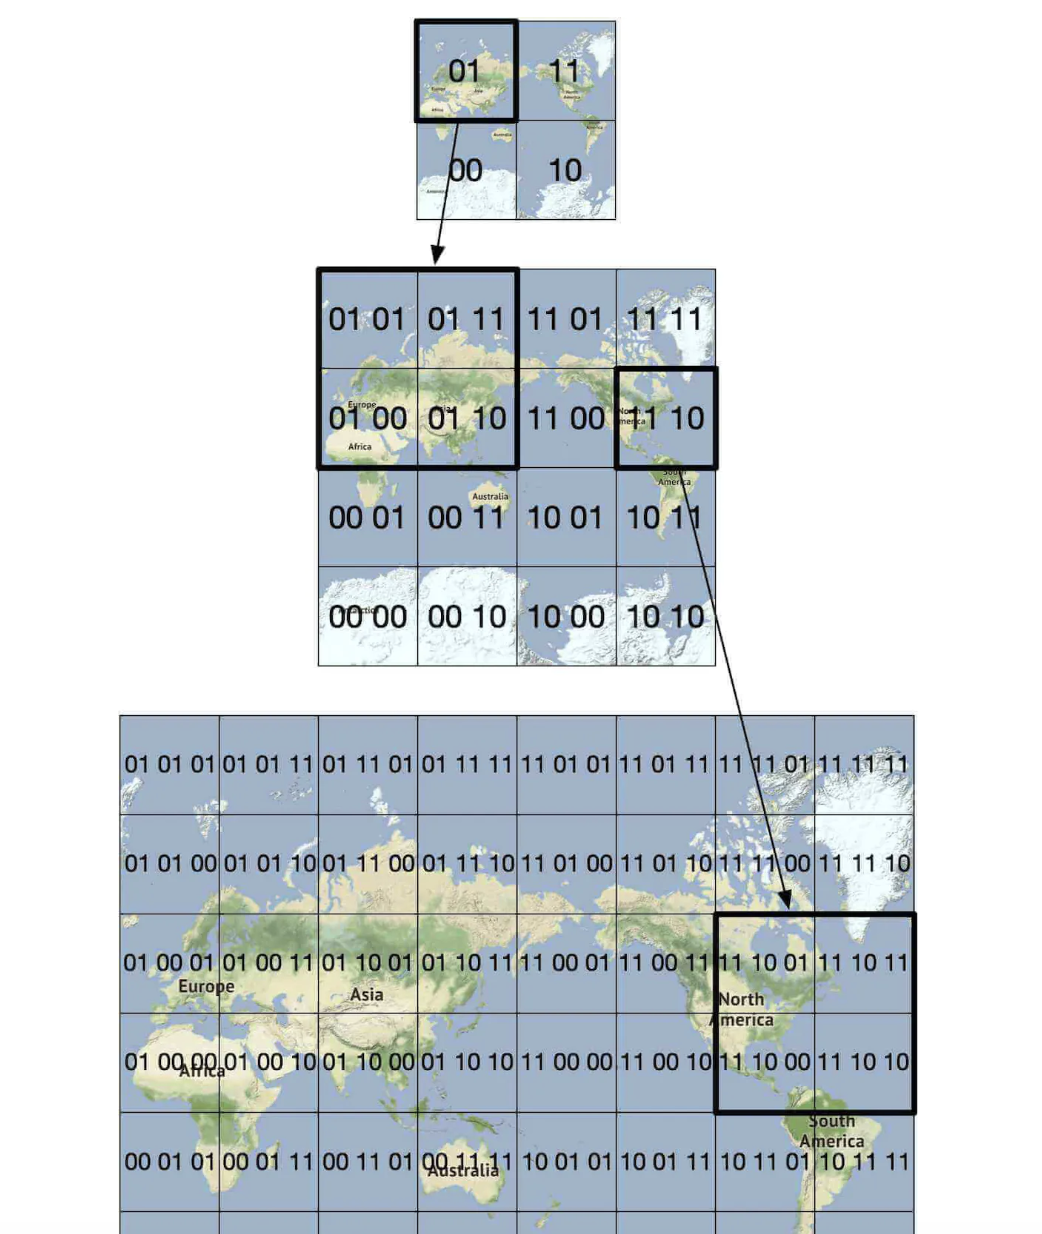
地理哈希是一种编码系统,可将某一地理区域编码为一串字母和数字。
它将世界视为一个平面,并将其递归地划分为四个象限:
地图渲染
地图渲染采用瓦片化方式。不再将整张地图渲染为一张大型自定义图像,而是将世界划分为多个较小的瓦片。
客户端仅下载相关瓦片,并将其像拼接马赛克一样进行渲染。
不同缩放级别对应不同的瓦片。客户端根据自身的缩放级别选择合适的瓦片。
例如,当将视图放大到整个世界时,系统只会下载一张256×256的瓦片,用于表示整个世界。
用于导航算法的道路数据处理
在大多数路径规划算法中,交叉口被表示为节点,道路被表示为边:
大多数导航算法都采用经过改进的Dijkstra或A*算法。
路径规划的性能对图的规模非常敏感。要在大规模场景下运行,我们无法将整个世界表示为一张图并直接在其上执行算法。
相反,我们采用一种类似于分块的技术——将整个世界逐步划分为更小的图。
路由瓦片保存着与相邻瓦片的引用,算法在遍历相互连接的瓦片时,能够拼接出更大的道路图:
该技术使我们能够大幅降低内存带宽,仅加载针对特定源/目标组合所需的瓦片。
然而,对于规模较大的路线,将细粒度的小型路由瓦片拼接起来仍然会耗费大量时间和内存。相反,系统中存在不同细节层级的路由瓦片,算法会根据目标位置选择相应细节层级的瓦片进行处理:
Back-of-the-envelope estimation
在存储方面,我们需要存储:
•
世界地图——根据所需存储的所有瓦片估算约为70PB,但已考虑对高度相似瓦片的压缩(如广袤沙漠)
•
元数据——体积可忽略,因此在计算中可略过
•
道路信息——以路由瓦片形式存储
导航请求的预计 QPS——在每周使用时长为 35 分钟、日活跃用户数达 10 亿的情况下,每日总分钟数约为 50 亿。假设 GPS 更新请求采用批处理方式,则可得到 20 万 QPS 的平均负载,以及峰值负载下的 100 万 QPS
步骤2:提出高层次设计方案并获得认可
Location service
它负责记录用户的每一次位置更新:
•
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
•
位置数据流可用于随时间推进建立更优质的服务,例如提供更精准的预计到达时间、监测交通状况、识别封闭道路、分析用户行为等
与其始终将位置更新发送至服务器,我们可以在客户端对更新进行批量处理,然后以批次的形式发送:
尽管进行了这项优化,但对于像 Google 地图这样规模的系统,负载依然会相当可观。因此,我们可以借助一款专为高写入负载优化的数据库,例如 Cassandra。
我们还可以利用 Kafka 对位置更新进行高效的流式处理,以便进一步分析。
示例位置更新请求负载:
代码块
Plain Text
POST /v1/locations
Parameters
locs: JSON encoded array of (latitude, longitude, timestamp) tuples.
Navigation service
该组件负责在合理的时间内找到 A 与 B 之间的最快路径(允许存在轻微的延迟)。路径不必是最短的,但准确性至关重要。
示例请求负载:
代码块
Plain Text
GET /v1/nav?origin=1355+market+street,SF&destination=Disneyland
示例响应:
代码块
SQL
{
"distance": {"text":"0.2 mi", "value": 259},
"duration": {"text": "1 min", "value": 83},
"end_location": {"lat": 37.4038943, "Ing": -121.9410454},
"html_instructions": "Head northeast on Brandon St toward Lumin Way<div style=\"font-size:0.9em\">Restricted usage road
"polyline": {"points": "_fhcFjbhgVuAwDsCal"},
"start_location": {"lat": 37.4027165, "lng": -121.9435809},
"geocoded_waypoints": [
{
"geocoder_status" : "OK",
"partial_match" : true,
"place_id" : "ChIJwZNMti1fawwRO2aVVVX2yKg",
"types" : [ "locality", "political" ]
},
{
"geocoder_status" : "OK",
目前尚未考虑交通变化与路径重规划,这些内容将在深入探讨部分予以处理。
Map rendering
在客户端端保存整个地图瓦片数据集是不可行的,因为其规模高达数PB。
它们需要根据客户端的位置和缩放级别,按需从服务器获取。
何时应加载新的瓦片——在用户进行放大/缩小操作时,以及在导航过程中、当用户朝向新瓦片移动时。
地图瓦片应如何提供给客户端?
•
它们可以动态生成,但这样会给服务器带来巨大负载,同时也使缓存变得困难
•
地图瓦片以静态方式提供,其基于地理哈希值,客户端可自行计算。这些瓦片可预先静态存储,并通过 CDN 进行分发
CDN 使用户能够从距离其最近的边缘节点(POP)获取地图瓦片,从而最大限度地降低延迟:
用于确定地图瓦片的可选方案:
•
用于地图瓦片的格雷沙姆编码可以在客户端计算。如果是这样,我们应当谨慎,因为长期采用这种在客户端进行地图瓦片计算的方案,一旦需要强制客户端更新,将十分困难
•
或者,我们也可以提供一个简单的 API,代表客户端计算地图瓦片的 URL,但需要额外发起一次 API 调用
步骤3:设计深度剖析
Data model
让我们讨论一下如何存储我们所处理的各类数据。
路由瓦片
初始道路数据集来自多个来源,并随着位置更新数据的积累而不断优化。
道路数据是非结构化的。我们有一个定期的离线处理管道,负责将这些原始数据转换为我们的应用所需的基于图的路由瓦片。
由于我们并不需要数据库的任何功能,因此无需将这些瓦片存储在数据库中。我们可以将其存放在S3对象存储中,并同时进行积极的缓存。
我们还可以利用相关库,将邻接表高效地压缩为二进制文件。
用户位置数据
用户位置数据对于更新交通状况以及进行各类分析都非常有用。
<b我们可以使用Cassandra来存储这类数据,因为它的设计特点就是以写入为主。
示例行:
地理编码数据库
该数据库存储经纬度坐标与地点的键值对。
我们可以利用 Redis 的快速读取性能,因为我们的读操作频繁而写操作较少。
世界地图的预计算图像
正如我们所讨论的,我们将预先计算地图瓦片图像,并将其存储在 CDN 中。
Services
位置服务
让我们重点探讨该服务的数据库设计,以及用户位置信息的具体存储方式。
我们可以使用NoSQL数据库来应对位置更新带来的高写入负载。由于用户的位置数据经常变化,并且随着新更新的到达而逐渐失效,我们选择以可用性优先于一致性。
我们将选择Cassandra作为我们的数据库,因为它很好地满足了我们所有的需求。
我们要存储的示例行:
•
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
•
这是 GitHub 仓库页面,标题为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”。上下文。
我们还利用 Kafka 将位置更新以流式方式推送给其他多个服务,这些服务出于不同目的需要获取位置更新:
地图渲染
地图瓦片按不同缩放级别存储。在最低缩放级别,整个世界仅由一张256×256的瓦片表示。
随着缩放级别的提高,地图瓦片的数量会增至四倍:
我们可采用的一项优化措施是:不通过网络传输整张图像数据,而是将瓦片表示为向量(路径与多边形),由客户端动态渲染这些瓦片。
这将带来显著的带宽节省。
导航服务
该服务负责寻找最快的路径:
让我们逐一介绍该子系统中的各个组件。
首先,我们有一个地理编码服务,它能够将地址解析为对应的经纬度坐标。
示例请求:
代码块
Plain Text
示例响应:
代码块
JSON
{
"results" : [
{
"formatted_address" : "1600 Amphitheatre Parkway, Mountain View, CA 94043, USA",
"geometry" : {
"location" : {
"lat" : 37.4224764,
"lng" : -122.0842499
},
"location_type" : "ROOFTOP",
"viewport" : {
"northeast" : {
路线规划服务会根据当前的交通状况,计算出一条以出行时间最优的推荐路线。
最短路径服务在对象存储中的路由瓦片上运行A*算法的变体,以计算出一条最优路径:
•
它接收源/目的地对,将其转换为经纬度坐标,并基于这些坐标计算地理哈希值,从而确定路由瓦片
•
该算法从初始路由瓦片开始,沿其进行遍历,直至找到一条足够好的通向目标瓦片的路径
ETA 服务由路径规划器调用,用于基于机器学习算法获取预计到达时间,并根据交通数据进行预测。
排序服务负责根据用户提供的筛选条件(例如避开收费公路或高速公路的标志)对不同的可行路径进行排序。
更新服务会异步更新部分重要数据库,以确保其数据始终最新。
改进——自适应预计到达时间与路径重规划
我们可以进行的一项改进是,根据新获取的交通数据,对正在执行中的路线进行自适应更新。
一种实现方式是,将当前正在浏览某条路线的用户及其应经过的所有瓦片信息存储在数据库中。
数据可能如下所示:
代码块
Plain Text
user_1: r_1, r_2, r_3, …, r_k
user_2: r_4, r_6, r_9, …, r_n
user_3: r_2, r_8, r_9, …, r_m
...
user_n: r_2, r_10, r21, ..., r_l
如果某块区域发生交通事故,我们可以识别出所有路径经过该区域的用户,并为他们重新规划路线。
为了减少数据库中存储的瓦片数量,我们可以改为存储起始位置的路由瓦片以及若干不同分辨率级别的路由瓦片,直到最终目标瓦片也被包含在内:
代码块
Plain Text
user_1, r_1, super(r_1), super(super(r_1)), ...
借助这一点,我们只需检查某位用户的最后一块地图是否包含交通事故图块,即可判断该用户是否受到影响。
我们还可以为正在导航的用户记录所有可能的路线,并在有更快速的重新规划路线时通知他们。
配送协议
我们有多种方案,使我们能够从服务器主动向客户端推送数据:
•
移动推送通知无法正常工作,因为有效载荷大小受限,且该功能不适用于Web应用
•
WebSocket通常比长轮询更优,因为它在服务器端的计算开销更小
•
我们也可以使用服务器发送事件(SSE),但更倾向于使用 WebSocket,因为它支持双向通信,这在诸如最后一公里配送等功能中会非常有用
步骤4:总结
这就是我们的最终设计方案:
我们还可以提供的一项附加功能是多站点导航,该功能可面向Uber或Lyft等企业客户销售,用于规划访问一组地点的最优路径。