第19章:设计分布式消息队列
简介
在本章中,我们将设计一个分布式消息队列。
消息队列的优势:
•
解耦:消除各组件之间的紧密耦合,使其能够独立更新。
•
可扩展性更强:生产者和消费者可根据流量独立进行扩展。
•
提高可用性:当系统的某个部分发生故障时,其他部分仍能继续与队列进行交互。
•
性能更优:生产者无需等待消费者确认即可发送消息。
一些流行的消息队列实现——Kafka、RabbitMQ、RocketMQ、Apache Pulsar、ActiveMQ、ZeroMQ。
严格来说,Kafka 和 Pulsar 并不是消息队列,它们是事件流处理平台。不过,两者在功能上存在诸多重叠,使得消息队列与事件流处理平台之间的界限变得模糊。
在本章中,我们将构建一个消息队列,并支持诸如长期数据保留、重复消费消息等更高级的功能。
第一步:理解问题并明确设计范围
消息队列通常应支持若干基本功能——生产者发布消息,消费者消费消息。然而,在性能、消息投递、数据保留等方面仍存在诸多考量。
以下是候选人与面试官之间可能涉及的一系列问题:
•
C:消息的格式和平均大小是多少?是否仅限于文本?
•
答:消息仅限于文本形式,且通常只有几 KB 大小
•
C:消息能否被重复消费?
•
答:是的,消息可以被不同的消费者重复消费。这是一项额外的需求,而传统消息队列并不支持。
•
C:消息是否按照生产顺序被消费?
•
答:是的,必须保证顺序性。这是一项额外的需求,而传统的消息队列并不支持这一点。
•
C:数据保留有哪些要求?
•
I:消息需保留两周。这是一项新增的要求。
•
问:我们希望支持多少个生产者和消费者?
•
I:越多越好。
•
问:我们希望支持哪种数据交付语义?最多一次、至少一次,还是恰好一次?
•
一:我们当然希望实现至少一次的语义。理想情况下,我们还能支持所有语义,并使其可配置。
•
问:端到端延迟的目标吞吐量是多少?
•
一:它应当能够支持高吞吐量的使用场景,如日志聚合;同时也能满足传统低吞吐量场景的需求。
Functional requirements
•
生产者将消息发送到消息队列
•
消费者从队列中消费消息
•
消息可以被消费一次或多次
•
历史数据可以被截断
•
消息大小在KB级别
•
需要保持消息的顺序
•
数据传输语义可配置——最多一次、至少一次、恰好一次。
Non-functional requirements
•
高吞吐量或低延迟:可根据具体应用场景进行配置
•
可扩展性:系统应具备分布式架构,并能应对消息量的突发激增
•
持久且耐用:数据应持久化存储于磁盘,并在各节点间进行复制
传统的消息队列通常不支持数据持久化,也不提供消息顺序保证。这大大简化了系统设计,我们稍后会详细讨论。
步骤2:提出高层次设计方案并获得认可
消息队列的关键组件:
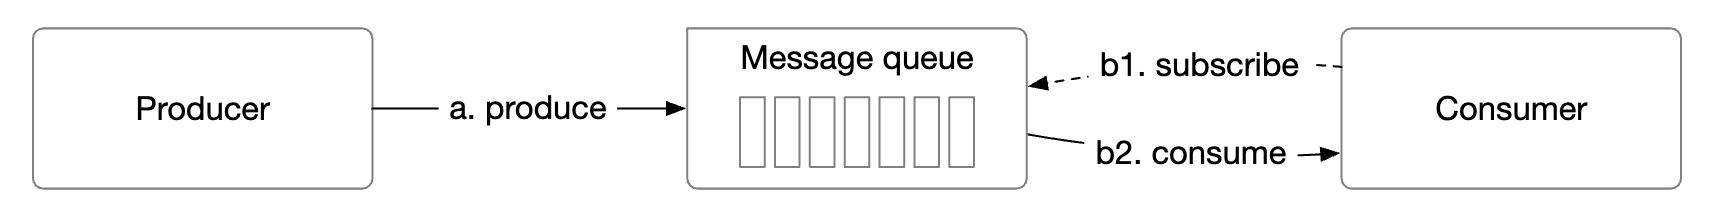
•
生产者向队列发送消息
•
消费者订阅某个队列,并消费所订阅的消息
•
消息队列是一种中间服务,它将生产者与消费者解耦,使两者能够独立扩展。
•
生产者和消费者都是客户端,而消息队列则是服务器。
Messaging models
第一种消息传递模型是点对点模式,常见于传统消息队列中:
•
一条消息被发送到队列中,并且仅由一个消费者进行消费。
•
可以有多个消费者,但每条消息只会被消费一次。
•
当消息被确认已消费后,它将从队列中移除。
•
在点对点模型中不存在数据保留,但在我们的设计中则存在。
另一方面,发布-订阅模型在事件流平台中更为常见:
•
在该模型中,消息与某个主题相关联。
•
消费者订阅某个主题,并接收所有发送到该主题的消息。
Topics, partitions and brokers
如果某个主题的数据量过大怎么办?一种扩展方式是将该主题拆分为多个分区(即分片):
•
发送到某个主题的消息会均匀地分布于各个分区
•
托管分区的服务器被称为代理
•
每个主题都像一个队列一样,采用FIFO方式进行消息处理。在同一个分区内,消息的顺序得以保持。
•
消息在分区中的位置被称为偏移量.
•
每条生成的消息都会被发送到一个特定的分区。分区键用于指定消息应被写入哪个分区。
◦
例如 auser_id可用作分区键,以确保同一用户的消息顺序。
•
每个消费者订阅一个或多个分区。当同一组消息存在多个消费者时,这些消费者会组成一个消费者组。
Consumer groups
消费者组是一组协同工作、从某个主题中消费消息的消费者:
•
消息按消费者组进行复制(而非按消费者)。
•
每个消费者组维护自己的偏移量。
•
消费者组并行读取消息可提高吞吐量,但会削弱顺序性保证。
•
这可以通过仅允许一个消费者组中的一个消费者订阅某个分区来缓解。
•
这意味着一个消费组中的消费者数量不能超过分区的数量。
High-level architecture
•
客户端:生产者和消费者。生产者向指定的主题推送消息,消费者组则从该主题订阅消息。
•
代理服务器:负责维护多个分区。一个分区存储某个主题的一部分消息。
•
数据存储:将消息存储在分区中。
•
状态存储:保存消费者的状态。
•
元数据存储:用于存储配置信息和主题属性
•
协调服务:负责服务发现(哪些 Broker 正在运行)以及领导者选举(哪台 Broker 是 Leader,负责分区的分配)。
步骤3:设计深度剖析
为了实现高吞吐量并满足高数据保留要求,我们做出了一些重要的设计决策:
•
我们选择了一种基于磁盘的数据结构,充分利用了现代机械硬盘的特性以及现代操作系统中的磁盘缓存机制。
•
消息数据结构是不可变的,以避免额外的复制操作,而在高吞吐量、高流量的系统中,我们希望尽量减少这种开销。
•
我们围绕批量写入来设计写操作,因为小I/O是高吞吐量的敌人。
Data storage
为了为消息找到最合适的存储方案,我们必须考察消息的各项属性:
•
写多读少、读多写少
•
没有更新/删除操作。在传统消息队列中,由于消息不会被持久化,因此存在“删除”操作。
•
以顺序读写为主。
我们的选择有哪些:
•
数据库:并不理想,因为典型数据库难以同时很好地支持写密集型和读密集型系统。
•
预写日志(WAL):一种仅支持追加写入的纯文本文件,对机械硬盘非常友好。
◦
我们将分区拆分为多个段,以避免维护过大的文件。
◦
旧的日志段为只读,只有最新的日志段才接受写入操作。
WAL文件在搭配传统HDD使用时效率极高。
人们普遍误以为硬盘访问速度很慢,但其实这在很大程度上取决于访问模式。当访问模式为顺序访问时(正如我们的情况),硬盘的写入和读取速度可达数MB/s,完全能够满足我们的需求。此外,操作系统还会积极地将磁盘数据缓存到内存中。
Message data structure
为避免额外的内存拷贝,消息格式在生产者、队列和消费者之间保持一致至关重要。这能够显著提升处理效率。
示例消息结构:
消息的键决定了该消息所属的分区。一个示例映射是hash(key) % numPartitions为了获得更高的灵活性,生产者可以覆盖默认的键,从而控制消息被分发到哪些分区。
消息值是消息的有效负载,可以是明文,也可以是经过压缩的二进制数据块。
注:与传统KV存储不同,消息键不必唯一。允许存在重复的键,甚至可以不存在。
其他消息文件:
•
主题:消息所属的主题
•
分区:消息所属分区的ID
•
这是一个 GitHub 仓库页面,标题为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”。上下文。
•
时间戳:消息存储的时间
•
大小:该消息的大小
•
CRC:用于确保消息完整性的校验和
可通过添加额外字段来支持诸如过滤等附加功能。
Batching
批处理对于我们的系统性能至关重要。我们将其应用于生产者、消费者以及消息队列中。
之所以至关重要,是因为:
•
它使操作系统能够将消息分组,从而摊薄昂贵的网络往返开销
•
消息按顺序分组写入WAL,这带来了大量的顺序写入和磁盘缓存。
延迟与吞吐量之间存在权衡:
•
高批量处理会带来高吞吐量,但也会导致更高的延迟。
•
低批量处理则会降低吞吐量,同时降低延迟。
如果由于系统以传统消息队列的形式部署,我们需要支持更低的延迟,那么可以对系统进行调优,采用更小的批处理大小。
如果为吞吐量进行调优,我们可能需要为每个主题配置更多分区,以弥补顺序磁盘写入吞吐量较慢的不足。
Producer flow
如果生产者想要向某个分区发送消息,它应该连接到哪台 Broker?
一种方案是引入一个路由层,用于将消息路由到正确的 Broker。如果启用了复制功能,则目标 Broker 即为该分区的 Leader 副本:
•
路由层从元数据存储中读取复制计划,并在本地进行缓存。
•
生产者向路由层发送一条消息。
•
消息被转发至分区的领导者——Broker 1
•
从副本会从领导者那里拉取新的消息。一旦收到足够多的确认,领导者就会提交该数据,并向生产者发送响应。
设置副本的原因是为了实现容错能力。
这种方法可行,但存在一些不足:
•
由于新增组件导致的额外网络跳数
•
该设计不支持消息批处理
为缓解这些问题,我们可以将路由层嵌入到生产者中:
•
更少的网络跳数意味着更低的延迟
•
生产者可以控制消息被路由到哪个分区
•
缓冲区使我们能够在内存中对消息进行批量处理,并以单次请求发送更大的批次,从而提高吞吐量。
批处理大小的选择是吞吐量与延迟之间的一种经典权衡。
•
较大的批处理大小会导致在批次提交之前等待的时间更长。
•
较小的批处理大小会使请求更早发出,从而降低延迟,但同时也会降低吞吐量。
Consumer flow
消费者在某个分区中指定其偏移量,并从该偏移量开始接收一批消息:
在设计消费者时,一个重要的考量是选择使用推模式还是拉模式:
•
推模式:由于消息代理在接收到消息后即刻将其推送给消费者,因此可实现更低的延迟。
◦
然而,如果消费速率跟不上生产速率,消费者可能会不堪重负。
◦
由于消息队列的消费速率由 Broker 控制,因此很难应对处理能力各不相同的消费者。
•
拉取模型:会导致消费者自主控制消费速率。
◦
如果消费速率较慢,消费者就不会被压垮,我们也可以通过扩容来追上。
◦
拉取模型更适合批处理,因为在推模式下,消息代理无法得知消费者能够处理多少条消息。
◦
另一方面,采用拉取模型时,消费者可以主动批量获取大量消息。
◦
其缺点是当没有新消息时,延迟较高且会增加额外的网络调用。后一个问题可通过长轮询来缓解。
因此,大多数消息队列(以及我们)都选择拉取模型。
•
一个新的消费者订阅了主题A,并加入了组1。
•
通过哈希分组名称来确定正确的 Broker 节点。这样,一个分组中的所有消费者都会连接到同一个 Broker。
•
<b请注意,该消费者组协调器与协调服务(ZooKeeper)是不同的。
•
协调者确认消费者已加入该消费组,并将分区2分配给该消费者。
•
存在多种分区分配策略,如轮询、范围分配等。
•
消费者从上次的偏移量处获取最新消息。状态存储用于保存消费者的偏移量。
•
消费者处理消息并将偏移量提交给 Broker。这两步操作的先后顺序会影响消息的投递语义。
Consumer rebalancing
消费者再均衡负责决定哪些消费者负责哪些分区。
此过程在有消费者加入或离开,或者有分区被添加或移除时发生。
代理作为协调者,在编排再平衡工作流中发挥着至关重要的作用。
•
同一消费组中的所有消费者都连接到同一个协调者。协调者通过哈希计算消费组名称来确定。
•
当消费者列表发生变化时,协调器会为该组选出一个新的领导者。
•
该组的领导者会计算出新的分区分配方案,并将其反馈给协调器,由协调器再将该方案广播给其他消费者。
当协调器不再收到来自某个消费者组中各消费者的心跳时,就会触发一次再平衡:
让我们探讨当一个消费者加入群组时会发生什么:
•
最初,只有消费者A在该群组中,并且它会消费所有分区。
•
消费者B发送请求以加入该群组。
•
协调者通过心跳机制通知所有组成员,现在可以被动地进行再均衡。
•
当所有消费者重新加入该组后,协调者会选出一个领导者,并将选举结果通知其余成员。
•
领导者生成分区分配方案并将其发送给协调者。其他节点则等待该分配方案。
•
消费者从新分配的分区开始消费。
当消费者离开消费组时,会发生以下情况:
•
消费者A和B属于同一组
•
消费者B请求离开消费组
•
当协调者收到A的心跳时,会通知它该进行负载均衡了。
•
其余步骤保持不变。
当消费者长时间未发送心跳时,流程也类似:
State storage
状态存储用于保存分区与消费者之间的映射关系,以及每个分区的最新消费偏移量。
第1组的偏移量为6,这意味着所有之前的消息都已被消费。如果某个消费者发生崩溃,新的消费者将从该消息开始继续消费。
消费者状态的数据访问模式:
•
读写操作频繁,但数据量较小
•
数据更新频繁,但很少被删除
•
随机读写
•
数据一致性非常重要
鉴于这些需求,像Zookeeper这样的高性能键值存储是理想之选。
Metadata storage
元数据存储用于保存配置信息以及主题的属性,包括分区数量、保留周期和副本分布。
元数据更新频率低、数据量小,但对一致性要求很高。Zookeeper 是这种存储场景的不错选择。
ZooKeeper
Zookeeper 是构建分布式消息队列不可或缺的组件。
它是一种分层的键值存储,常用于分布式配置、同步服务以及命名注册表(即服务发现)。
通过这一改动,Broker只需维护消息相关的数据。元数据和状态存储则由Zookeeper负责。
Zookeeper还负责Broker副本的领导者选举。
Replication
在分布式系统中,硬件故障是不可避免的。我们可以通过数据复制来实现高可用性。
•
每个分区都会在多个Broker之间进行复制,但只有一个Leader副本。
•
生产者将消息发送至Leader副本
•
关注者从领导者处拉取已复制的消息
•
当足够多的副本完成同步后,领导者会向生产者返回确认信息
•
每个分区的副本分布方案称为副本分布计划。
•
对于某个分区,由其领导者制定副本分布方案,并将其保存在 Zookeeper 中
In-sync replicas
我们需要解决的一个问题,是在给定的分区中保持领导者与追随者之间的消息同步
同步副本(ISR)是指与分区的领导者保持同步的副本。
该replica.lag.max.messages定义了副本最多可以落后于领导者多少条消息,才被视为处于同步状态。
•
已提交的偏移量为13
•
两条新消息被写入领导者,但尚未提交。
•
当ISR中的所有副本都已同步该消息时,该消息即被提交
•
副本2和副本3已完全追上Leader,因此它们位于ISR中
•
副本4已落后,因此暂时被移出ISR
ISR体现了性能与持久性之间的权衡。
•
为确保生产者不会丢失消息,所有副本在发送确认之前都应保持同步
•
但若某个副本速度过慢,将导致整个分区不可用
确认处理是可配置的。
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
ACK=1表示当领导者收到消息后,生产者就会收到确认。消息发送速度很快,但消息的持久性较低。
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
在消费者端,我们可以将所有消费者都连接到某个分区的领导者,并让它们从该领导者处读取消息:
•
这使得设计最为简单,操作也最为便捷
•
分区中的消息只会被组内的一个消费者消费,这限制了与领导者副本的连接数
•
只要主题的热度不是特别高,与领导者副本的连接数通常不会很多
•
我们可以通过增加分区和消费者数量来扩展热点话题
•
在某些场景下,让某个消费者从ISR中领先可能是合理的,例如当该消费者位于不同的数据中心时
ISR 列表由领导者维护,用于跟踪其与每个副本之间的滞后情况。
Scalability
让我们评估如何对系统的各个部分进行扩展。
生产者
生产者规模远小于消费者。通过增减新的生产者实例即可轻松实现其扩展性。
消费者
各个消费者组之间相互隔离,可以随时灵活地添加或移除消费者组。
再平衡有助于在消费者被添加或从消费组中移除时实现平滑过渡。
消费组的再平衡有助于我们实现可扩展性和容错性。
代理
代理如何处理故障?
•
一旦某个Broker发生故障,仍有足够多的副本,可避免分区数据丢失
•
会选举出新的Leader,Broker协调器将原位于故障Broker上的分区重新分配到现有副本上
•
现有副本会接收新的分区,并作为追随者运行,直到它们追上领导者并成为ISR
为使代理具备容错能力,还需考虑的其他事项:
•
ISR的最小数量在延迟与安全性之间取得了平衡。您可以根据自身需求进行微调。
•
如果某个分区的所有副本都位于同一节点上,就会造成资源浪费。副本应当分布在不同的Broker之间。
•
如果某个分区的所有副本同时宕机,数据将永久丢失。将副本分散部署在不同数据中心固然有所帮助,但会显著增加延迟。一种解决方案是采用数据镜像作为权宜之计。
当新增一个 Broker 时,我们如何处理副本的重新分布?
•
我们可以暂时允许比配置数量更多的副本,直到新节点追上进度
•
待其追上后,我们可以移除不再需要的分区副本
分区
每当新增一个分区时,生产者都会收到通知,并触发消费者重新平衡。
在数据存储方面,我们只能将新消息写入新分区,而无需尝试复制所有旧消息:
减少分区数量更为复杂:
•
一旦某个分区被下线,新消息将仅由剩余的分区接收
•
被下线的分区不会立即被移除,因为仍可从中消费消息
•
当预设的保留期限到期后,我们是否会对数据进行截断并释放存储空间
•
在过渡期间,生产者仅向活跃分区发送消息,而消费者则从所有分区读取
•
一旦保留期限到期,消费者就会进行再平衡
Data delivery semantics
让我们讨论一下不同的消息传递语义。
最多一次
凭借这一保证,消息最多只会被投递一次,也可能根本不会被投递。
•
生产者以异步方式向主题发送消息。如果消息投递失败,则不会进行重试。
•
消费者获取消息后立即提交偏移量。如果消费者在处理消息前崩溃,则该消息将无法被处理。
至少一次
一条消息可以被发送多次,且不应有任何消息未被处理。
•
生产者发送消息时ack=1或者ack=all如果出现任何问题,它会不断重试。
•
消费者在完成消息处理后,才会获取并提交偏移量。
•
如果消费者在提交偏移量之前、但已成功处理消息时发生崩溃,则该消息可能会被重复投递。
•
这就是为什么,在那些可以接受数据重复或能够进行去重的使用场景中,这种方式是不错的选择。
恰好一次
尽管这是对用户最友好的保障,但对系统而言实现成本极高:
Advanced features
让我们讨论一些高级功能,这些内容可能会在面试中被提及。
消息过滤
某些消费者可能只想消费某个分区中特定类型的消息。
可以通过为每类消息子集构建独立的主题来实现,但如果系统存在过多不同的使用场景,这种方式可能会成本高昂。
•
将同一条消息存储在多个主题中是一种资源浪费
•
生产者现在与消费者紧密耦合,因为每当出现新的消费者需求时,它都会随之变化
我们可以通过消息过滤来解决这个问题。
•
一种朴素的做法是在消费者端进行过滤,但这会带来不必要的消费者流量
•
另一种方法是为消息附加标签,让消费者可以指定自己订阅哪些标签
•
过滤也可以通过消息负载来实现,但对加密或序列化的消息而言,这种方式可能既复杂又不安全
•
对于更复杂的数学公式,消息代理可以实现语法解析器或脚本执行器,但这样做可能会使消息队列的负载过于沉重
延迟消息与定时消息
在某些应用场景下,我们可能需要延迟或定时投递消息。例如,我们可以提交一条支付验证任务,设定在30分钟后执行,从而触发消费者去检查该笔支付是否成功。
这可以通过将消息发送到代理中的临时存储,并在适当的时间将其移至目标分区来实现:
•
临时存储可以是一个或多个特殊的消息主题
•
时间调度功能可以通过专用的延迟队列或分层时间轮来实现
步骤4:总结
其他讨论要点:
•
通信协议:重要考量——需支持所有使用场景与高数据吞吐量,并确保消息完整性。常用协议包括 AMQP 和 Kafka 协议。
•
重试消费:如果无法立即处理某条消息,我们可以将其发送到专门的重试主题,以便稍后再次尝试。
•
历史数据归档:旧消息可以备份到高容量存储中,例如HDFS或对象存储(如S3)。