第13章:设计搜索自动补全系统
简介
自动补全,又称“键入即搜”或“增量搜索”,在用户于搜索框中输入时实时提供候选建议。该系统需根据历史查询数据,高效地为用户提供排名靠前的、相关度高且热门的建议。
Key Features
•
建议最多5条自动补全结果.
•
基于查询热度(频率)。
•
仅支持小写英文字母.
•
响应速度快(小于100毫秒)且可扩展。
步骤1:理解问题
Requirements
实时建议:在用户输入时显示相关匹配结果。
Top-k 结果:返回最多5条按热度排序的结果。
可扩展性:应对1000万DAU,峰值QPS达48,000.
高可用性:在发生故障时确保系统不中断。
数据增长:支持每日新增查询数据的存储增长达到0.4 GB。
步骤2:概要设计
从高层次来看,系统被划分为两个服务:
数据采集服务:
◦
实时收集用户查询并对其进行聚合,以进行频率分析。
◦
对于大规模数据集,实时处理并不现实;然而,这不失为一个良好的起点
查询服务:根据用户的输入提供排名靠前的若干条建议。
Data Gathering Service
•
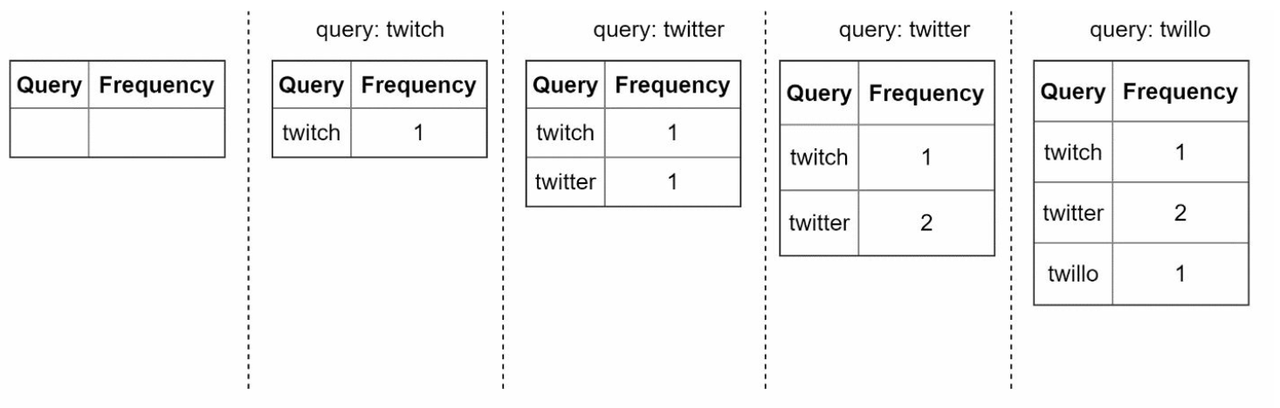
从分析日志中聚合查询数据,并更新频率表。
•
每周处理历史数据,构建一个trie树(前缀树)。
Query Service
52%
48%
•
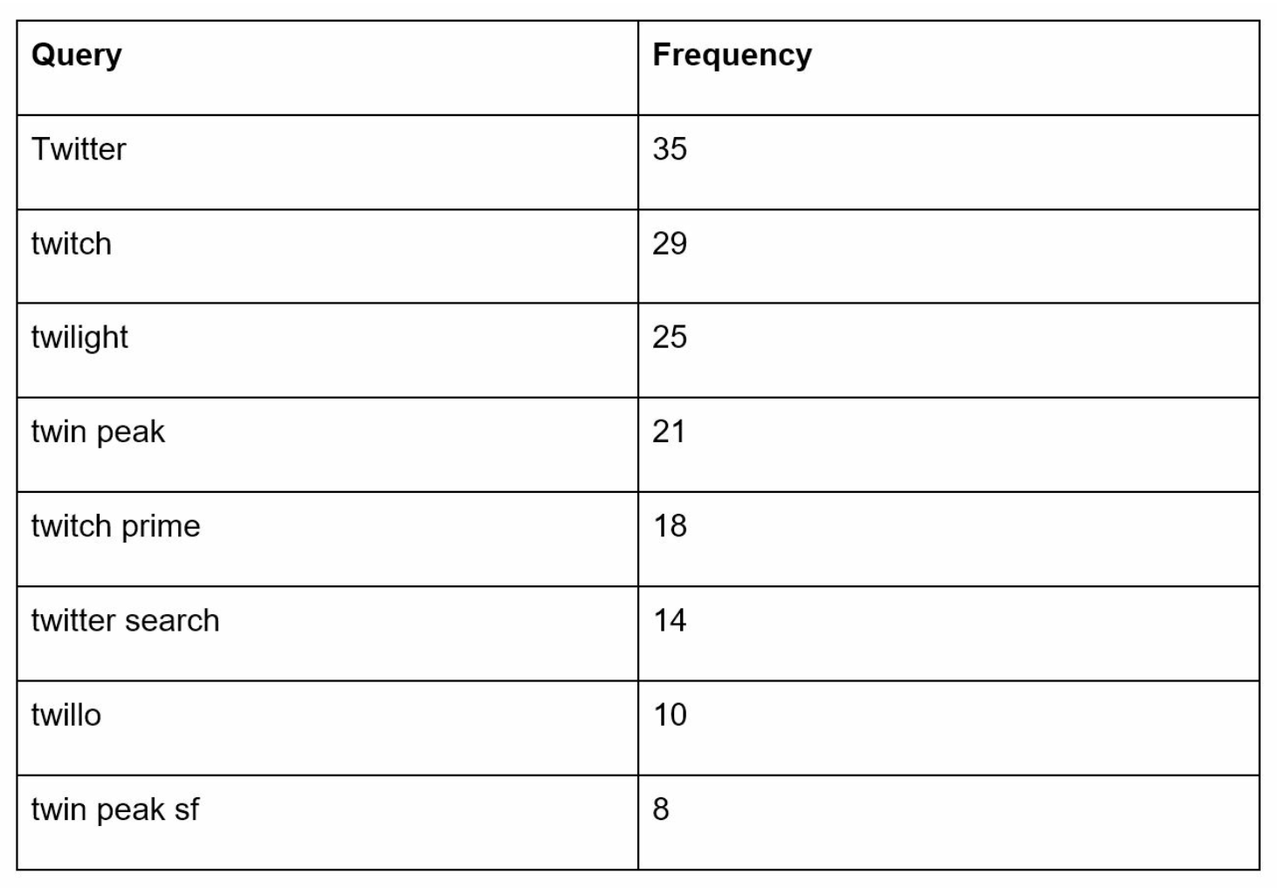
使用数据采集服务生成的频率表。
•
处理用户输入,并通过Trie从频率表中检索前k个建议。
•
通过缓存和高效的数据结构优化了快速查找性能。
•
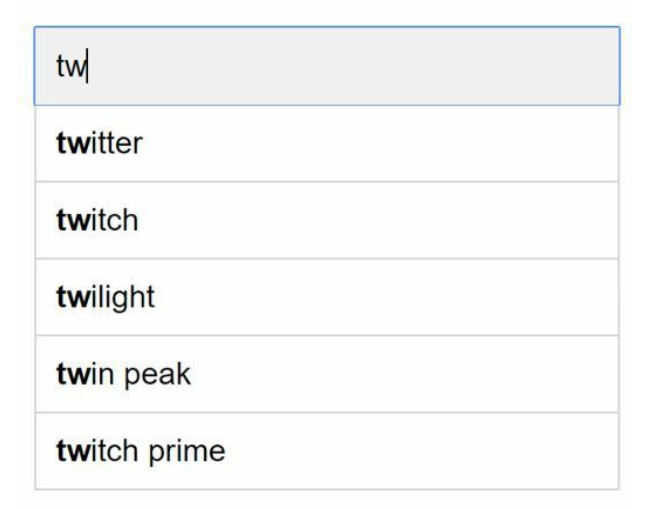
例如,当用户在搜索框中输入“tw”时,系统会显示以下前5条搜索查询。
步骤3:设计深度剖析
Trie Data Structure
字典树是一种树形数据结构,用于高效地存储和检索查询字符串。
关键特性
紧凑存储:以层次化方式表示前缀,以最大限度地减少冗余。
频率信息:存储每个节点处查询的流行度。
获取搜索次数最多的前k个查询的步骤
优化措施:
◦
在每个节点上缓存前k条最热门的查询,以加快检索速度,并避免遍历整个字典树。
Trie 操作
创建:
◦
每周基于聚合查询数据构建。
更新说明:很少进行实时更新;每周更新会替换旧数据。
删除:
Query Processing Flow
前缀搜索:
◦
确定与用户输入对应的前缀节点。
Top-k 排序:
◦
在每个节点缓存前k条推荐结果,以最小化排序开销。
响应构建:
◦
利用缓存数据构建结果,以实现快速响应。
Optimizations
在每个节点上进行缓存:
◦
存储前k条查询结果,以避免重复遍历。
限制前缀长度:
◦
将前缀长度限制为较小值(例如50个字符),以加快查找速度。
AJAX请求:
◦
使用轻量级的异步请求以实现实时响应。
浏览器缓存:
◦
对于频繁搜索的词条,将自动补全结果保存在浏览器缓存中。
Data Gathering Pipeline
在概要设计中,每当用户输入搜索查询时,数据都会实时更新。这种方法并不实用。
•
用户每天可能提交数十亿条查询。每次查询都更新 Trie 树是不可行的。
•
在 Trie 树构建完成后,热门推荐内容可能变化不大。
更新后的设计
分析日志:
◦
将原始查询数据以日志形式存储,用于每周聚合。
◦
日志是追加写的,且不建立索引
聚合器:
◦
将日志处理为频率表,适用于构建前缀树。
◦
对于Twitter等实时应用,应在更短的时间间隔内完成数据聚合。
◦
对于其他情况,可以降低数据聚合的频率,例如每周一次即可。
工作节点:
◦
异步服务器会重建 trie 并将其存储到持久化存储中。
存储选项:
◦
Trie 缓存:Trie 缓存是一种分布式缓存系统,将 Trie 存储在内存中,以实现快速读取。
Scalability
分片:
◦
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
◦
在前缀内进一步分片,以平衡不均衡的分布(例如,aa-ag, ah-an).
负载均衡:
•
使用分片映射管理器将请求路由到相应的服务器。
步骤4:高级功能
Multi-Language Support
Unicode 字符:使用 Unicode 支持非英语语言。
针对不同国家的 Trie:为不同的国家或地区构建独立的 Trie。
Trending Queries
•
通过动态更新Trie节点或对近期查询赋予更高权重来处理实时事件。