第15章:设计Google云端硬盘
简介
Google Drive 是一项基于云的文件存储与同步服务,允许用户通过多种设备存储、访问和共享文件。本章将探讨如何设计一个具备以下特性的可扩展系统:
•
文件上传与下载
•
跨设备文件同步
•
文件共享
•
文件版本历史
•
针对编辑、删除和共享的通知
步骤1:理解问题
Key Requirements
功能需求:
•
上传与下载文件。
•
在多设备间同步文件。
•
维护文件版本历史。
•
支持带权限的文件共享。
•
在文件被编辑、删除或共享时发送通知。
非功能性需求:
•
可靠性:绝不允许数据丢失。
•
快速同步速度:避免因同步延迟而引发用户不满。
•
带宽效率:尽量减少不必要的数据消耗。
•
可扩展性:支持每日活跃用户(DAU)达1000万。
•
高可用性:在服务器故障或网络问题发生时仍能无缝运行。
Constraints and Assumptions
•
用户可获得10 GB免费存储空间.
•
最大文件大小:10 GB.
•
平均文件上传大小:500 KB.
•
上传频率:每位用户每天2个文件.
•
所需总存储容量:500 PB.
步骤2:概要设计
Single-Server Setup
基本架构包括:
Web服务器:负责处理文件的上传与下载。
元数据数据库:用于记录用户数据、登录信息、文件信息等元数据。
存储目录:按命名空间对文件进行组织和存放。
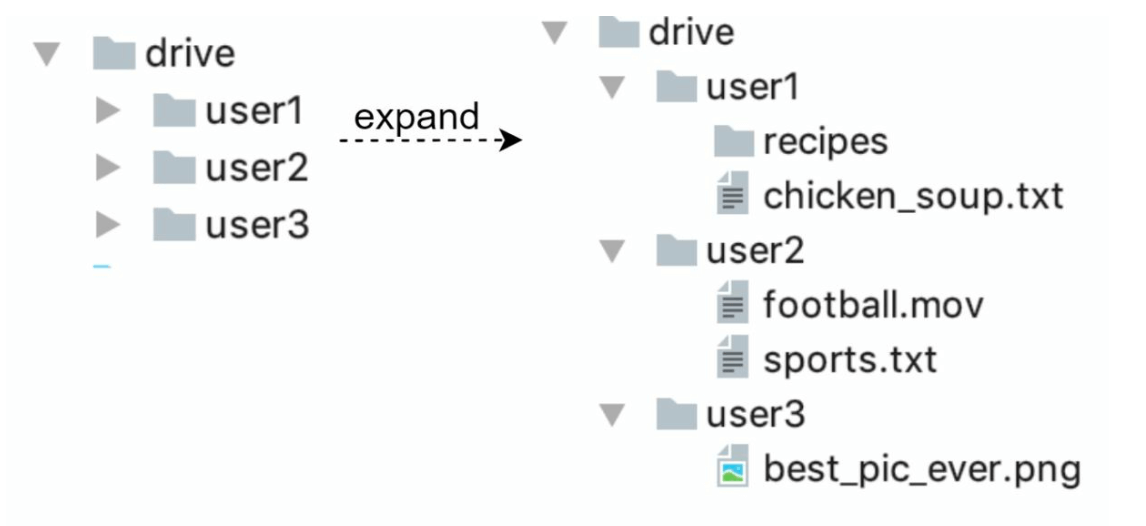
•
已搭建一台Web服务器,并将名为drive/的目录设置为根目录,用于存储上传的文件。
•
在 drive/ 目录下,有一个名为 namespaces 的目录列表。
•
每个命名空间都包含该用户上传的所有文件。
•
每个文件或文件夹都可以通过将命名空间与相对路径拼接起来进行唯一标识。
该设计仅作为起点,但在扩展性方面存在不足。
API接口
将文件上传至 Google 云端硬盘:支持两种上传方式
◦
简单上传:适用于文件尺寸较小的情况。
◦
断点续传:
▪
端点:https://api.example.com/files/upload?uploadType=resumable
▪
发送初始请求以获取可断点续传的URL。
从Google云端硬盘下载文件:用于下载文件
◦
端点:https://api.example.com/files/download
获取文件版本:
◦
端点:https://api.example.com/files/list_revisions
Moving to Distributed Systems
改进措施:
分片:根据……将存储分散到多台服务器上user_id.
Amazon S3:使用S3实现可扩展且冗余的文件存储,并支持跨区域复制。
负载均衡器:将流量分发到多台Web服务器上。
元数据数据库复制:通过数据库分片与复制确保高可用性。
同步冲突:
对于像 Google Drive 这样的大型存储系统,同步冲突时有发生。当两位用户同时修改同一个文件或文件夹时,就会产生冲突。
•
在示例中,用户1和用户2同时尝试更新同一文件,但用户1的文件先被我们的系统处理。
•
用户1的更新操作得以执行,而用户2则遇到了同步冲突。
•
系统同时呈现同一文件的两个副本:用户2的本地副本以及服务器上的最新版本。
•
用户 2 可以选择将两个文件合并,或将其中一个版本覆盖另一个版本。
Improved design
用户交互:用户通过浏览器或移动应用访问该应用程序。
区块服务器:
◦
文件被拆分为4 MB 的数据块(最大尺寸),并为其分配唯一的哈希值。
◦
块以独立方式存储在云存储中(例如,Amazon S3)。
◦
文件重构需要按特定顺序拼接各个块。
云存储:为实现可扩展性和冗余性,块被存储在云存储中。
冷存储:将不常使用的文件移至冷存储,以降低成本。
负载均衡器:在各API服务器之间均匀分配请求,以确保系统高效运行。
API 服务器:
◦
处理用户身份验证、个人资料管理以及文件元数据更新。
◦
管理所有非上传类工作流。
元数据数据库与缓存:
◦
存储用户、文件、区块及版本的元数据。
◦
经常访问的元数据会被缓存,以实现更快的检索。
通知服务:
◦
A发布者/订阅者系统,用于向客户端通知文件的变更(新增、编辑、删除)。
◦
确保客户端能够获取最新的更新。
离线备份队列:临时存储文件变更信息,供离线客户端在重新上线时进行同步。
步骤3:设计深度剖析
Metadata Database
以下展示的是一个高度简化的版本,因为它仅包含最重要的表和字段。
架构设计:
•
用户表:存储用户个人资料和偏好设置。
•
文件表:用于维护文件元数据(如大小、名称、路径等)。
•
块表:用于跟踪文件块,以便重建文件。
•
文件版本表:存储文件的修订历史。
File Upload Flow
文件上传:
◦
文件被拆分为多个块,由块服务器进行压缩并加密。
◦
块被上传至块服务器,并存储在S3中。
元数据上传:
◦
客户端向 API 服务器发送元数据。
◦
元数据以状态形式存储在数据库中pending.
完成:
◦
S3 触发回调,将文件状态更新为uploaded.
◦
通知服务通知相关用户。
File Sync
增量同步:仅传输修改过的块,而非整个文件。
压缩:块会根据文件类型使用相应的压缩算法进行压缩。
冲突解决:
◦
以最先处理的版本为准。
◦
冲突的版本会被单独保存,供用户自行解决。
File Download Flow
当文件在其他地方被添加或编辑时,会触发下载流程。客户端可以通过两种方式获知:
•
如果客户端A处于在线状态,而另一客户端对文件进行了修改,通知服务将向客户端A发送通知。
•
如果客户端A处于离线状态,而另一客户端对文件进行了修改,则数据将被保存到缓存中。当该离线客户端重新上线时,它会拉取最新的更改。
当客户端得知文件已发生变化时,它会先通过 API 服务器请求元数据,然后下载数据块以重建该文件。
触发条件:通知服务将文件更新信息告知客户端。
元数据获取:客户端通过 API 获取更新后的元数据。
区块下载:客户端从区块服务器下载更新后的区块,并重新构建文件。
Notification Service
目的:使客户端及时了解文件的变更情况。
机制:实现长轮询以支持异步通知。
示例:当文件被添加、编辑或删除时,通知将推送给所有相关客户端。
Storage Optimization
去重:通过哈希比对,在账户级别移除重复的区块。
版本管理策略:
◦
限制已保存的修订版本数量。
冷存储:将访问频率极低的文件迁移到更经济的存储方案(如 Amazon S3 Glacier)。
Failure Handling
负载均衡器故障:备用负载均衡器自动启用。
块服务器故障:待处理任务将被重新分配到其他服务器。
元数据数据库故障:
◦
将从节点提升为主节点。
◦
将流量重定向至剩余的副本。
云存储故障:通过跨区域复制获取不可用的文件。
通知服务故障:客户端重新连接到备用服务器。