第20章:指标监控与告警系统
简介
本章重点介绍如何设计一个高度可扩展的指标监控与告警系统,这对于确保系统的高可用性和可靠性至关重要。
第一步:理解问题并明确设计范围
指标监控系统可以指代很多不同的内容——例如,当面试官只关注基础设施指标时,你就不应该去设计日志聚合系统。
让我们先来理解一下问题:
•
C:我们是为谁构建这个系统?是一家大型科技公司的内部监控系统,还是像DataDog这样的SaaS服务?
•
一:我们仅用于内部开发。
•
C:我们希望采集哪些指标?
•
一、运行时系统指标——CPU负载、内存使用量、数据磁盘空间。此外还包括每秒请求数等高层次指标。业务指标不在本讨论范围内。
•
C:我们所监控的基础设施规模有多大?
•
我:日活跃用户1亿,1000个服务器池,每个池100台机器
•
C:我们应该将数据保存多久?
•
I:我们假设数据保留期为1年。
•
C:我们能否降低长期存储的指标数据分辨率?
•
我:将新接收的指标数据保留7天,随后在接下来的30天内按1分钟粒度进行汇总,30天后进一步汇总为1小时粒度。
•
C:支持哪些告警渠道?
•
I:电子邮件、电话、PagerDuty 或 Webhook。
•
C:我们是否需要收集诸如错误日志或访问日志之类的日志?
•
I:否
•
C:我们是否需要支持分布式系统追踪?
•
I:否
High-level requirements and assumptions
被监控的基础设施规模庞大:
•
1亿日活用户
•
1000个服务器池 × 100台机器 × 每台机器约100个指标 → 约1000万个指标
•
1年数据保留
•
数据保留策略——原始数据保留7天,1分钟粒度数据保留30天,1小时粒度数据保留1年
可监控的指标种类繁多:
•
CPU负载
•
请求数量
•
内存使用情况
•
消息队列中的消息数量
Non-functional requirements
•
可扩展性:系统应具备良好的可扩展性,以适应更多指标和告警
•
低延迟:系统需为仪表盘和告警提供低查询延迟
•
可靠性:系统应具备高可靠性,以避免遗漏关键告警
•
灵活性:系统应能在未来轻松集成新技术
哪些需求不在范围之内?
•
日志监控:ELK 技术栈在这一应用场景中非常流行
•
分布式系统追踪:指在请求生命周期贯穿系统内多个服务的过程中,对其相关数据进行采集
步骤2:提出高层次设计方案并获得认可
Fundamentals
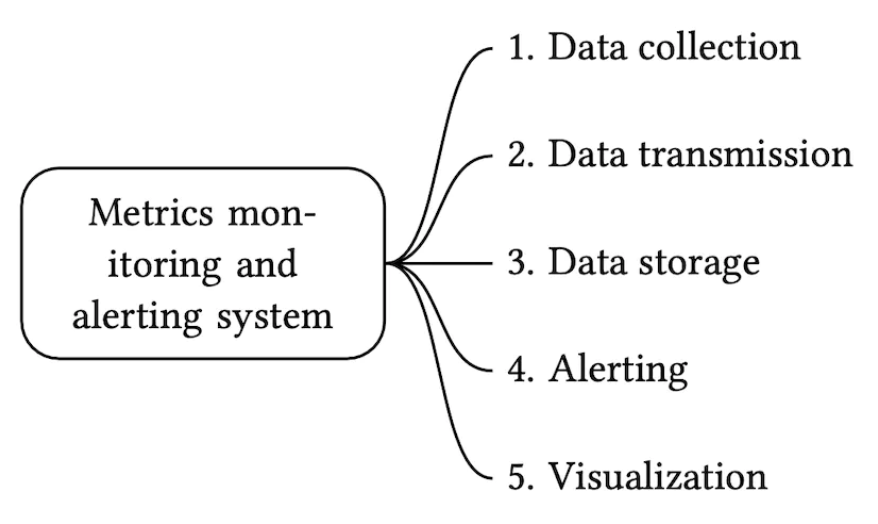
指标监控与告警系统涉及五个核心组件:
•
数据采集:从不同来源收集指标数据
•
数据传输:将数据从各源传输至指标监控系统
•
数据存储:组织并存储传入的数据
•
告警:分析传入的数据,检测异常并生成告警
•
可视化:以图表等形式呈现数据
Data model
指标数据通常以时间序列的形式记录,包含一组带时间戳的数值。该序列可通过名称以及可选的一组标签加以标识。
示例1 - 生产服务器实例i631在20:00时的CPU负载是多少?
数据可以通过下表进行标识:
时序数据由指标名称、标签以及某一特定时间点的单个数据点共同标识。
示例2——过去10分钟内,美国西部地区所有Web服务器的平均CPU负载是多少?
代码块
Plain Text
CPU.load host=webserver01,region=us-west 1613707265 50
CPU.load host=webserver01,region=us-west 1613707265 62
CPU.load host=webserver02,region=us-west 1613707265 43
CPU.load host=webserver02,region=us-west 1613707265 53
...
CPU.load host=webserver01,region=us-west 1613707265 76
CPU.load host=webserver01,region=us-west 1613707265 83
以下是为回答该问题而可能从存储中提取的示例数据。平均 CPU 负载可通过对各行最后一列的数值求平均值得到。
上述格式被称为行协议,被市面上许多流行的监控软件所采用,例如 Prometheus、OpenTSDB。
每个时间序列包含什么:
一种直观展示数据样貌的好方法:
•
横轴表示时间
•
纵轴是你所查询的维度——例如指标名称、标签等。
数据访问模式以写入为主,读取呈突发性特征,因为我们采集了大量指标,但这些指标的访问频率较低,仅在出现持续性故障等情况下才会出现短时高并发访问。
数据存储系统是本设计的核心。
•
不建议为此问题使用通用型数据库,尽管通过专家级调优也能实现良好的扩展性。
•
从理论上讲,使用NoSQL数据库是可行的,但要设计出一种能够有效存储和查询时序数据的可扩展模式却十分困难。
有许多数据库专门用于存储时序数据。其中许多还支持自定义查询接口,从而能够高效地查询时序数据。
•
OpenTSDB 是一款分布式时序数据库,但它基于 Hadoop 和 HBase。如果没有相应的基础设施支撑,使用这项技术会比较困难。
•
Twitter 使用 MetricsDB,而 Amazon 则提供 Timestream。
•
最受欢迎的两款时序数据库分别是 InfluxDB 和 Prometheus。
•
它们旨在存储海量的时间序列数据。两者均基于内存缓存与磁盘存储。
InfluxDB 的典型规模示例——在配备 8 核 CPU 和 32GB 内存的情况下,每秒可处理超过 25 万次写入:
由于指标数据库属于小众技术,通常不指望你对其内部原理了如指掌。只有在你的简历中提及过相关经验时,才可能会被问及。
在面试中,只需了解指标是时序数据,并熟悉一些常见的时序数据库,如 InfluxDB 即可。
时序数据库的一项出色特性,是能够按标签对海量时序数据进行高效聚合与分析。例如,InfluxDB 会为每个标签构建索引。
然而,至关重要的是要保持标签的基数较低——即不要使用过多的唯一标签。
High-level Design
•
指标来源:可以是应用服务器、SQL数据库、消息队列等。
•
指标采集器:收集指标数据并写入时序数据库
•
时序数据库:以时间序列的形式存储指标数据,并提供自定义查询接口,用于分析海量指标。
•
查询服务:便于从时序数据库中查询并获取数据。如果数据库的接口足够强大,也可以完全由其接口替代。
•
告警系统:向各类告警目标发送告警通知。
•
可视化系统:以图表形式展示各项指标。
步骤3:设计深度剖析
让我们深入探讨系统中几个较为有趣的部分。
Metrics collection
对于指标采集而言,偶尔的数据丢失并不严重。客户端可以采用“发射后忘记”的方式。
指标采集有两种实现方式——拉取或推送。
以下是拉取模型的可能示意图:
对于该解决方案,指标采集器需要维护一份最新的服务与指标端点列表。我们可以使用 Zookeeper 或 etcd 来实现这一功能——即服务发现。
服务发现包含有关何时以及从何处采集指标的配置规则:
以下是指标采集流程的详细说明:
•
指标采集器从服务发现系统中获取配置元数据,其中包括采集间隔、IP 地址、超时设置以及重试参数。
•
指标采集器通过预先定义的 HTTP 端点(例如/metrics)拉取指标数据。这通常由客户端库来实现。
•
或者,指标采集器可以向服务发现组件注册变更事件通知,以便在服务端点发生变更时及时获知。
•
另一种方案是让指标采集器定期轮询指标端点的配置变更。
在我们的规模下,仅靠一个指标采集器是远远不够的。必须部署多个实例。然而,这些实例之间还必须实现某种同步机制,以避免两个采集器重复采集同一组指标。
针对这一问题的一种解决方案是:将采集器与服务器部署在一致性哈希环上,并使一组服务器仅关联到单个采集器:
另一方面,采用推送模型时,服务会主动将其指标推送到指标收集器:
在这种方案中,通常会在服务实例旁部署一个采集代理。该代理负责从服务器上采集指标,并将其推送到指标收集器。
采用这种模型,我们可以在将指标发送至采集器之前对其进行聚合,从而减少采集器处理的数据量。
另一方面,指标采集器可能因无法承受负载而拒绝推送请求。因此,务必将该采集器加入位于负载均衡器后的自动伸缩组。
那么哪种方案更好呢?这两种方法各有优劣,不同的系统也会采用不同的实现方式:
•
Prometheus采用拉取式架构
•
Amazon CloudWatch 和 Graphite 采用的是推送式架构
以下是推模式与拉模式之间的一些主要区别:
目前尚无明确的赢家。大型组织很可能需要同时支持两者。而且,最初可能就无法部署推送代理。
Scale the metrics transmission pipeline
无论采用推送模式还是拉取模式,指标采集器都部署在自动伸缩组中。
然而,如果时序数据库宕机,仍存在数据丢失的风险。为降低这一风险,我们将部署一个消息队列机制:
•
指标采集器将指标数据推送到Kafka
•
消费者或流处理服务(如Apache Storm、Flink或Spark)对数据进行处理,并将其写入时序数据库
这种方法具有多项优势:
•
Kafka被用作一个高可靠、可扩展的分布式消息平台
•
它将数据采集与数据处理相互解耦
•
通过在Kafka中持久化数据,可以有效防止数据丢失
Kafka 可以配置为每个指标名称对应一个分区,以便消费者能够按指标名称对数据进行聚合。为了实现扩展,我们还可以进一步按标签/标记进行分区,并对需要优先采集的指标进行分类和优先级排序。
将 Kafka 用于此问题的主要短板在于其维护与运维开销。另一种替代方案是采用诸如Gorilla之类的大型数据摄取系统。可以认为,使用后者在队列处理方面的可扩展性与 Kafka 不相上下。
Where aggregations can happen
指标可以在多个位置进行聚合。不同的选择之间存在权衡:
•
采集代理:客户端采集代理仅支持简单的聚合逻辑。例如,每1分钟统计一次计数器值,并将其上报至指标采集器。
•
数据摄入管道:为了在写入数据库之前对数据进行聚合,我们需要使用像 Flink 这样的流处理引擎。这可以减少写入量,但也会因不存储原始数据而损失数据精度。
•
查询端:我们可以通过可视化系统在执行查询时对数据进行聚合。这种方式不会造成数据丢失,但由于需要处理大量数据,查询速度可能会较慢。
Query Service
将查询服务与时序数据库分离,可以使可视化和告警系统与数据库解耦,从而让我们能够将数据库与客户端解耦,并根据需要自由地进行变更。
我们可以在此处添加缓存层,以减轻时序数据库的负载:
我们甚至可以完全不引入查询服务,因为大多数可视化与告警系统都配备了功能强大的插件,能够与绝大多数时序数据库无缝集成。只要选用合适的时序数据库,我们或许也无需再额外构建自己的缓存层。
大多数时序数据库不支持 SQL,原因在于它在查询时序数据时效率低下。以下是一个用于计算指数移动平均值的 SQL 查询示例:
代码块
Plain Text
以下是使用 Flux 查询语言(InfluxDB 所使用的查询语言)的相同查询:
代码块
Plain Text
Storage layer
谨慎选择时序数据库至关重要。
据Facebook发布的一项研究显示,对运营数据库的查询中,约85%仅涉及过去26小时内的数据。
如果我们选择一种能够利用这一特性的数据库,它将对系统性能产生显著影响。InfluxDB就是这样一个选项。
无论我们选择哪种数据库,都有一些优化措施可供采用。
数据编码与压缩能够显著减小数据的体积。这些功能通常内置于优秀的时序数据库中。
在上述示例中,我们无需存储完整的时间戳,而是可以存储时间戳的差值。
我们还可以采用一种技术,即降采样——将高分辨率数据转换为低分辨率,以减少磁盘占用。
<b我们可以将其用于历史数据,并让数据科学家自定义相关规则,例如:
•
7天 - 无降采样
•
30天 - 降采样至1分钟
•
1年 - 降采样至1小时
例如,这是一张10秒分辨率的指标表:
下采样至30秒分辨率:
最后,我们还可以利用冷存储来保存那些已不再使用的旧数据。冷存储的经济成本要低得多。
Alerting system
配置被加载到缓存服务器中。规则通常以 YAML 格式定义。以下是一个示例:
代码块
Plain Text
- name: instance_down
rules:
# Alert for any instance that is unreachable for >5 minutes.
- alert: instance_down
expr: up == 0
for: 5m
labels:
severity: page
告警管理器从缓存中获取告警配置,并根据配置规则以预设的间隔调用查询服务。当满足某条规则时,将生成一条告警事件。
告警管理器的其他职责包括:
•
对告警进行过滤、合并与去重。例如,当某个实例多次触发同一告警时,仅生成一条告警事件。
•
访问控制——务必将告警管理操作仅限于特定人员
•
重试——管理器确保告警至少被传播一次。
告警存储是一个键值数据库,例如 Cassandra,用于保存所有告警的状态。它确保每条通知至少被发送一次。一旦告警被触发,就会被发布到 Kafka。
最后,告警消费者从 Kafka 中拉取告警数据,并通过多种渠道发送通知——电子邮件、短信、PagerDuty、Webhook 等。
在实际生产环境中,针对告警系统已有许多现成的解决方案。因此,自行在内部构建一套专属系统往往难以获得充分的理由。
Visualization system
可视化系统可在一段时间内展示各项指标与告警信息。以下是一个使用 Grafana 构建的仪表板:
构建一个高质量的可视化系统非常困难。因此,很难不采用像Grafana这样的现成解决方案。
步骤4:总结
以下是我们的最终设计方案: