第22章:酒店预订系统
简介
在本章中,我们将设计一个酒店预订系统,类似于万豪国际集团的系统。
同样适用于其他类型的系统——如Airbnb、航班预订、电影票预订等。
第一步:理解问题并明确设计范围
在着手设计系统之前,我们应当向面试官提问,以明确需求范围:
•
C:系统的规模有多大?
•
我:我们正在为一家拥有5000家酒店、100万间客房的连锁酒店集团搭建网站
•
C:客户是在预订时付款,还是在抵达酒店时付款?
•
I:他们在预订时一次性付清全款。
•
C:客户是否仅通过网站预订酒店房间?我们是否需要支持其他预订方式,例如电话预订?
•
答:他们仅通过网站或应用程序进行预订。
•
C:客户可以取消预订吗?
•
I:需要
•
C:还有其他需要考虑的事项吗?
•
答:是的,我们允许超售10%。酒店会出售比实际客房数量更多的房间,这是为了应对客户可能会取消预订的情况。
•
C:由于时间有限,我们重点讲解——展示酒店相关页面、酒店客房详情页、预订房间、管理后台以及应对超售功能。
•
I:听起来不错。
•
I:还有一点——酒店价格随时变动。假设某间酒店的房价每天都会变化。
•
C:好的。
Non-functional requirements
•
支持高并发——在旺季时,可能会有大量客户同时预订同一家酒店。
•
中等延迟——用户进行预订时,低延迟最为理想,但系统处理耗时几秒也尚可接受。
Back-of-the-envelope estimation
•
总计5000家酒店、100万间客房
•
假设70%的客房被住满,平均入住时长为3天
•
预计每日预约量 - 100万 * 0.7 / 3 = 每日约24万次预约
•
每秒预约量 - 24万 / 一天的10^5秒 = 约3。平均预约TPS较低。
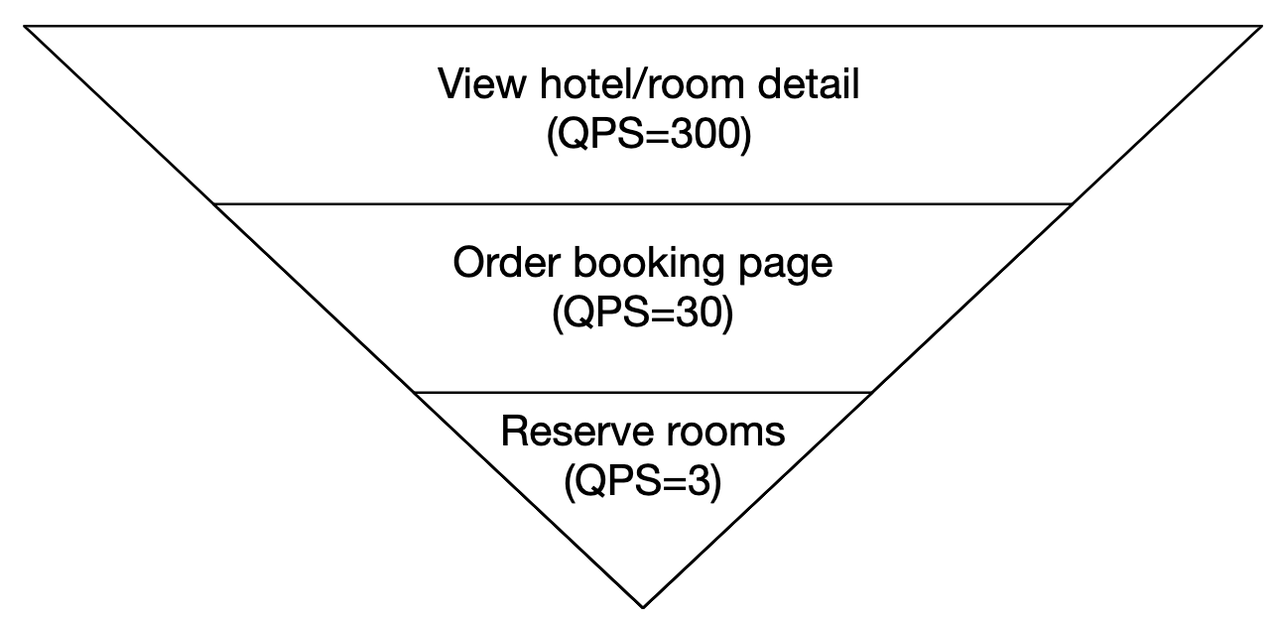
让我们来估算一下 QPS。假设到达预订页面需要经过三个步骤,且每页的转化率为 10%,那么可以推算出:如果有 3 笔预订,就必然对应 30 次预订页面的浏览量,以及 300 次酒店房间详情页的浏览量。
步骤2:提出高层次设计方案并获得认可
我们将探讨——API设计、数据模型与概要设计。
API Design
本API设计聚焦于核心端点(采用RESTful实践),这些端点是支持酒店预订系统所必需的。
一个功能完备的系统需要更丰富的 API,支持按多种条件搜索房间,但本节暂不讨论这一点。原因在于这些功能在技术上并不具挑战性,因此不在讨论范围内。
与酒店相关的API
•
GET /v1/hotels/{id}- 获取酒店的详细信息
•
POST /v1/hotels- 添加新酒店。仅限运维人员使用
•
PUT /v1/hotels/{id}- 更新酒店信息。仅限运维人员使用
•
DELETE /v1/hotels/{id}- 删除酒店。该API仅对运维人员开放
与客房相关的API
•
GET /v1/hotels/{id}/rooms/{id}- 获取房间的详细信息
•
POST /v1/hotels/{id}/rooms- 添加房间。仅限运维人员使用
•
PUT /v1/hotels/{id}/rooms/{id}- 更新房间信息。仅限运维人员使用
•
DELETE /v1/hotels/{id}/rooms/{id}- 删除房间。仅限运维人员使用
与预订相关的API
•
GET /v1/reservations- 获取当前用户的预订历史
•
GET /v1/reservations/{id}- 获取预订的详细信息
•
POST /v1/reservations- 创建新预订
•
DELETE /v1/reservations/{id}- 取消预订
以下是创建预订的示例请求:
代码块
Plain Text
{
"startDate":"2021-04-28",
"endDate":"2021-04-30",
"hotelID":"245",
"roomID":"U12354673389",
"reservationID":"13422445"
}
请注意,reservationID是一个幂等性密钥,用于避免重复预订。相关说明详见并发部分
Data model
在我们选择使用哪种数据库之前,让我们先考虑一下我们的访问模式。
我们需要支持以下查询:
•
查看酒店的详细信息
•
根据日期范围查询可用的房型
•
记录预订
•
查询预订信息或历史预订记录
根据我们的估算,系统的规模并不大,但我们需要为流量激增做好准备。
基于这一认知,我们将选择关系型数据库,因为:
•
关系型数据库在读密集型、写较少的系统中表现良好。
•
NoSQL数据库通常针对写操作进行了优化,但我们也知道,由于只有访问网站的少数用户会进行预订,因此写入量不会很大。
•
关系型数据库提供ACID一致性保证。这对于此类系统至关重要,因为如果没有这些保证,我们就无法避免诸如账户余额为负、重复扣款等问题。
•
关系型数据库能够轻松地对数据进行建模,因为其结构非常清晰。
以下是我们的表结构设计:
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
这种数据模型在像Airbnb这样的系统中表现良好,但在酒店场景下却不太适用,因为用户预订的并非特定房间,而是房间类型。用户预订的是房间类型,而具体的房间号则是在预订时才被分配。
这一不足将在改进后的数据模型部分得到解决。
High-level Design
我们为该设计选择了微服务架构。近年来,这种架构广受欢迎:
•
用户:通过手机或电脑预订酒店房间
•
管理员:执行退款、取消支付等管理功能
•
CDN:缓存静态资源,如JS打包文件、图片、视频等
•
公共API网关:一种全托管服务,支持流量控制、身份认证等功能。
•
内部API:仅对授权人员可见。通常通过VPN进行保护。
•
酒店服务:提供关于酒店及客房的详细信息。由于酒店和客房数据为静态数据,因此可以进行积极的缓存。
•
房价服务:为不同的未来日期提供房价信息。关于该领域的一个有趣之处在于,价格会根据某一天的酒店入住率而有所不同。
•
预订服务:接收预订请求并预留酒店客房。同时,在预订或取消时实时更新客房库存。
•
支付服务:处理付款,并在支付成功后更新预订状态。
•
酒店管理服务:仅限授权人员使用。提供多项管理功能,用于处理和查看预订、酒店等信息。
服务间通信可通过RPC框架实现,例如gRPC。
步骤3:设计深度剖析
让我们深入探讨:
•
改进后的数据模型
•
并发问题
•
可扩展性
•
解决微服务中的数据不一致性
Improved data model
如前文所述,我们需要对 API 和数据模型进行调整,以支持按房间类型而非具体房间进行预订。
对于预订API,我们不再预留一个roomID,但我们预留一个roomTypeID:
代码块
Plain Text
POST /v1/reservations
{
"startDate":"2021-04-28",
"endDate":"2021-04-30",
"hotelID":"245",
"roomTypeID":"12354673389",
"roomCount":"3",
"reservationID":"13422445"
}
以下是更新后的数据模型:
•
room:包含某间房的相关信息
•
room_type_rate:包含特定房型的价格信息
•
预订:记录客人预订信息
•
房型库存:存储酒店客房的库存数据。
让我们来看看room_type_inventory这些列,因为那张表更有趣:
•
hotel_id:酒店的唯一标识
•
room_type_id:房型的唯一标识
•
date:单个日期
•
total_inventory:房间总数减去暂时从房源列表中移除的房间数量。
•
total_reserved:给定(hotel_id、room_type_id、date)下已预订的房间总数
设计这张表还有其他方式,但为每个(hotel_id、room_type_id、date)组合设置一个房间,能够实现便捷的预订管理并简化查询。
表中的行通过每日的CRON作业预先填充。
示例数据:
用于检查某类客房是否可用的示例 SQL 查询:
代码块
Plain Text
SELECT date, total_inventory, total_reserved
如何利用这些数据查询指定数量客房的可用性(请注意,我们支持超售):
代码块
Plain Text
if (total_reserved + ${numberOfRoomsToReserve}) <= 110% * total_inventory
现在我们来对存储容量做一些估算。
•
我们有5000家酒店。
•
每家酒店有20种房型。
•
5000 * 20 * 2(年)* 365(天)= 7300万行
7300万行数据并不算多,单台数据库服务器即可轻松应对。不过,为了实现高可用性,搭建读副本(甚至可以跨多个可用区)仍然是明智之举。
后续问题——如果预订数据量过大,单个数据库无法容纳,你会如何处理?
•
仅存储当前及未来的预订数据。预订历史可移至冷存储。
•
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
Concurrency issues
另一个需要解决的重要问题是对同一笔订单的重复预订。
需要解决两个问题:
•
同一用户两次点击了“预订”按钮
•
多个用户同时尝试预订房间
以下是第一个问题的可视化示意图:
解决这个问题有两种方法:
•
客户端处理——前端可以在用户点击后禁用该书籍按钮。然而,如果用户禁用了 JavaScript,则无法看到按钮变为灰色。
•
幂等API——在API中添加幂等性密钥,使用户无论调用该端点多少次,都只能执行一次操作:
以下是该流程的工作原理:
•
在您填写个人信息并完成预订的过程中,系统会生成一条预订订单。该预订订单将使用全局唯一标识符进行生成。
•
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
•
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。 reservation_id
•
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。 reservation_id
如果有多个用户同时进行同一笔预订,该怎么办?
•
假设事务的隔离级别不是可串行化
•
用户1和用户2同时尝试预订同一间房间。
•
事务1检查是否有足够的房间——确实有
•
事务2检查是否有足够的房间——有
•
事务2预留该房间并更新库存
•
事务1也预留了该房间,因为它仍然看到还有99个房间可用total_reserved总共100个房间。
•
两笔事务都成功提交了更改
这个问题可以通过某种形式的锁机制来解决:
•
悲观锁
•
乐观锁
•
数据库约束
以下是用于预留房间的SQL语句:
代码块
SQL
选项1:悲观锁
悲观锁通过在记录被更新时对其加锁,从而防止同时进行的更新操作。
This can be done in MySQL by using the SELECT... FOR UPDATE query, which locks the rows selected by the query until the transaction is committed.
优点:
•
防止应用程序更新正在被修改的数据
•
实现简单,通过串行化更新来避免冲突。在数据竞争激烈时非常有用。
缺点:
•
当同时锁定多个资源时,可能会发生死锁。
•
这种方法不具备可扩展性——如果某笔事务被长时间锁定,将影响所有其他试图访问该资源的事务。
•
当查询选择的资源数量较多且事务持续时间较长时,其影响非常严重。
作者鉴于该方法存在可扩展性问题,不建议采用此方案。
方案二:乐观锁
乐观锁允许多个用户同时尝试更新同一条记录。
常见的实现方式有两种——版本号和时间戳。由于服务器时钟可能存在误差,建议使用版本号。
•
新增version列已添加到数据库表中
•
在用户修改数据库行之前,会读取版本号
•
当用户更新该行时,版本号加1并写回数据库
•
如果新版本号不高于旧版本号,数据库验证将阻止插入操作
乐观锁通常比悲观锁更快,因为无需对数据库加锁。然而,当并发量较高时,其性能往往会下降,因为会导致大量回滚操作。
优点:
•
它能防止应用程序修改过时的数据
•
我们无需在数据库中加锁
•
当数据竞争较小时的首选方案,即很少出现更新冲突的情况
缺点:
•
当数据竞争激烈时,性能较差
由于预订的QPS并不极高,乐观锁是我们的系统的一个不错的选择。
方案三:数据库约束
这种方法与乐观锁非常相似,但其防护机制是通过数据库约束来实现的:
代码块
Plain Text
CONSTRAINT `check_room_count` CHECK((`total_inventory - total_reserved` >= 0))
优点:
•
易于实现
•
在数据竞争较小时表现良好
缺点:
•
与乐观锁类似,当数据竞争激烈时性能较差
•
数据库约束难以像应用代码那样进行版本控制
•
并非所有数据库都支持约束
由于实现简便,这又是酒店预订系统的一个不错的选择。
Scalability
通常,酒店预订系统的负载并不高。
然而,面试官可能会问你,如果该系统被一家规模更大、更受欢迎的旅游网站(如booking.com)所采用,你会如何应对?在这种情况下,QPS可能会高出1000倍。
遇到这种情况时,关键在于弄清楚我们的瓶颈究竟在哪里。所有服务都是无状态的,因此可以通过复制轻松实现水平扩展。
然而,数据库是有状态的,其扩展方式并不那么直观。
一种扩展方案是通过实施数据库分片——我们可以将数据分散到多个数据库中,每个数据库仅存储部分数据。
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。 hotel_id
我们还可以通过 Redis 对客房库存和预订信息进行缓存。我们可以设置 TTL,使过期数据在数天后自动失效。
我们存储库存的方式基于hotel_id, room_type_id以及date:
代码块
Plain Text
key: hotelID_roomTypeID_{date}
value: the number of available rooms for the given hotel ID, room type ID and date.
数据一致性以异步方式实现,并通过 CDC 流式机制进行管理——数据库的变更会被读取并应用到另一个独立系统中。Debezium 是一种广受欢迎的工具,用于将数据库变更与 Redis 进行同步。
采用这种机制时,缓存与数据库在一段时间内可能存在不一致的情况。但在我们的场景中这并无大碍,因为数据库会阻止我们进行无效的预订操作。
这会在界面上引发一些问题,因为用户需要刷新页面才能看到“已无可用房间”的提示;不过,即使不存在这个问题,类似情况也可能发生,例如当用户在预订前犹豫不决时。
缓存的优点:
•
降低数据库负载
•
高性能,因为 Redis 将数据存储在内存中
缓存的缺点:
•
在缓存与数据库之间保持数据一致性非常困难。我们需要考虑这种不一致对用户体验的影响。
Data consistency among services
单体应用使我们能够使用共享的关系型数据库来确保数据的一致性。
在我们的微服务设计中,我们采用了一种混合模式:部分服务独立部署,而预订与库存相关的 API 则由同一服务统一处理。
之所以这样做,是因为我们希望利用关系型数据库的ACID特性来确保数据的一致性。
然而,面试官可能会对这种做法提出质疑,因为它并非纯粹的微服务架构——在那种架构中,每个服务都拥有独立的数据库:
这可能会导致一致性问题。在单体服务器中,我们可以利用关系型数据库的事务功能来实现原子操作:
然而,当操作跨多个服务时,要保证这种原子性就更加困难了:
有一些广为人知的技巧可用于处理这些数据不一致性:
•
两阶段提交:一种数据库协议,可在多个节点间确保事务的原子性提交。不过,其性能并不理想,因为只要有一个节点出现延迟,所有节点都会阻塞该操作。
•
Saga:一系列本地事务,当工作流中的任一步骤失败时,会触发补偿事务。这是一种最终一致性的解决方案。
值得注意的是,解决微服务之间的数据一致性问题是一项颇具挑战性的任务,这会显著增加系统的复杂性。鉴于我们采取更为务实的做法——将相关联的操作封装在同一张关系型数据库中——有必要审慎评估这一方案的投入是否值得。
步骤4:总结
我们提出了一种酒店预订系统的设计方案。
我们遵循的步骤如下:
•
收集需求并进行粗略估算,以了解系统的规模
•
我们在概要设计中介绍了API设计、数据模型和系统架构
•
在深入探讨环节,我们随着需求变化研究了多种备选的数据库模式设计
•
我们讨论了竞态条件并提出了相应的解决方案——悲观锁/乐观锁、数据库约束
•
通过数据库分片和缓存来实现系统扩展的途径
•
最后,我们讨论了如何解决跨多个微服务的数据一致性问题