第25章:设计实时游戏排行榜
简介
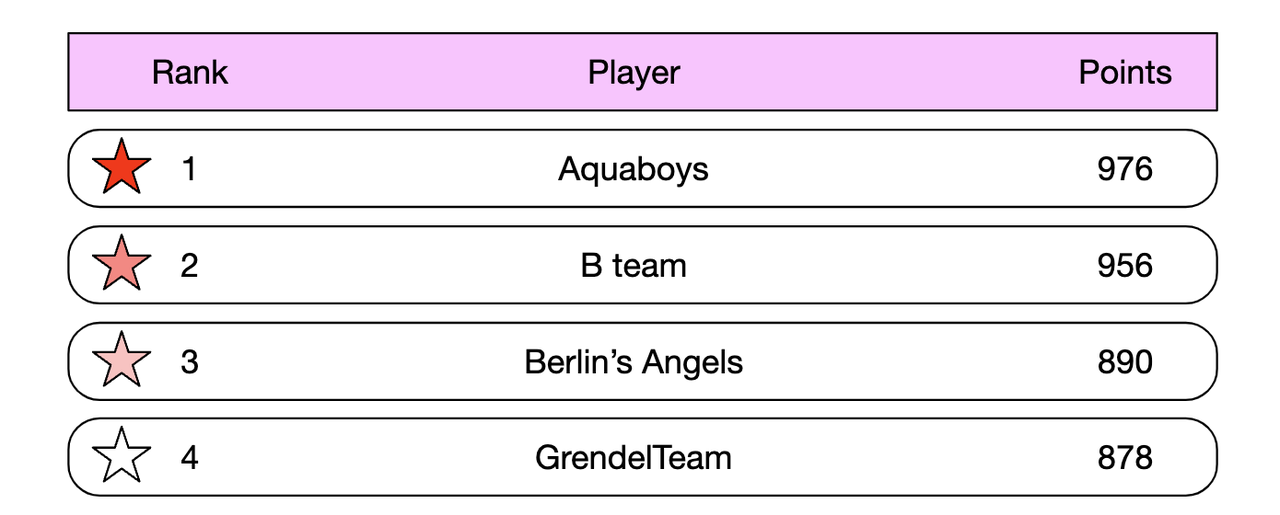
我们将为一款在线手游设计一个排行榜:
步骤2:提出高层次设计方案并获得认可
API Design
我们首先需要一个用于更新用户分数的API:
代码块
Plain Text
POST /v1/scores
该API接收两个参数 -user_id以及points用于计算游戏获胜得分。
该API应仅限游戏服务器访问,终端客户端不得调用。
下一个用于获取排行榜前10名玩家:
代码块
Plain Text
GET /v1/scores
示例响应:
代码块
Plain Text
{
"data": [
{
"user_id": "user_id1",
"user_name": "alice",
"rank": 1,
"score": 12543
},
{
"user_id": "user_id2",
"user_name": "bob",
"rank": 2,
"score": 11500
}
],
...
"total": 10
}
您也可以获取某位用户的分数:
代码块
Plain Text
GET /v1/scores/{:user_id}
示例响应:
代码块
Plain Text
{
"user_info": {
"user_id": "user5",
"score": 1000,
"rank": 6,
}
}
High-level architecture
•
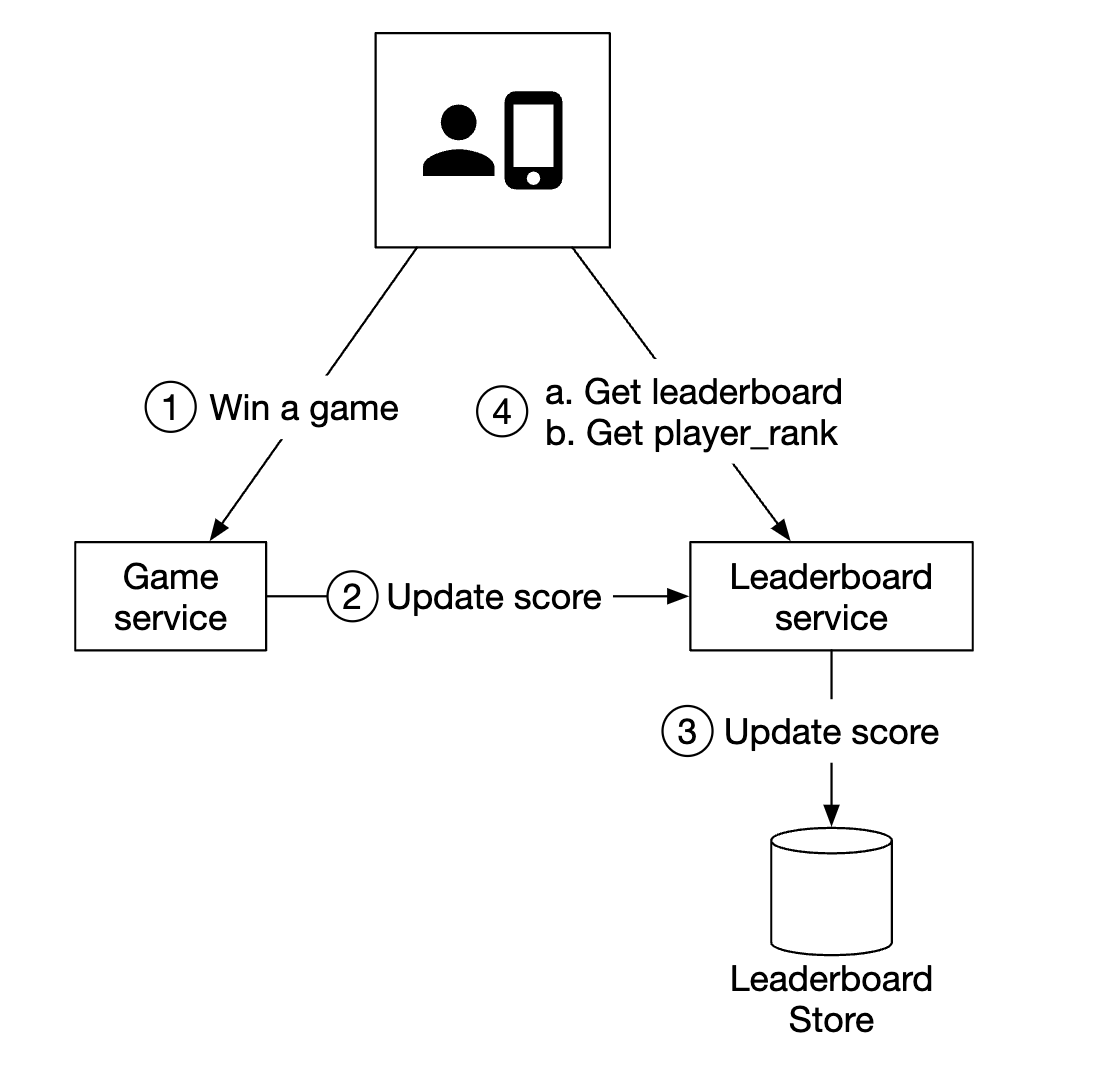
当玩家赢得一局游戏时,客户端向游戏服务发送请求
•
游戏服务验证胜利是否有效,并调用排行榜服务以更新玩家的分数
•
排行榜服务在排行榜存储中更新用户的分数
•
玩家调用排行榜服务以获取排行榜数据,例如前10名玩家及指定玩家的排名
曾考虑的一种替代方案是:客户端直接在排行榜服务中更新其得分:
此选项并不安全,因为它容易受到中间人攻击。玩家可以设置代理,并随意篡改自己的分数。
另外需要说明的一点是,在游戏场景中,由于游戏逻辑由服务器负责维护,客户端无需显式调用服务器即可记录其胜负结果。服务器会根据游戏逻辑自动完成这一操作。
还有一个需要考虑的问题是:是否应在游戏服务器与排行榜服务之间部署消息队列。如果其他服务也对游戏结果感兴趣,这将很有用,但到目前为止,面试中并未明确提出这一需求,因此设计中暂未纳入:
Data models
让我们讨论一下存储排行榜数据的几种方案——关系型数据库、Redis 和 NoSQL。
NoSQL 方案将在深度剖析部分进行详细探讨。
关系型数据库解决方案
如果规模无关紧要,且用户数量不多,关系型数据库就能很好地满足我们的需求。
We can start from a simple leaderboard table, one for each month (personal note - this doesn't make sense. You can just add a month column and avoid the headache of maintaining new tables each month):
其中还包含一些额外的数据,但这些数据与我们即将执行的查询无关,因此被省略了。
当用户获得一分时会发生什么?
如果用户尚未存在于表中,我们需要先将其插入:
代码块
Plain Text
INSERT INTO leaderboard (user_id, score) VALUES ('mary1934', 1);
在后续调用中,我们只需更新其分数:
代码块
Plain Text
UPDATE leaderboard set score=score + 1 where user_id='mary1934';
我们如何找出排行榜的顶级玩家?
我们可以执行以下查询:
代码块
Plain Text
SELECT (@rownum := @rownum + 1) AS rank, user_id, score
FROM leaderboard
<b不过,这种方式性能并不理想,因为它会执行全表扫描,以对数据库表中的所有记录进行排序。
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
代码块
Plain Text
SELECT (@rownum := @rownum + 1) AS rank, user_id, score
FROM leaderboard
ORDER BY score DESC
LIMIT 10;
然而,如果用户并未位居排行榜榜首,且您希望查询其排名,这种方法的扩展性并不理想。
Redis 解决方案
我们希望找到一种解决方案,即使面对数百万玩家也能良好运行,而无需依赖复杂的数据库查询。
Redis 是一种内存数据存储,由于其在内存中运行,因此速度极快,并且拥有适合满足我们需求的数据结构——有序集合。
有序集合是一种类似于编程语言中集合的数据结构,它允许你按照特定的排序准则保持数据结构的有序性。在内部,它通过哈希表来维护键(user_id)与值(score)之间的映射,并使用跳表按分数对用户进行排序:
跳表是如何工作的?
•
它是一种链表,能够实现快速查找
•
它由一个有序链表和多级索引组成
这种结构使我们在数据集足够大时能够快速查找特定值。在下方示例中(64个节点),在普通链表中需遍历62个节点才能找到目标值,而在跳表中则只需遍历11个节点:
与关系型数据库相比,有序集合的性能更优,因为它始终以排序状态存储数据,但代价是每次插入和查找操作的时间复杂度为 O(logN)。
作为对比,以下是一个我们在关系型数据库中需要执行的嵌套查询示例,用于查找指定用户的排名:
代码块
Plain Text
SELECT *,(SELECT COUNT(*) FROM leaderboard lb2
WHERE lb2.score >= lb1.score) RANK
FROM leaderboard lb1
WHERE lb1.user_id = {:user_id};
我们在 Redis 中实现排行榜需要哪些操作?
•
ZADD——如果用户不存在,则将其插入集合;否则,更新其分数。时间复杂度为 O(logN)。
•
ZINCRBY——将用户的分数按指定数值递增。若用户不存在,则分数从零开始。时间复杂度为 O(logN)。
•
ZRANGE/ZREVRANGE——获取指定范围内的用户列表,并按其得分排序。我们可以指定排序顺序(升序/降序)、偏移量以及返回结果的数量。时间复杂度为 O(logN+M),其中 M 为返回结果的数量。
•
ZRANK/ZREVRANK——获取指定用户在升序/降序排列中的位置(排名)。时间复杂度为O(logN)。
当用户获得一分时,会发生什么?
代码块
Plain Text
ZINCRBY leaderboard_feb_2021 1 'mary1934'
每月都会创建一个新的排行榜,旧的排行榜则被移至历史存储。
当用户查询排名前10的玩家时,会发生什么?
代码块
Plain Text
示例结果:
代码块
Plain Text
[(user2,score2),(user1,score1),(user5,score5)...]
那么用户查询自己的排行榜位置呢?
只要我们知道用户的排行榜排名,就可以通过以下查询轻松实现:
代码块
Plain Text
ZREVRANGE leaderboard_feb_2021 357 365
A user's position can be fetched using ZREVRANK
Let's explore what our storage requirements are:
•
假设在某个月份,全部2500万月活跃用户都参与游戏的最坏情况
•
ID 是 24 位字符的字符串,分数是 16 位整数,我们需要 26 字节 × 2500 万 = 约 650 MB 的存储空间
•
即使由于跳表的额外开销使存储成本翻倍,这仍然可以轻松容纳在现代 Redis 集群中
另一个需要考虑的非功能性需求是支持每秒2500次更新。这完全在单台Redis服务器的处理能力范围内。
其他注意事项:
•
我们可以部署一个Redis副本,以避免在Redis服务器宕机时丢失数据
•
我们仍然可以利用 Redis 的持久化功能,以防止在发生崩溃时丢失数据
•
我们需要在 MySQL 中创建两张辅助表,用于查询用户的详细信息,如用户名、显示名称等,以及记录诸如用户何时赢得一局游戏之类的事件
•
当基础设施发生故障时,MySQL中的第二张表可用于重建排行榜
•
作为一项小型性能优化,我们可以缓存排名前10位玩家的用户详情,因为这些数据会被频繁访问
步骤3:设计深度剖析
To use a cloud provider or not
我们可以选择自行部署并管理我们的服务,也可以使用云服务商来代为管理。
如果我们选择自行管理各项服务,将使用 Redis 存储排行榜数据,用 MySQL 存储用户个人资料,并在需要扩展数据库性能时,为用户个人资料引入缓存:
或者,我们也可以借助云服务来帮我们管理许多基础服务。例如,我们可以使用 AWS API Gateway 将 API 调用路由到 AWS Lambda 函数:
AWS Lambda 让我们无需自行管理或预置服务器即可运行代码。它仅在需要时执行,并能自动扩展。
示例:用户得分:
用户获取排行榜的示例:
Lambda 是无服务器架构的一种实现。我们无需管理扩展和环境配置。
作者建议,如果从零开始构建这款游戏,不妨采用这种方式。
Scaling Redis
在日活跃用户数为500万的情况下,从存储和QPS两个维度来看,我们都可以仅使用一个Redis实例。
然而,如果假设用户规模增长10倍,达到5亿日活跃用户,那么存储所需容量将增至65GB,QPS也将飙升至25万。
如此规模将需要采用分片技术。
实现这一目标的一种方法是对数据进行范围分区:
在本示例中,我们将根据用户的得分进行分片。我们将在应用代码中维护user_id与分片之间的映射关系。这一映射既可以通过MySQL实现,也可以借助其他缓存来完成。
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
为了获取用户的排名,我们需要先计算该用户所在分片内的排名,再将其他分片中所有分数高于该用户的用户的排名相加。后者是一项 O(1) 操作,因为可以通过 info 键空间命令快速访问每个分片的总记录数。
或者,我们也可以通过 Redis 集群采用哈希分区。它是一种代理,能够基于类似于一致性哈希的分区策略将数据分散到各个 Redis 节点上,但并不完全相同:
在这种架构下,计算排名前10的玩家颇具挑战性。我们需要先获取每个分片的前10名玩家,然后在应用层将结果进行合并:
<b 哈希分区存在一些局限性:
•
如果需要获取前K个用户,且K值较大,由于需要从所有分片中检索大量数据,延迟可能会增加
•
随着分区数量的增加,延迟也会随之上升
•
并没有一种直接的方法来确定用户的排名
鉴于上述种种情况,作者倾向于为此问题采用固定分区的方案。
其他注意事项:
•
最佳实践是为写密集型的 Redis 节点分配两倍于实际需求的内存,以便在必要时支持快照操作
•
我们可以使用名为 Redis-benchmark 的工具来监控 Redis 集群的性能,并据此做出数据驱动的决策
Alternative solution: NoSQL
另一种值得考虑的解决方案是选用一款针对以下场景进行了优化的合适 NoSQL 数据库:
•
大量写入
•
在同一个分区中按分数对条目进行有效排序
DynamoDB、Cassandra 或 MongoDB 都是不错的选择。
在本章中,作者决定使用 DynamoDB。它是一款全托管的 NoSQL 数据库,具备可靠的性能和出色的可扩展性。此外,在需要查询非主键字段时,它还支持使用全局二级索引。
我们先从一张用于存储国际象棋排行榜的表开始:
这种方式效果不错,但如果需要按分数进行查询,扩展性就不太理想。因此,我们可以将分数作为排序键:
这种设计的另一个问题在于,我们按月进行分区。这会导致热点分区,因为最新月份的访问量会明显高于其他月份。
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
一个需要考虑的重要权衡是:我们应该使用多少个分区?
•
分区数量越多,写入的可扩展性就越高
•
然而,由于我们需要查询更多分区以汇总结果,读取的可扩展性会受到影响
采用这种方法时,我们需要使用前面介绍过的“散播-收集”技术,而随着分区数量的增加,其时间复杂度也会随之上升:
要对分区数量做出准确评估,我们需要进行一些基准测试。
这种NoSQL方案仍有一个主要的缺点——很难计算出某个用户的精确排名。
如果我们的规模大到需要进行分片,那么我们或许可以告知用户他们的得分位于哪个“百分位”。
可以定期运行一个 Cron 作业来分析分数分布,并据此确定用户的百分位,例如:
代码块
Plain Text
10th percentile = score < 100
20th percentile = score < 500
步骤4:总结
若时间允许,还可讨论的其他事项:
•
这是一个 GitHub 仓库页面,标题为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”。上下文。
•
打破平局- 当两名玩家得分相同时,我们可以通过按其最近一局的对战时间进行排序来打破平局。
•
系统故障恢复- 在发生大规模 Redis 故障时,我们可以通过遍历 MySQL 的 WAL 日志条目,并借助临时脚本重新构建排行榜