第6章:设计键值存储系统
简介
键值存储是一种非关系型数据库,其中数据以键值对的形式存储。每个键都是唯一的,可通过这些键访问对应的值。本章详细介绍了如何设计一个可扩展、高可用的分布式键值存储系统,该系统支持诸如以下操作:
•
put(key, value)用于插入数据。
•
get(key)用于检索数据。
单服务器键值存储
Implementation
•
使用哈希表在内存中存储键值对。
•
优化措施:数据压缩、将访问频率较低的数据存储在磁盘上。
Limitation
单台服务器的内存有限,因此需要采用分布式架构来实现扩展性。
分布式键值存储
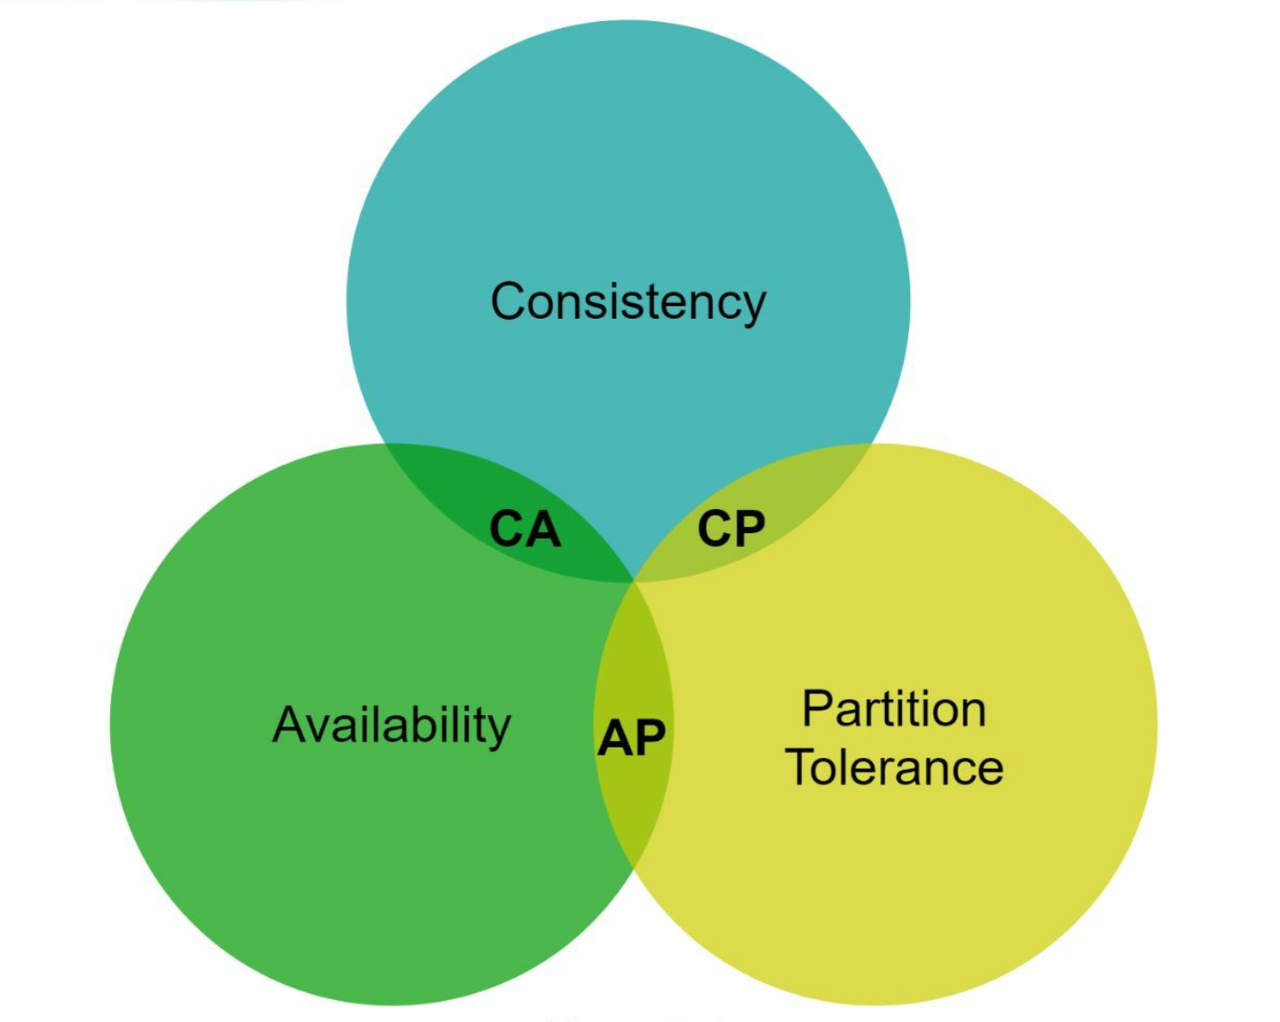
A分布式键值存储会将数据分散存储于多台服务器上,并且必须权衡CAP定理.
CAP Theorem
一致性:所有客户端同时看到相同的数据。
可用性:系统对每个请求都能作出响应,即使部分节点发生故障。
分区容错性:即使发生网络分区,系统仍能继续运行。
权衡:根据 CAP 定理,三个特性中最多只能同时满足其中两个。
50%
50%
系统类型:
•
CP 系统:在牺牲可用性的前提下,同时保证一致性和分区容错性(例如银行系统)。
•
AP 系统:在牺牲一致性(例如最终一致性)的前提下,保证可用性和分区容错性。
•
CA 系统:在牺牲分区容错性的前提下,保证一致性和可用性。
•
由于网络故障不可避免,分布式系统必须能够容忍网络分区。因此,在现实世界的应用中,CA 系统并不存在。
•
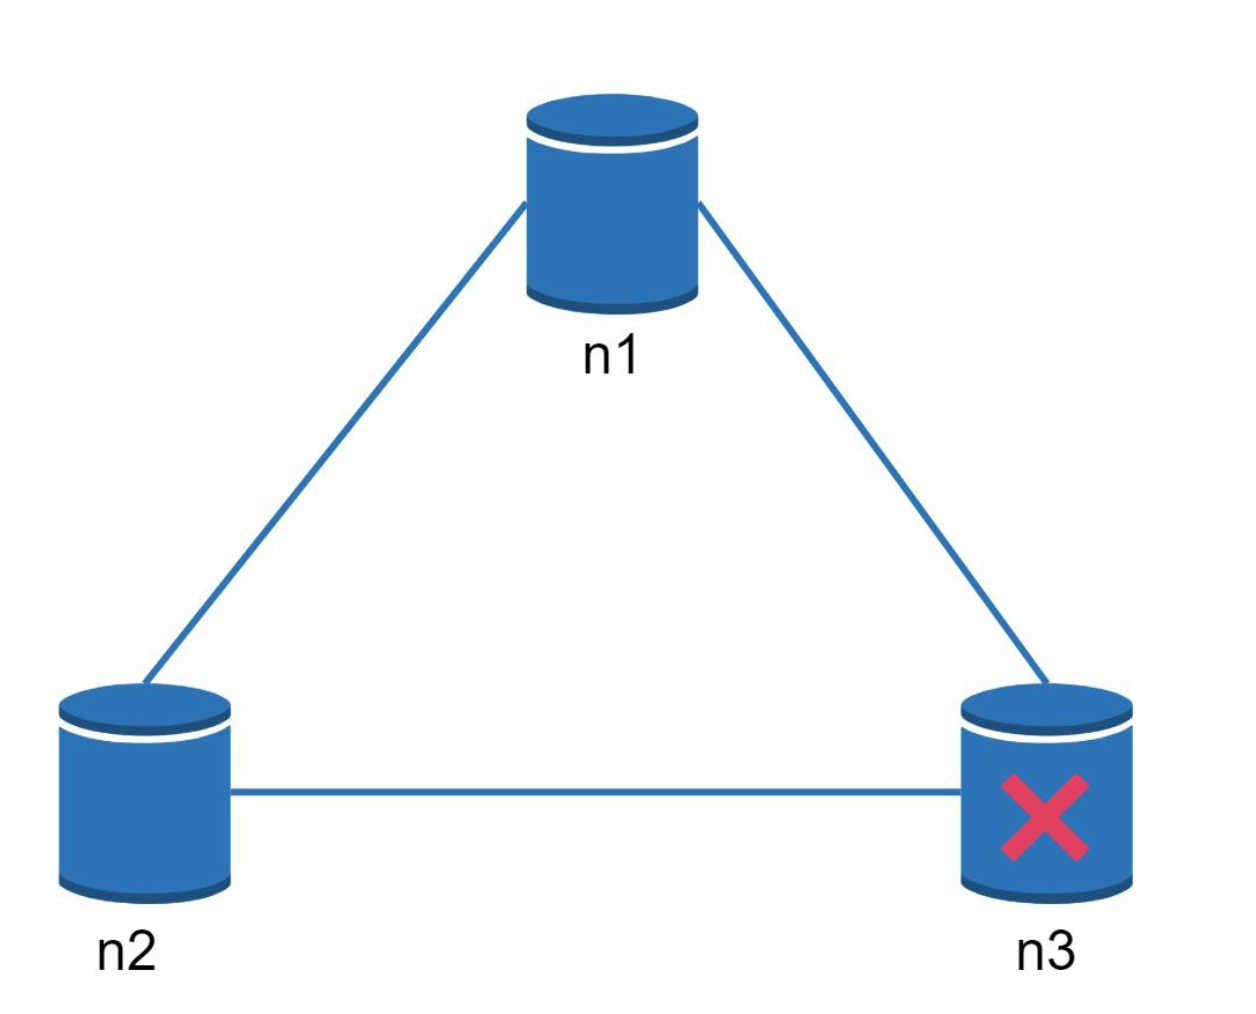
在分布式系统中,分区是不可避免的。当发生分区时,我们必须在一致性与可用性之间做出权衡。例如,如果节点n3宕机,则写入节点n1或n2的数据将无法同步到n3。反之,如果数据已写入n3但尚未同步到n1和n2,那么n1和n2上就会存储过时的数据。
50%
50%
•
如果我们选择CP系统,则必须阻止对n1和n2的所有写操作,以避免数据不一致。
•
如果我们选择 AP 系统,系统会持续接受读请求,尽管可能会返回旧数据。对于写操作,n1 和 n2 会继续接受写入,待网络分区解除后,数据将同步至 n3。
系统组件
Data Partitioning
•
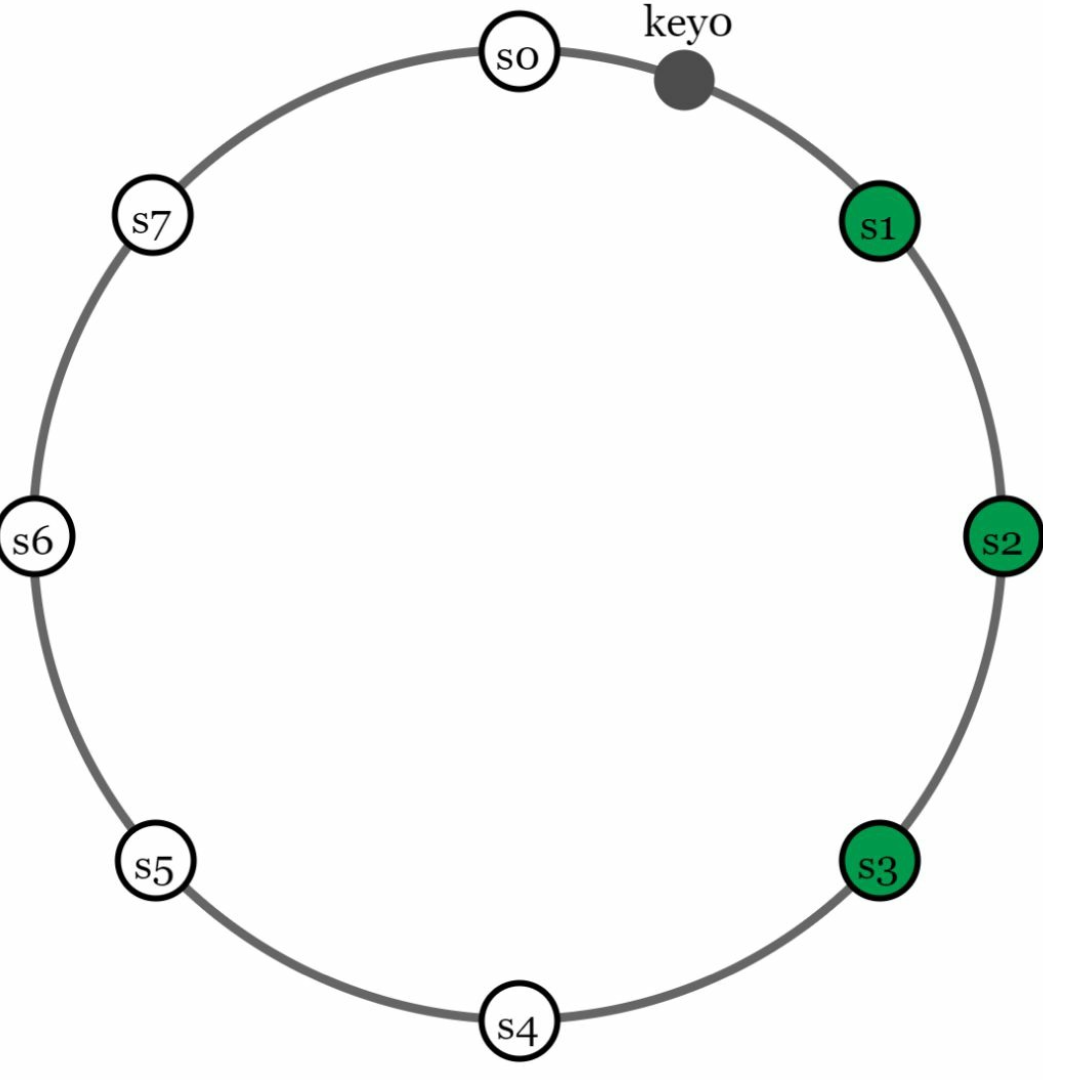
技术:采用一致性哈希算法,将数据均匀地分布到多台服务器上。
•
优势:
◦
通过增减服务器实现自动扩展。
Data Replication
•
在N之间复制数据以实现高可用性。
•
通过从服务器位置沿顺时针方向遍历,选择环上前N个服务器来存储数据副本。为提高在虚拟节点发生故障时的可靠性,应将副本放置于不同的数据中心。
Consistency
由于数据在多个节点上被复制,因此必须在各副本之间进行同步。
•
法定人数共识:
◦
N:总副本数。
◦
这是一个 GitHub 仓库页面,标题为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”。上下文。
◦
这是名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
◦
规则: W + R > N确保强一致性。
◦
W、R 和 N 的配置是延迟与一致性之间的一种典型权衡。
•
模型::
◦
强一致性:读操作返回的值对应于最新写入的数据项的结果。
◦
弱一致性:后续的读操作可能无法看到最新的值。
◦
最终一致性:经过足够的时间,所有更新都会被传播,所有副本都将保持一致
Inconsistency Resolution
复制能够提供高可用性,但会导致各副本之间出现不一致。版本控制和向量锁用于解决不一致性问题。
•
版本控制:
◦
使用向量时钟来跟踪数据版本并解决冲突。
◦
版本化意味着将每一次数据修改都视为数据的一个新的不可变版本。
44%
56%
◦
服务器1更改了名称,服务器2也更改了名称。这两项更改同时进行。此时,我们出现了冲突的值,分别称为版本v1和v2。
•
向量时钟
a.
设置:向量时钟是一个与数据项关联的[服务器, 版本]对。它可以用于判断某个版本是否先于、后于或与其他版本发生冲突。
▪
假设一个向量时钟由 D([S1, v1], [S2, v2], …, [Sn, vn]) 表示。如果数据项 D 被写入服务器 Si,则系统必须执行以下操作之一。
•
挑战:
◦
客户端复杂度增加。
◦
向量时钟的大小可能随着大量更新而增长,因此需要采用修剪策略来限制其规模。
Handling Failures
故障检测
仅仅因为另一台服务器说某台服务器宕机,是不够的。通常,要将一台服务器标记为宕机,至少需要两个独立的信息来源。
•
Gossip 协议:
b. 临时故障
•
粗略的法定人数:暂时利用健康节点维持系统运行。
在检测到故障后,系统需要部署相应机制以确保可用性
系统并未强制执行多数派一致性要求,而是在哈希环上为写操作选择前W个健康节点,为读操作选择前R个健康节点。
离线服务器会被忽略。如果某台服务器不可用,其他服务器将临时处理请求
•
提示式接管:离线服务器在恢复后会追上最新变更。
◦
当宕机的服务器恢复上线时,系统将推送变更以实现数据一致性
c. 永久故障
•
使用默克尔树实现副本之间的高效同步。一个默克尔树(或哈希树)是一种数据结构,能够在发生永久性故障时高效地检测并解决副本间的不一致问题。
•
运行中
a.
结构:
▪
叶节点存储各个数据块的哈希值。
▪
非叶节点存储其子节点的哈希值。
▪
根哈希代表树中所有数据的综合状态。
b.
构建默克尔树:
▪
步骤1:将键空间划分为多个桶。
•
优势
◦
效率:仅同步不一致的数据,从而减少数据传输量。
◦
可扩展性:适用于大数据集,且同步开销极低。
◦
可靠性:确保各副本之间的数据一致性。
Handling Data Center Outages
•
在多个数据中心之间复制数据,以确保在发生故障时仍能提供服务。
写入与读取路径
Write Path (Based on Cassandra architecture)
•
将写入操作持久化到提交日志.
•
将数据保存到内存缓存.
•
当缓存满时,将数据刷写到SSTable(排序字符串表)中。
Read Path
50%
50%
•
检查数据的内存缓存。
•
若不存在,则使用Bloom Filter在SSTables中定位数据。
•
获取并返回数据。
最终架构
•
客户端通过简单的API与键值存储进行通信:get(key) 和 put(key, value)。
•
协调器是一个节点,充当客户端与键值存储之间的代理。
•
节点通过一致性哈希算法分布在环上。
•
系统完全去中心化,因此节点的加入与迁移均可自动完成。
•
数据在多个节点上进行复制。
•
不存在单点故障,因为每个节点都承担相同的职责。