第24章:类S3的对象存储
简介
在本章中,我们将设计一种对象存储服务,类似于Amazon S3.
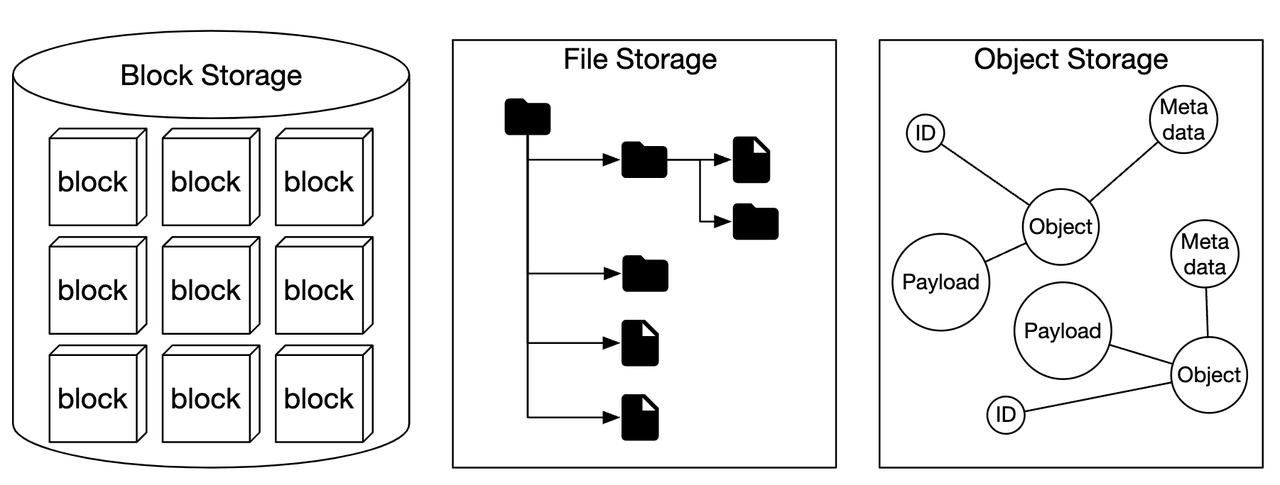
存储系统大致可分为三大类:
•
块存储
•
文件存储
•
对象存储
块存储是一种诞生于20世纪60年代的存储设备,硬盘驱动器(HDD)和固态硬盘(SSD)便是其典型代表。这类设备通常以物理方式连接到服务器,但也可通过高速网络协议实现网络附加。服务器可以对原始块进行格式化并将其用作文件系统,或者直接将块的管理权交由其他服务器接管。
文件存储构建于块存储之上。它提供了更高层次的抽象,使文件夹和文件的管理更加便捷。
对象存储以高持久性、超大规模和低成本为代价,牺牲了性能。它面向“冷”数据,主要用于归档与备份。对象存储不采用分层目录结构,所有数据均以对象的形式存储在扁平化的架构中。与其他存储类型相比,它的速度相对较慢。大多数云服务商都提供对象存储服务,例如 Amazon S3、Google GCS 等。
#VxrNsgrfWzNw text { white-space: pre; }#VxrNsgrfWzNw .fb0 { stroke: var(--N900-FG, 0.15); }#VxrNsgrfWzNw .fb0 {stroke: rgba(31,35,41, 0.15)}#VxrNsgrfWzNw .fx0 { stroke-miterlimit: 10; }#VxrNsgrfWzNw .fx0 {stroke-miterlimit: 10}#VxrNsgrfWzNw .fa1 { fill: rgb(187, 191, 196); }#VxrNsgrfWzNw .fa1 {fill: rgb(187, 191, 196)}#VxrNsgrfWzNw .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#VxrNsgrfWzNw .fx1 {font-style: normal}#VxrNsgrfWzNw .fx2 { text-anchor: middle; }#VxrNsgrfWzNw .fx2 {text-anchor: middle}#VxrNsgrfWzNw .fx3 { dominant-baseline: central; }#VxrNsgrfWzNw .fx3 {dominant-baseline: central}#VxrNsgrfWzNw .fx4 { stroke: none; }#VxrNsgrfWzNw .fx4 {stroke: none}#VxrNsgrfWzNw .fc0 { fill: var(--text-caption); }#VxrNsgrfWzNw .fc0 {fill: #646a73}#VxrNsgrfWzNw .fa2 { fill: var(--text-link-disabled); }#VxrNsgrfWzNw .fa2 {fill: rgb(187, 191, 196)}#VxrNsgrfWzNw .fa3 { fill: rgb(225, 234, 255); }#VxrNsgrfWzNw .fa3 {fill: rgb(225, 234, 255)}#VxrNsgrfWzNw .fx5 { font: 400 13px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#VxrNsgrfWzNw .fx5 {font-style: normal}#VxrNsgrfWzNw .fx6 { text-anchor: start; }#VxrNsgrfWzNw .fx6 {text-anchor: start}#VxrNsgrfWzNw .fx7 { dominant-baseline: alphabetic; }#VxrNsgrfWzNw .fx7 {dominant-baseline: alphabetic}#VxrNsgrfWzNw .fc1 { fill: rgb(0, 0, 0); }#VxrNsgrfWzNw .fc1 {fill: rgb(0, 0, 0)}#VxrNsgrfWzNw .fb1 { fill: var(--N900-FG, 0.15); }#VxrNsgrfWzNw .fb1 {fill: rgba(31,35,41, 0.15)}#VxrNsgrfWzNw .fb2 { fill: rgb(209, 217, 224); }#VxrNsgrfWzNw .fb2 {fill: rgb(209, 217, 224)}#VxrNsgrfWzNw .fa4 { fill: var(--bg-body); }#VxrNsgrfWzNw .fa4 {fill: #fff}ABCD12345678可变内容成本性能一致性数据访问可扩展性适用于块存储Y高中高,非常高强一致性SAS/iSCSI/FC中等可扩展性虚拟机(VM)、数据库文件存储Y中高中高强一致性标准文件访问,CIFS/SMB 和 NFS高可扩展性通用文件系统访问对象存储N(具有对象版本控制)低低至中强一致性 [5]RESTful API极高的可扩展性二进制数据、非结构化数据
与对象存储相关的一些术语:
•
存储桶——用于存放对象的逻辑容器。名称在全球范围内唯一。
•
对象——存储在存储桶中的单个数据单元,包含对象数据和元数据。
•
版本控制——一项功能,可在同一存储桶中保留对象的多个版本。
•
统一资源标识符(URI)——每个资源都由一个URI唯一标识。
•
服务等级协议(SLA)——服务提供商与客户之间的合同。
Amazon S3 标准-低频访问存储类的 SLA:
•
跨多个可用区的持久性高达99.999999999%
•
即使整个可用区被摧毁,数据依然具有高韧性
•
专为99.9%的可用性而设计
第一步:理解问题并明确设计范围
•
C:应该包含哪些功能?
•
一:存储桶创建、对象上传/下载、版本控制、列举存储桶中的对象
•
C:典型的数据规模是多少?
•
I:我们需要高效地存储海量对象和小型对象
•
C:我们一年存储多少数据?
•
我:100拍字节
•
C:我们可以假设数据持久性达到6个9(99.9999%),服务可用性达到4个9(99.99%)吗?
•
我:是的,听起来很合理
Non-functional requirements
•
100 PB 的数据量
•
99.9999%的数据持久性
•
99.99%的服务可用性
•
存储效率。在保持高可靠性和高性能的同时降低存储成本
Back-of-the-envelope estimation
对象存储很可能在磁盘容量或每秒输入/输出操作数(IOPS)方面存在瓶颈。
假设条件:
•
we have 20% small (less than 1mb), 60% mid-size (1-64mb) and 20% large objects (greater than 64mb),
•
One hard disk (SATA, 7200rpm) is capable of doing 100-150 random seeks per second (100-150 IOPS)
在给定假设条件下,我们可以估算系统能够持久化存储的总对象数量。
•
为简化计算,我们采用各类对象的中位大小:小型对象为0.5MB,中型对象为32MB,大型对象为200MB。
•
假设拥有100PB的存储空间(10^11 MB),且40%的存储空间被占用,对应约6.8亿个对象
•
若假设元数据大小为1KB,则需要0.68TB的存储空间来保存元数据信息
步骤2:提出高层次设计方案并获得认可
在深入设计之前,让我们先探讨一下对象存储的一些有趣特性:
•
对象不可变性——对象存储中的对象是不可变的(而在其他存储系统中并非如此)。我们只能删除或替换它们,但无法对其进行更新。
•
键值存储——对象的 URI 即为其键,我们可通过发起 HTTP 请求获取其内容
•
一次写入,多次读取——数据访问模式是一次写入、多次读取。据LinkedIn的一项研究显示,95%的操作都是读取操作
•
同时支持小型和大型对象
对象存储的设计理念与 UNIX 类似——当我们保存一个文件时,系统会在一种名为 inode 的数据结构中创建该文件的文件名,而文件数据则存储在磁盘上的不同位置。inode 中包含一个文件块指针列表,这些指针指向磁盘上的各个存储位置。
在访问文件时,我们首先从inode中获取其元数据,然后再读取文件内容。
对象存储的工作原理类似——元数据存储用于保存文件信息,而文件内容则存储在磁盘上:
通过将元数据与文件内容分离,我们可以对不同的存储分别进行独立扩展:
High-level design
•
负载均衡器——将 API 请求分发至各个服务副本
•
API服务- 无状态服务器,负责编排对元数据、对象存储以及IAM服务的调用。
•
身份与访问管理(IAM)- 身份认证、授权及访问控制的集中管理平台。
•
数据存储- 用于存储和检索实际数据。操作基于对象ID(UUID)。
•
元数据存储- 用于存储对象的元数据
Uploading an object
•
通过HTTP PUT请求创建一个名为“bucket-to-share”的存储桶
•
API 服务调用 IAM,以确保用户已获授权且具有写入权限
•
API 服务调用元数据存储,以创建一个存储桶条目。创建成功后,返回成功响应。
•
存储桶创建完成后,发送 HTTP PUT 请求,以创建名为 "script.txt" 的对象。
•
API服务验证用户身份,并确保用户具有写权限
•
验证通过后,对象载荷通过HTTP PUT请求发送至数据存储。数据存储将其持久化,并返回一个UUID。
•
API服务通过元数据存储创建一条新记录,包含object_id、bucket_id和bucket_name等元数据。
上传对象的示例请求:
Downloading an object
存储桶没有目录层次结构,但我们可以通过将存储桶名称与对象名称拼接起来,模拟出一种逻辑上的文件夹结构。
获取对象的示例 GET 请求:
代码块
Plain Text
GET /bucket-to-share/script.txt HTTP/1.1
Host: foo.s3example.org
Date: Sun, 12 Sept 2021 18:30:01 GMT
•
客户端向负载均衡器发送 HTTP GET 请求,即GET /bucket-to-share/script.txt
•
API服务查询IAM,以验证用户是否具有读取该存储桶的正确权限
•
验证通过后,从元数据存储中获取对象的UUID
•
根据UUID从数据存储中检索对象的有效载荷,并将其返回给客户端
// 第一阶段
步骤3:设计深度剖析
Data store
以下是 API 服务与数据存储的交互方式:
数据存储的主要组件:
数据路由服务提供 RESTful 或 gRPC API,用于访问数据节点集群。它是一个无状态服务,可通过增加更多服务器来实现水平扩展。
其主要职责是:
•
向放置服务查询以获取存储数据的最佳数据节点
•
从数据节点读取数据并将其返回给API服务
•
将数据写入数据节点
放置服务负责确定哪些数据节点应存储某个对象。它维护着一张虚拟集群映射,用于确定集群的物理拓扑结构。
该服务还会向所有数据节点发送心跳,以判断是否应将其从虚拟集群中移除。
由于这是一项关键服务,建议部署由5个或7个副本组成的集群,并通过Paxos或Raft一致性算法实现同步。例如,一个7节点的集群最多可容忍3个节点故障。
数据节点存储实际的对象数据。通过将数据复制到多个数据节点,确保数据的可靠性和持久性。
每个数据节点都运行着一个守护进程,该进程会向放置服务发送心跳。
心跳消息包含:
•
数据节点管理多少块磁盘驱动器(HDD 或 SSD)?
•
每块磁盘上存储了多少数据?
数据持久化流程
•
API服务将对象数据转发至数据存储
•
数据路由服务将数据发送至主数据节点
•
主数据节点在本地保存数据,并将其复制到两个备数据节点。只有在复制成功后,才会返回响应。
•
对象的UUID被返回给API服务。
注意事项:
•
给定一个对象的UUID,其复制组通过一致性哈希算法被确定性地选择
•
在第4步中,主数据节点会在返回响应之前先复制对象数据。这种方式更倾向于强一致性,而非更低的延迟。
数据的组织方式
一种简单的数据管理方法是将每个对象存储在单独的文件中。
这可行,但在文件系统中存在大量小文件时性能不佳:
•
硬盘上的数据块存在浪费,因为每个文件都会占用整个块的大小。典型的块大小为4KB。
•
文件数量过多意味着inode数量也会很多。操作系统对过多的inode处理能力有限,而且还存在inode的最大数量限制。
可以通过预先写日志(WAL)将许多小文件合并为大文件来解决这些问题。当文件达到其容量上限(通常为几GB)时,便会创建一个新的文件:
这种方法的缺点在于,对文件的写入操作需要进行串行化处理。多个核心同时访问同一文件时,必须相互等待。为了解决这一问题,我们可以将文件限定在特定的核心上,从而避免锁竞争。
对象查找
为了支持在同一文件中存储多个对象,我们需要维护一张表,该表用于告知数据节点:
•
object_id
•
filename对象存储在何处
•
file_offset对象开始的位置
•
object_size
我们可以将这张表部署在基于文件的数据库(如RocksDB)或传统的关系型数据库中。由于其访问模式是低写入、高读取,关系型数据库的表现更佳。
我们应该如何部署它?我们可以将数据库单独部署,并在集群中进行独立扩展,由所有数据节点访问。
缺点:
•
我们需要对集群进行大规模扩展,以应对所有请求
•
数据节点与数据库集群之间存在额外的网络延迟
另一种方案是利用这样一个事实:数据节点只关心与其相关的数据,因此我们可以将关系型数据库部署在数据节点内部。
SQLite是一个不错的选择,因为它是一种轻量级的基于文件的关系型数据库。
更新后的数据持久化流程
•
API服务发送请求以保存新对象
•
数据节点服务将新对象追加到名为“/data/c”的文件末尾
•
为该对象在对象映射表中插入一条新记录
持久性
数据持久性是我们设计中的重要要求。为了实现六九级的持久性,必须对每一种故障场景进行充分的分析与验证。
首先要解决的问题是硬件故障。我们可以通过数据节点的副本机制来降低故障发生的概率。此外,还应当在不同的故障域之间进行数据复制(如跨机架、跨数据中心、独立网络等)。一次关键事件可能导致同一域内发生多起硬件故障:
假设典型硬盘的年故障率为0.81%,那么制作三份副本即可实现6个9的可靠性。
以这种方式复制数据节点能够满足我们所需的持久性,但我们也可以利用纠删码来降低存储成本。
纠删码使我们能够使用校验位,从而在发生故障时恢复丢失的数据:
不妨设想这些位就是数据节点。如果其中两个节点失效,可以通过其余四个节点将其恢复。
擦除编码方案有多种。在我们的场景中,可以采用8+4的擦除编码,并将其分布于不同的故障域,以最大限度地提升可靠性:
纠删码使我们能够以更低的存储成本(提升50%)来换取性能,但代价是访问速度会受到影响,因为数据路由服务需要从多个位置收集数据:
其他注意事项:
•
复制需要200%的存储开销(以3副本为例),而通过纠删码只需50%
•
纠删码可提供11个9的持久性而复制仅能提供6个9的持久性
•
纠删码需要更多的计算来生成和存储校验数据
总而言之,复制技术更适用于对延迟敏感的应用场景,而纠删码则在存储成本效率和数据持久性方面更具优势。不过,纠删码的实现难度也远高于复制技术。
正确性验证
如果磁盘完全损坏,故障很容易被发现。然而,当磁盘的部分存储数据遭到破坏时,情况就不太容易判断了。
为了检测这一点,我们可以使用校验和——即文件内容的哈希值,可用于验证文件的完整性。
<b在我们的场景中,我们将为每个文件和每个对象存储校验和:
在使用纠删码(8+4)的情况下,我们需要分别获取这8份数据,并逐一验证它们的校验和。
// 第二冲刺
Metadata data model
表结构:
我们需要支持的查询:
•
按名称查找对象ID
•
根据名称插入/删除对象
•
列出存储桶中具有相同前缀的对象
通常,用户所能创建的桶数量是有限的,因此桶表的规模较小,完全可以容纳在单台数据库服务器中。不过,我们仍然需要对服务器进行扩容,以提升读取吞吐量。
不过,对象表很可能无法容纳于单台数据库服务器中。因此,我们可以通过分片来实现该表的水平扩展:
•
按bucket_id进行分片会导致热点问题,因为一个bucket可能包含数十亿个对象
•
按bucket_id进行分片可以使负载分布得更加均匀,但我们的查询会变慢
•
我们选择分片的方式是hash(bucket_name, object_name)因为大多数查询都是基于对象/存储桶名称的。
即便采用这种分片方案,对存储桶中的对象进行列举仍然会很慢。
Listing objects in a bucket
<b 在单个数据库中,按对象的前缀(看起来像目录)进行列举的操作如下:
代码块
Plain Text
SELECT * FROM object WHERE bucket_id = "123" AND object_name LIKE `abc/%`
当数据库采用分片架构时,这一目标难以实现。为达成此目的,我们可以在每个分片上执行查询,并在内存中对结果进行聚合。然而,这种方式会使分页变得复杂,因为不同分片返回的结果集大小不一,我们需要为每个分片单独维护 limit 和 offset 参数。
我们可以利用这样一个事实:通常对象存储并不针对对象列表操作进行优化,因此可以适当牺牲列表查询的性能。此外,我们还可以为对象列表创建一张经过反范式的表,并按存储桶 ID 进行分片。这样一来,由于查询被限定在单个数据库实例内,其响应速度将足够快。
Object versioning
这是一个 GitHub 仓库页面,标题为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”。上下文。
每个新版本都会生成一个新的object_id:
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。 object_id
Optimizing uploads of large files
通过使用分块上传,可以优化大文件的上传——将大文件拆分为多个数据块,分别独立上传:
•
客户端调用服务以启动分段上传
•
数据存储返回一个上传ID,用于唯一标识该上传任务
•
客户端将大文件拆分为多个分块,并通过该上传ID分别进行上传
•
当一个数据块被上传时,数据存储会返回一个 ETag,它是一个 MD5 校验和,用于标识该上传的数据块
•
所有分片上传完成后,客户端会发送一个完整的分段上传请求,其中包含 upload_id、分片编号以及所有 ETag
•
数据存储会将对象的各个部分重新组装起来。这一过程可能需要几分钟时间。随后,系统会向客户端返回成功响应。
此时可以移除那些已不再有用的旧部件。我们还可以引入垃圾回收机制来处理这些问题。
Garbage collection
垃圾回收是指回收不再使用的存储空间的过程。数据成为垃圾的方式有以下几种:
•
惰性对象删除- 对象被标记为已删除,但并未真正被清除
•
孤儿数据- 例如上传过程中断,需删除旧的分片
•
损坏数据- 数据校验和验证失败的数据
垃圾回收器还负责回收副本中未使用的空间。在使用复制机制时,数据会同时从主节点和副本中被删除;而在采用纠删码(8+4)的情况下,数据则会从全部12个节点中被删除。
为了便于删除,我们将采用一种称为压缩的机制:
•
垃圾回收器会将未被删除的对象从“data/b”复制到“data/d”
•
object_mapping表在复制完成后通过数据库事务更新一次
•
为避免生成过多的小文件,会对超过特定阈值的文件进行合并
步骤4:总结
我们讨论的内容:
•
设计一款类S3的对象存储
•
比较对象存储、块存储与文件存储之间的差异
•
涵盖对象在存储桶中的上传、下载、列举及版本控制
•
深入探讨设计细节——数据存储与元数据存储、复制与纠删码、分段上传、分片