第27章:设计虚拟数字钱包服务
简介
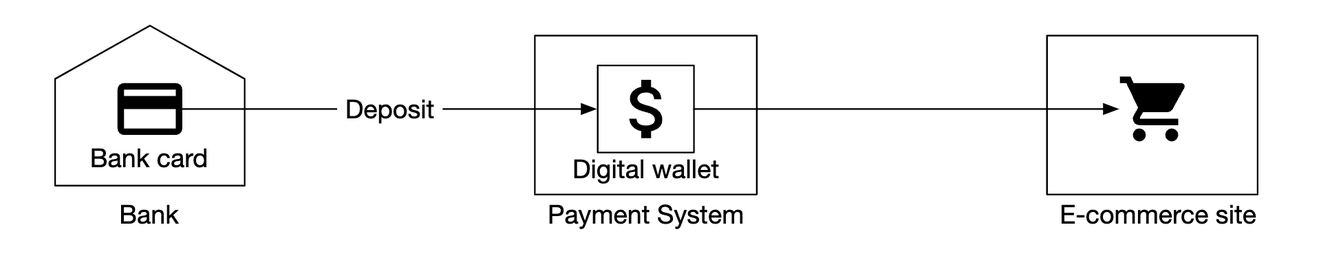
支付平台通常提供钱包服务,允许用户在应用内存储资金,日后可随时提现。
您还可以用它支付商品和服务费用,或将资金转账给使用数字钱包服务的其他用户。这种方式往往比通过传统支付渠道更快、更便宜。
第一步:理解问题并明确设计范围
•
C:我们是否只需关注数字钱包之间的转账?是否还需要支持其他操作?
•
I:目前我们先专注于数字钱包之间的转账。
•
C:系统需要支持每秒多少笔交易?
•
我:我们假设每秒100万笔交易
•
C:数字钱包对正确性要求极高。我们能否认为事务性保证已经足够?
•
我:听起来不错
•
C:我们需要证明正确性吗?
•
一:我们可以通过对账来实现这一点,但这种方式只能发现差异,而无法揭示其根本原因。相反,我们希望能够从头开始重放数据,以重建完整的历史记录。
•
C:我们可以假设可用性要求为99.99%吗?
•
I:需要
•
C:我们需要考虑外汇因素吗?
•
I:不,这超出了我们的范围
总结一下我们需要支持的内容如下:
•
支持两个账户之间的余额转账
•
支持100万TPS
•
可靠性达到99.99%
•
支持事务
•
支持可重复性
Back-of-the-envelope estimation
在云端部署的传统关系型数据库大约可以支持1000TPS。
为了达到100万TPS,我们需要1000个数据库节点。但如果每笔转账包含两个环节,那么我们实际上需要支持200万TPS。
我们的设计目标之一是提升单个节点的每秒事务处理量,从而减少数据库节点的数量。
#knOdbCpMXyDk text { white-space: pre; }#knOdbCpMXyDk .fb0 { stroke: var(--N900-FG, 0.15); }#knOdbCpMXyDk .fb0 {stroke: rgba(31,35,41, 0.15)}#knOdbCpMXyDk .fx0 { stroke-miterlimit: 10; }#knOdbCpMXyDk .fx0 {stroke-miterlimit: 10}#knOdbCpMXyDk .fa1 { fill: rgb(187, 191, 196); }#knOdbCpMXyDk .fa1 {fill: rgb(187, 191, 196)}#knOdbCpMXyDk .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#knOdbCpMXyDk .fx1 {font-style: normal}#knOdbCpMXyDk .fx2 { text-anchor: middle; }#knOdbCpMXyDk .fx2 {text-anchor: middle}#knOdbCpMXyDk .fx3 { dominant-baseline: central; }#knOdbCpMXyDk .fx3 {dominant-baseline: central}#knOdbCpMXyDk .fx4 { stroke: none; }#knOdbCpMXyDk .fx4 {stroke: none}#knOdbCpMXyDk .fc0 { fill: var(--text-caption); }#knOdbCpMXyDk .fc0 {fill: #646a73}#knOdbCpMXyDk .fa2 { fill: var(--text-link-disabled); }#knOdbCpMXyDk .fa2 {fill: rgb(187, 191, 196)}#knOdbCpMXyDk .fx5 { font: 400 13px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#knOdbCpMXyDk .fx5 {font-style: normal}#knOdbCpMXyDk .fx6 { text-anchor: start; }#knOdbCpMXyDk .fx6 {text-anchor: start}#knOdbCpMXyDk .fx7 { dominant-baseline: alphabetic; }#knOdbCpMXyDk .fx7 {dominant-baseline: alphabetic}#knOdbCpMXyDk .fc1 { fill: rgb(0, 0, 0); }#knOdbCpMXyDk .fc1 {fill: rgb(0, 0, 0)}#knOdbCpMXyDk .fb1 { fill: var(--N900-FG, 0.15); }#knOdbCpMXyDk .fb1 {fill: rgba(31,35,41, 0.15)}#knOdbCpMXyDk .fb2 { fill: rgb(209, 217, 224); }#knOdbCpMXyDk .fb2 {fill: rgb(209, 217, 224)}#knOdbCpMXyDk .fa3 { fill: var(--bg-body); }#knOdbCpMXyDk .fa3 {fill: #fff}AB1234每节点TPS1001,00010,000节点数量20,0002,000200
步骤2:提出高层次设计方案并获得认可
API Design
<b在本次面试中,我们只需支持一个接口:
代码块
Plain Text
POST /v1/wallet/balance_transfer - transfers balance from one wallet to another
请求参数——from_account、to_account、amount(字符串类型,以确保精度)、currency、transaction_id(幂等性键)。
示例回复:
代码块
Plain Text
{
"status": "success"
"transaction_id": "01589980-2664-11ec-9621-0242ac130002"
}
In-memory sharding solution
我们的钱包应用程序为每个用户账户维护账户余额。
一种不错的数据结构来表示这一点是map<user_id, balance>, 可以通过内存中的 Redis 存储来实现。
由于单个 Redis 节点无法承受 100 万 TPS 的负载,我们需要将 Redis 集群划分为多个节点。
示例分区算法:
代码块
Plain Text
String accountID = "A";
Int partitionNumber = 7;
Int myPartition = accountID.hashCode() % partitionNumber;
Zookeeper 可以用来存储分区数量以及 Redis 节点的地址,因为它是一种高可用的配置存储。
最后,钱包服务是一种无状态服务,负责执行转账操作。它能够轻松实现水平扩展:
尽管该方案解决了可扩展性问题,但它无法实现余额转账的原子性。
Distributed transactions
处理事务的一种方法是在标准的分片关系型数据库之上使用两阶段提交协议:
两阶段提交(2PC)协议的工作原理如下:
•
协调者(钱包服务)照常对多个数据库执行读写操作
•
当应用程序准备提交事务时,协调者会要求所有数据库进行预处理
•
如果所有数据库都回复“是”,则协调者要求各数据库提交事务。
•
否则,要求所有数据库回滚事务
2PC 方案的缺点:
•
由于锁竞争而性能不佳
•
协调者是单点故障
Distributed transaction using Try-Confirm/Cancel (TC/C)
TC/C是2PC协议的一种变体,它通过补偿事务来实现:
•
协调者要求所有数据库为该事务预留资源
•
协调者从各数据库收集回复——若为“是”,则要求各数据库执行尝试确认;若为“否”,则要求各数据库执行尝试取消。
TC/C与2PC的一个重要区别在于:2PC执行的是单个事务,而在TC/C中则存在两个独立的事务。
事务/并发控制的分阶段工作原理如下:
第一阶段——尝试:
•
协调者在A的数据库中启动本地事务,将A的余额减少1美元
•
C的数据库收到一条NOP指令,该指令不执行任何操作
阶段2a - 确认:
•
如果两个数据库都回复“是”,则进入确认阶段。
•
A的数据库收到NOP,而C的数据库被指示将C的余额增加1美元(本地事务)
阶段2b——取消:
•
如果第一阶段中的任何操作失败,则启动取消阶段。
•
A的数据库被指示将A的余额增加1美元,C的数据库收到NOP
以下是2PC与TC/C的对比:
TC/C 也被称为基于补偿的分布式事务。高层次的操作由业务逻辑来处理。
事务/并发控制的其他特性:
•
与数据库无关,只要数据库支持事务
•
分布式事务的细节与复杂性需由业务逻辑自行处理
TC/C Failure modes
如果协调器在执行过程中发生故障,它需要恢复其中间状态。这可以通过维护阶段状态表来实现,这些状态表在数据库分片内以原子方式更新:
该表包含哪些内容:
•
分布式事务的ID与内容
•
尝试阶段的状态——未发送、已发送、已收到响应
•
第二阶段名称——确认或取消
•
第二阶段的状态
•
乱序标志(稍后说明)
在使用 TC/C 时需注意一点:当分布式事务处于进行中时,各账户的状态之间会存在一段短暂的不一致:
只要我们始终能够从这种状态中恢复,并且用户无法利用中间状态进行消费等操作,那么这样做就是可行的。这一点可以通过始终先执行扣款再执行加法来确保。
请注意,上表中的选项3是无效的,因为在不依赖2PC的情况下,我们无法保证跨不同数据库的事务具有原子性。
需要解决的一个边缘情况是乱序执行:
有可能在收到尝试操作之前,数据库就已经收到了取消操作。这种边缘情况可以通过在我们的阶段状态表中添加一个“乱序”标志来处理。当收到尝试操作时,我们首先检查该“乱序”标志是否已置位;如果已置位,则直接返回失败。
Distributed transaction using Saga
另一种流行的做法是使用Saga——一种用于在微服务架构中实现分布式事务的标准。
其工作原理如下:
•
所有操作都按顺序排列。每个操作在其各自的数据库中都是独立的。
•
操作按从前往后顺序执行
•
当某项操作失败时,整个流程将通过补偿操作回滚至初始状态
我们如何协调工作流?我们可以采取两种方法:
•
编排——参与Saga的所有服务订阅相关事件,并在Saga中各司其职
•
协调——由单一的协调器按正确顺序指挥所有服务完成各自的任务
使用编排模式的挑战在于,业务逻辑被拆分到多个服务中,而这些服务之间以异步方式通信。相比之下,编排模式能够很好地应对复杂性,因此在数字钱包系统中通常更受青睐。
以下是TC/C与Saga的对比:
主要区别在于,TC/C具有可并行性,因此我们的决策取决于延迟需求——如果需要实现低延迟,就应该采用TC/C方案。
无论我们采取何种方案,都仍需支持审计与历史回放功能,以便从故障状态中恢复。
Event sourcing
在实际应用中,数字钱包应用程序可能会接受审计,而我们必须对某些问题作出解答:
•
我们是否能够在任意时刻获知账户余额?
•
我们如何确保历史与当前的余额数据均准确无误?
•
在代码变更后,我们如何证明系统逻辑的正确性?
事件溯源是一种有助于我们解答这些问题的技术。
它由四个概念组成:
•
命令——来自现实世界的预期操作,例如将1美元从账户A转账至账户B。由于需要确保全局顺序,这些命令会被放入一个先进先出的队列中。
◦
与事件不同,命令可能会失败,并且由于例如I/O或无效状态等原因而具有一定的随机性。
◦
命令可以产生零个或多个事件
◦
事件的生成可能包含随机性,例如外部I/O。这一点将在稍后重新讨论
•
事件——关于系统中发生过的事件的历史记录,例如“从A向B转账1美元”。
◦
与命令不同,事件是发生在我们系统中的事实
◦
与命令类似,它们也需要按顺序执行,因此被放入FIFO队列中
•
状态——指因某一事件而发生的变化。例如,账户与其余额之间的键值存储。
•
状态机——驱动事件溯源过程。它主要负责验证命令,并应用事件以更新系统状态。
◦
状态机应当是确定性的,因此不应读取外部输入或依赖随机性。
以下是事件溯源的动态视图:
对于我们的钱包服务,命令就是余额转账请求。我们可以将它们放入一个FIFO队列中,例如Kafka:
完整图景如下:
•
状态机从命令队列中读取命令
•
平衡状态从数据库中读取
•
命令已通过验证。若有效,则为每个账户生成两条事件记录
•
下一个事件通过更新数据库中的余额(状态)来读取并应用
使用事件溯源的主要优势在于其可复现性。在这种设计中,所有状态更新操作都被记录为不可变的余额变更历史。
历史余额始终可以通过从头重放事件来重建。由于事件列表是不可变的,且状态机具有确定性,因此我们能够确保成功重放任意中间状态。
本节开头提出的所有与审计相关的问题,均可通过事件溯源来解决:
•
我们能否在任意时刻获知账户余额?——事件可从初始状态重放至我们关注的某一时间点
•
我们如何确保历史余额和当前余额的正确性?——可通过从头重新计算所有事件来验证其正确性
•
代码变更后,我们如何证明系统逻辑的正确性?——我们可以针对同一组事件分别运行不同版本的代码,并验证其输出结果是否一致
对于客户端查询其余额的请求,可以采用 CQRS 架构来解决——可以存在多个只读状态机,它们根据不可变的事件列表负责查询历史状态:
步骤3:设计深度剖析
在本节中,我们将探讨一些性能优化措施,因为我们仍需将系统扩展至每秒100万笔交易。
High-performance event sourcing
我们首先要探讨的优化方案是:将命令和事件存储到本地磁盘,而非像 Kafka 这样的外部存储。
这样可以避免网络延迟,而且由于我们只执行追加操作,对于机械硬盘而言,该操作通常也十分快速。
下一项优化是在内存中缓存近期的命令和事件,以节省从磁盘重新加载它们所需的时间。
在底层,我们可以通过使用名为 mmap 的命令来实现上述优化,该命令将数据存储在本地磁盘上,并同时将其缓存在内存中:
我们接下来可以做的优化,也是将状态存储在本地文件系统中,使用 SQLite——一种基于文件的本地关系型数据库。RocksDB 也是一个不错的选择。
出于我们的需求,我们将选择 RocksDB,因为它采用日志结构化合并树(LSM),这种数据结构针对写操作进行了优化。同时,通过缓存机制进一步提升了读性能。
为了优化可复现性,我们可以定期将快照保存到磁盘,这样就无需每次都从头开始重现某个特定状态。我们可以将快照以大型二进制文件的形式存储在分布式文件系统中,例如 HDFS:
Reliable high-performance event sourcing
到目前为止所做的所有优化都很出色,但它们使我们的服务具有状态。出于可靠性考虑,我们需要引入某种形式的复制机制。
在我们开始之前,应当先分析一下我们的系统中哪些数据需要高可靠性:
•
状态和快照都可以通过从事件列表重新生成,因此我们只需确保事件列表的可靠性。
•
人们可能会认为我们可以随时根据命令列表重新生成事件列表,但事实并非如此,因为命令是不可确定的。
•
结论是,我们只需确保事件列表具有高可靠性
为了实现事件的高可靠性,我们需要在多个节点之间复制该列表。我们必须确保:
•
不会发生数据丢失
•
日志文件中数据的相对顺序在各个副本之间保持不变
为此,我们可以采用一种一致性算法,例如 Raft。
在 Raft 协议中,系统有一个活跃的领导者和若干被动的追随者。如果领导者失效,其中一个追随者将接任新的领导者。只要超过半数的节点处于运行状态,整个系统就能持续正常运行。
采用这种方法,所有节点都会根据事件列表更新状态。Raft协议确保主节点与从节点拥有相同的事件列表。
Distributed event sourcing
到目前为止,我们已经成功设计出一个具备高单节点性能且可靠性的系统。
我们必须应对的一些局限性:
•
单个Raft组的容量是有限的。在某个时刻,我们需要对数据进行分片,并实现分布式事务
•
在 CQRS 架构中,请求/响应的处理流程较为缓慢。客户端需要定期轮询系统,以获知其钱包何时已更新
轮询并非实时,因此用户可能需要较长时间才能获悉其账户余额的更新。此外,如果轮询频率过高,还可能导致查询服务负载过重:
为减轻系统负载,我们可以引入反向代理,由其代表用户发送命令并为其轮询响应:
这在一定程度上缓解了系统负载,因为我们可以通过一次请求为多个用户获取数据,但仍然无法满足实时到账的需求。
我们还可以做的一项最终优化是:在只读状态机可用时,立即将响应推回反向代理。这样可以让用户感受到更新是实时发生的:
最后,为了进一步扩展系统规模,我们可以将系统拆分为多个 Raft 组,并在这些组之上通过编排器(采用 TC/C 或 Saga 方案)实现分布式事务:
以下是我们在最终系统中一笔余额转账请求的典型生命周期示例:
•
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
•
Saga协调器在阶段状态表中创建一条记录,用于跟踪事务的状态
•
协调器确定需要向哪些分区发送命令。
•
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。
•
事件结果被同步到读状态机,该状态机将响应推回协调器
•
协调器创建一条记录,表明操作已成功,并继续执行下一项操作 -C+1
•
下一次操作的执行方式与第一次类似——确定分区、发送命令、执行命令,然后由状态机读取并返回响应
•
协调者创建一条记录,表明操作2也已成功,最后将结果通知客户端
步骤4:总结
以下是我们的设计演进过程:
•
我们最初采用的是基于内存Redis的解决方案。这种方法的问题在于其存储并不持久。
•
我们开始使用关系型数据库,并在其之上通过2PC、TC/C或分布式Saga来执行分布式事务。
•
接下来,我们引入了事件溯源机制,以确保所有操作均可审计
•
我们最初是将数据存储在外部存储中,使用了外部数据库和队列,但这种方式性能并不理想
•
我们随后将数据存储在本地文件系统中,充分利用了追加写操作的高性能。同时,我们还通过缓存来优化读取路径
•
之前的方案虽然性能优异,但不够持久。因此,我们引入了基于复制的Raft一致性算法,以避免单点故障
•
我们还采用了 CQRS 架构,并借助反向代理来代表用户管理事务的生命周期
•
最后,我们将数据划分到多个 Raft 组中,并通过分布式事务机制——TC/C 或分布式 Saga——对这些组进行协调