第1章:从零到数百万用户的规模扩展
简介
将系统扩展至支持数百万用户是一项复杂而迭代的过程,需要不断优化与改进。本章将介绍如何从单服务器架构起步,逐步扩展系统架构,以从容应对数百万用户的访问需求。
第1节:单服务器部署
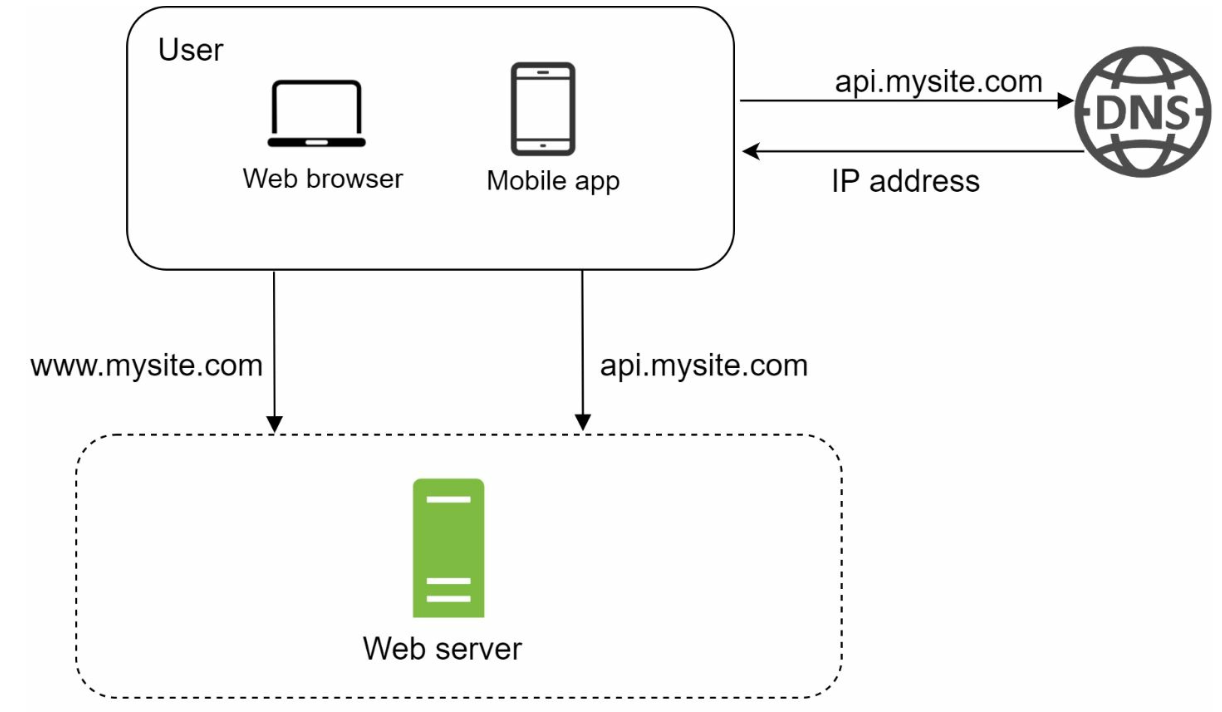
最初,所有组件(Web 应用、数据库、缓存)都运行在一台服务器上。
Request Flow
用户通过域名(例如,api.mysite.com)访问应用程序,这些域名通过DNS解析为IP地址。
Web服务器的IP地址被返回给浏览器或移动应用。
HTTP请求被发送到Web服务器,后者返回HTML或JSON响应。
Traffic Sources
Web 应用程序:使用服务器端语言(如 Python、Java)实现业务逻辑,使用客户端语言(如 JavaScript、HTML)负责页面展示。
移动应用:通过 HTTP 和 JSON 与 Web 服务器通信,实现轻量级的数据交换。
第2节:数据库分离
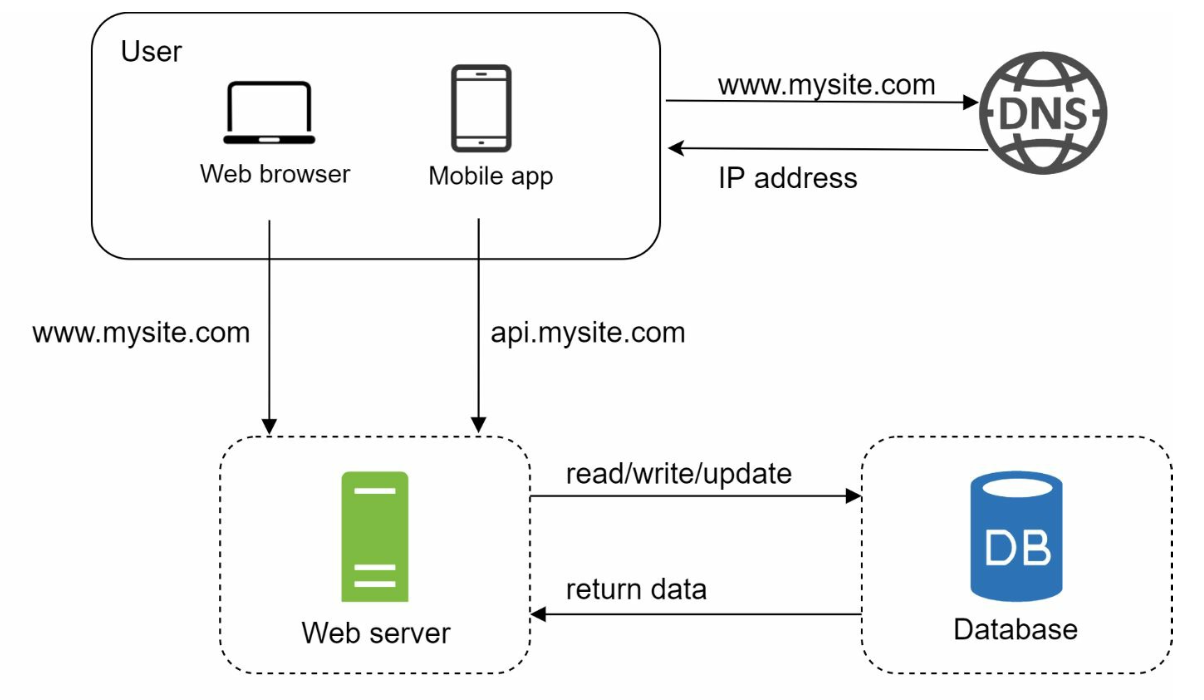
随着用户规模的扩大,数据库被迁移到专用服务器上,以便实现Web层与数据库层的独立扩展。
Database Choices
关系型数据库(SQL):以表格形式存储结构化数据。示例:MySQL、PostgreSQL。
非关系型数据库(NoSQL):适用于非结构化数据或低延迟需求。其分类包括:
◦
键值存储
◦
图数据库
◦
列式存储
•
如果满足以下条件,非关系型数据库可能是合适的选择:
◦
应用程序需要极低的延迟。
◦
数据是非结构化的,或者不存在关系型数据。
◦
只需对数据进行序列化与反序列化(如 JSON、XML、YAML 等)。
◦
需要存储海量数据。
第3节:纵向扩展与横向扩展
Vertical Scaling
•
为现有服务器增加更多资源(CPU、内存)。
•
受限于硬件条件,且缺乏冗余机制。
Horizontal Scaling
•
向集群中添加更多服务器,使其更适用于大规模系统。
•
负载均衡器用于在服务器之间处理请求路由。
第4节:负载均衡器
A负载均衡器在多台服务器之间分发流量。其优势包括:
冗余性:当某台服务器宕机时,流量将被重新路由。
◦
如果服务器1宕机,所有流量都将被路由到服务器2。
可扩展性:可轻松添加服务器以应对流量高峰。
◦
如果网站流量迅速增长,可以随时增加服务器来承载额外的流量。
第5节:数据库复制
Master-Slave Model
•
主数据库:负责处理写操作。
◦
<b 所有修改数据的命令,如插入、删除或更新,都必须发送到主数据库。
•
从库:承担读操作,提升性能与可靠性。
◦
由于在大多数应用中,读操作的频率远高于写操作,因此一个系统中的从库数量通常多于主库数量。
Benefits
通过并行读取操作提升性能。
通过冗余实现高可用性和数据可靠性。
Failure Handling
•
如果仅有一台从库且该从库发生宕机,读请求将暂时被转发至主库。
•
如果存在多个从库,读操作将被重定向至其他健康的从库,同时由新服务器替换旧服务器。
•
如果主数据库宕机,将把一台从属数据库提升为新的主数据库。
•
在生产环境中,所选的从库可能并非最新状态,因此需要通过运行数据恢复脚本来更新数据(诸如多主架构和环形复制等方案则可提供帮助)。
第6节:缓存
A缓存将频繁访问的数据存储在内存中,以减轻数据库的负载。缓存层是一个临时的数据存储层,其速度远高于数据库。
Caching considerations
用例:当数据读取频繁但修改较少时,可考虑使用缓存。
过期策略:一旦缓存数据过期,就会从缓存中移除。如果没有设置过期策略,缓存数据将永久保留在内存中。
一致性:这意味着要确保数据存储与缓存保持同步。由于对数据存储和缓存的数据修改操作并未置于同一事务中,因此可能会出现不一致的情况。
故障缓解:单台缓存服务器可能成为潜在的单点故障,建议在不同数据中心部署多台缓存服务器,以避免单点故障。
逐出策略:当缓存满时,需要逐出部分项以释放内存。LRU 是最常用的缓存逐出策略。
第7节:内容分发网络(CDN)
ACDN通过将静态内容(图片、CSS、JavaScript)缓存在地理分布的服务器上,从而缩短了加载时间。
Workflow
用户从最近的CDN服务器请求内容。
若不可用,则从源站获取内容并进行缓存。
CDN considerations
成本:CDN由第三方服务商运营,会对进出CDN的数据传输收取费用。
缓存过期:缓存过期时间既不能太长,也不能太短。
CDN回源:如果CDN出现临时故障,客户端应能及时发现并从源站请求资源。
文件失效:如果文件被更新,缓存应被标记为失效,以指向更新后的文件。
第8节:无状态Web层
通过将会话数据移至共享存储,Web服务器便成为无状态的。这使得:
更轻松的水平扩展。
基于流量的自动伸缩。
第9节:多数据中心架构
在多个数据中心部署可提高可用性并降低延迟。相关策略包括:
地理DNS路由:将用户直接引导至最近的数据中心。
数据复制:在各数据中心之间同步数据,以防止数据不一致。
Key considerations
•
流量重定向:需要有效的工具将流量引导至正确的数据中心。
•
数据同步:一种常见的策略是在多个数据中心之间复制数据。
•
测试与部署:自动化部署工具对于确保各数据中心的服务一致性至关重要。
第10节:消息队列
消息队列是一种持久化的组件,存储于内存中,支持异步通信。它充当缓冲区,用于分发异步请求。
•
输入服务,也称为生产者/发布者,负责创建消息并将其发布到消息队列中。
•
其他服务称为消费者/订阅者,它们连接到该队列,并根据消息中定义的逻辑执行相应操作。
第11节:日志、指标与自动化
Importance
日志记录:用于跟踪错误和系统健康状况。
指标监控:提供关于性能和用户活动的洞察。
自动化:简化测试、部署与扩展流程。
第12节:数据库扩展
Vertical Scaling
•
增加硬件资源,但存在物理与成本上的限制。
•
存在诸多弊端:
◦
单点故障风险更高。
Horizontal Scaling (Sharding)
•
使用键值将数据分散到多个分片中(例如,user_id).
◦
分片技术将大型数据库拆分为更小、更易于管理的组成部分,称为分片。
◦
每个分片共享相同的模式,但每个分片中的实际数据仅属于该分片。
•
在实施分片策略时,分片键至关重要。选择分片键时,务必确保所选键能够实现数据的均匀分布。
挑战
重新分片数据:当出现以下情况时,需要进行重新分片:
◦
由于数据快速增长,单个分片已无法容纳更多数据。
名人问题:对某个特定分片的访问量过大可能导致服务器过载。
◦
为了解决这个问题,我们可能需要为每位名人分配一个独立的分片。
连接与反规范化:一旦数据库被分片并分布到多台服务器上,跨数据库分片执行连接操作便变得十分困难。
◦
一种常见的解决方法是通过反规范化数据库,使查询能够在单个表中完成。
结论
Key Takeaways
保持 Web 层无状态。
在每一层都构建冗余。
使用缓存和CDN优化性能。
通过分片技术扩展数据层。
解耦各组件以提升灵活性。
本章为构建能够承载数百万用户的可扩展系统奠定了坚实的基础。