第23章:分布式电子邮件服务
简介
在本章中,我们将设计一个分布式电子邮件服务,类似于Gmail。
2020年,Gmail拥有18亿活跃用户,而Outlook在全球范围内有4亿用户。
第一步:理解问题并明确设计范围
•
C:有多少用户在使用该系统?
•
I:10亿用户
•
C:我认为以下功能非常重要——身份认证、收发邮件、获取邮件、邮件筛选、邮件搜索以及反垃圾邮件保护。
•
一:不错的列表。目前先不考虑身份验证问题。
•
C:用户如何连接电子邮件服务器?
•
一:通常,电子邮件客户端通过SMTP、POP、IMAP等方式连接,但本题我们采用HTTP协议。
•
C:电子邮件可以附加文件吗?
•
I:需要
Non-functional requirements
•
可靠性——我们不应丢失数据
•
可用性- 我们应通过数据复制来避免单点故障,并且能够容忍部分系统故障。
•
可扩展性- 随着用户规模的扩大,我们的系统应当能够从容应对。
•
灵活性与可扩展性——系统应当灵活,并易于通过新增功能进行扩展。这也是我们选择 HTTP 而非 SMTP 或其他邮件协议的原因之一。
Back-of-the-envelope estimation
•
10亿用户
•
假设每人每天发送10封邮件 ->每秒发送10万封邮件.
•
假设每人每天收到40封邮件,每封邮件平均包含50KB的元数据 ->每年需730PB的存储空间.
•
假设20%的邮件包含存储附件,且平均大小为500KB,则每年将达到1,460PB.
步骤2:提出高层次设计方案并获得认可
Email knowledge 101
用于收发电子邮件的协议多种多样:
•
SMTP——一种用于在不同服务器之间发送电子邮件的标准协议。
•
POP——一种用于从远程邮件服务器向本地客户端接收并下载电子邮件的标准协议。邮件被下载后,会从远程服务器上删除。
•
IMAP——与POP类似,用于从远程服务器接收并下载电子邮件,但会将邮件保留在服务器端。
•
HTTPS——严格来说并非电子邮件协议,但可用于基于Web的电子邮件客户端。
除了邮件传输协议之外,我们还需要为电子邮件服务器配置一些DNS记录——即MX记录:
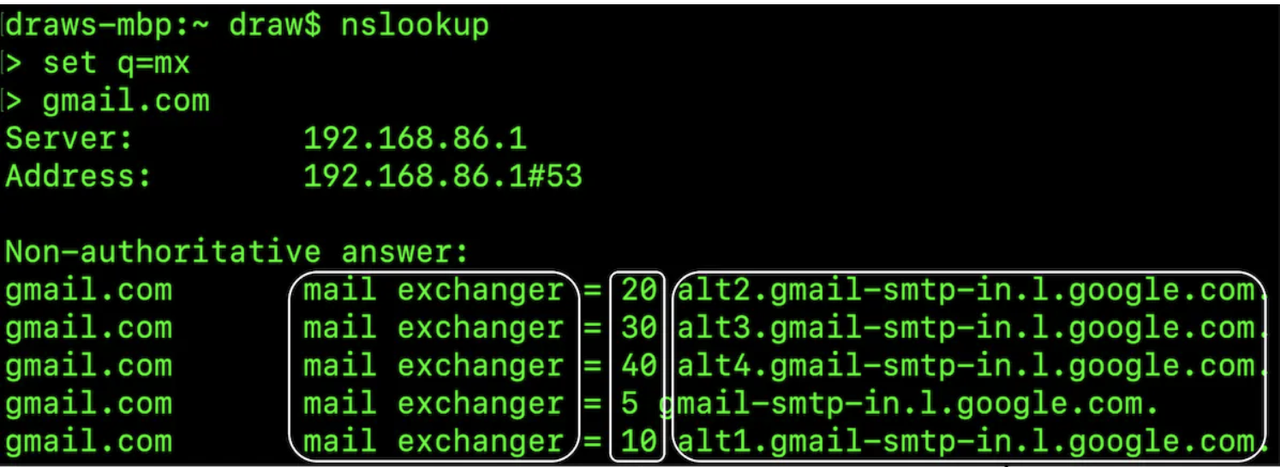
电子邮件附件以 Base64 编码方式发送,且大多数邮件服务通常设有 25MB 的大小限制。该限制可配置,且因个人账户与企业账户而异。
Traditional mail servers
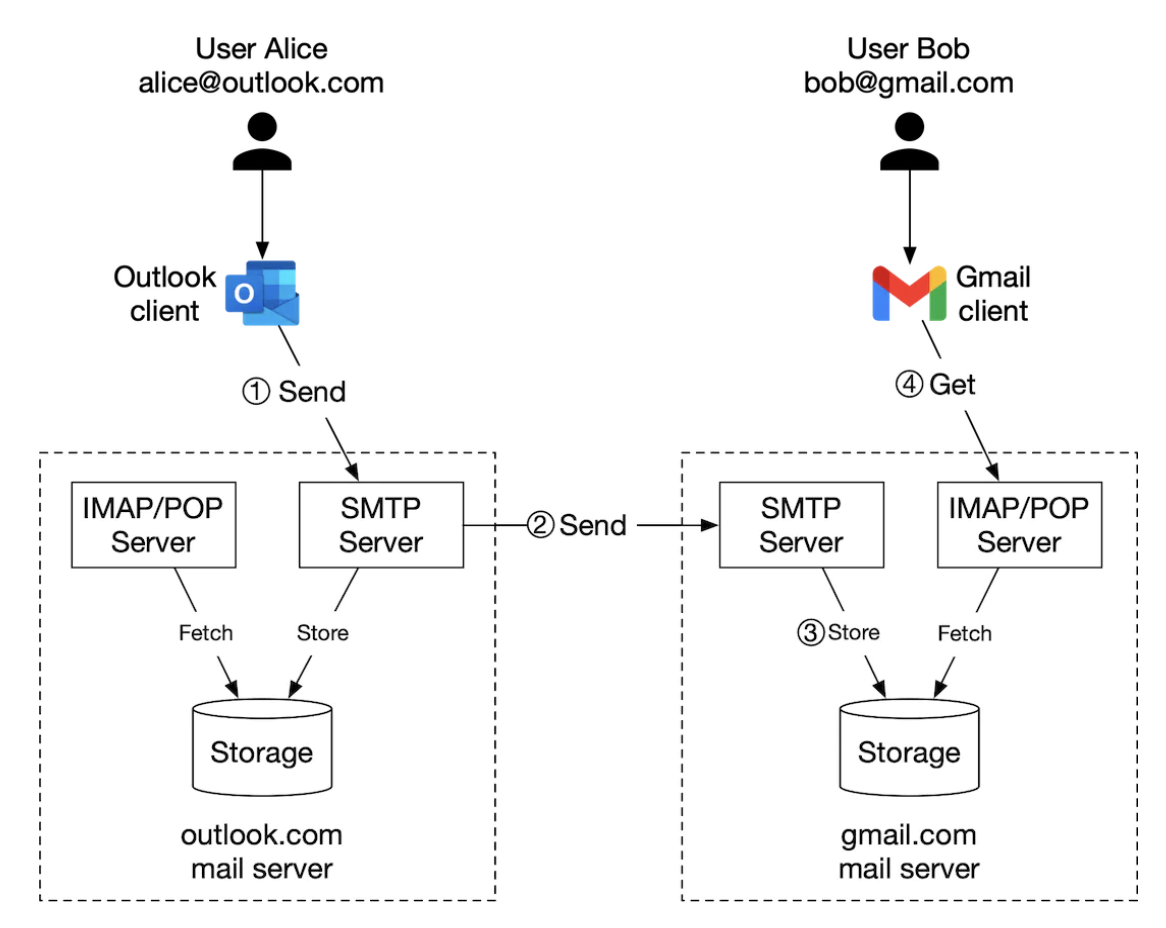
在用户数量有限且仅连接到单台服务器的情况下,传统邮件服务器运行良好。
•
爱丽丝登录她的Outlook邮箱并点击“发送”。邮件随即被发送到Outlook邮件服务器,通信协议为SMTP。
•
Outlook 服务器会查询 DNS,以获取 gmail.com 的 MX 记录,并将邮件转发至其服务器。通信采用 SMTP 协议。
•
Bob通过IMAP/POP协议从他的Gmail服务器获取邮件。
在传统的邮件服务器中,电子邮件被存储在本地文件系统上,每封邮件都对应一个独立的文件。
随着规模的扩大,磁盘I/O逐渐成为瓶颈。此外,它也无法满足我们对高可用性和可靠性的要求。磁盘可能损坏,服务器也可能宕机。
Distributed mail servers
分布式邮件服务器旨在支持现代应用场景,并解决当今的可扩展性问题。
这些服务器依然能够为原生邮件客户端提供IMAP/POP服务,并通过SMTP实现跨服务器的邮件交换。
但对于功能丰富的基于Web的邮件客户端,通常会使用基于HTTP的RESTful API。
示例API:
•
POST /v1/messages- 向收件人发送消息,收件人信息分别位于To、Cc、Bcc字段中。
•
GET /v1/folders- 返回某个电子邮件账户的所有文件夹
示例响应:
代码块
Plain Text
[{id: string Unique folder identifier.
name: string Name of the folder.
According to RFC6154 [9], the default folders can be one of
the following: All, Archive, Drafts, Flagged, Junk, Sent,
and Trash.
user_id: string Reference to the account owner
}]
•
GET /v1/folders/{:folder_id}/messages- 返回某个文件夹下的所有消息 \w 分页
•
GET /v1/messages/{:message_id}- 获取某条消息的所有信息
示例响应:
代码块
Plain Text
{
user_id: string // Reference to the account owner.
from: {name: string, email: string} // <name, email> pair of the sender.
to: [{name: string, email: string}] // A list of <name, email> paris
subject: string // Subject of an email
body: string // Message body
is_read: boolean // Indicate if a message is read or not.
}
以下是分布式邮件服务器的概要设计:
•
Web邮箱- 用户通过网页浏览器收发电子邮件
•
Web服务器- 面向公众的请求/响应服务,用于管理登录、注册、用户个人资料等功能
•
实时服务器——用于向客户端实时推送新邮件通知。我们采用 WebSocket 实现实时通信,但对于不支持 WebSocket 的旧版浏览器,则回退为长轮询。
•
元数据数据库- 存储邮件的元数据,如主题、正文、发件人、收件人等。
•
附件存储- 对象存储(如 Amazon S3),适用于存储大文件。
•
分布式缓存- 我们可以将近期的邮件缓存在 Redis 中,以提升用户体验。
•
搜索商店- 分布式文档存储,用于支持全文搜索。
邮件发送流程如下:
•
用户撰写邮件并点击“发送”。邮件被发送至负载均衡器。
•
负载均衡器对过量的邮件发送进行限流,并将请求路由至其中一台Web服务器。
•
Web服务器会执行基本的邮件校验(如邮件大小),并在发件域名与收件域名相同时直接中止出站流程。但首先仍会进行垃圾邮件检测。
•
如果基本验证通过,邮件将被发送至消息队列(附件则从对象存储中引用)
•
如果基本验证失败,邮件将被发送至错误队列
•
SMTP外发工作进程从外发队列中拉取消息,执行垃圾邮件与病毒检测,并将其路由至目标邮件服务器。
•
邮件存储在“已发送邮件”文件夹中
我们还需要监控出站消息队列的大小。如果队列过大,可能表明存在某种问题:
•
收件人的邮件服务器不可用。我们可以采用指数退避策略,在稍后重试发送邮件。
•
消费者数量不足,无法应对当前负载,我们可能需要扩展消费者规模。
以下是邮件接收流程:
•
incoming emails arrive at the SMTP load balancer. Mails are distributed to SMTP servers, where mail acceptance policy is done (eg invalid emails are directly discarded).
•
如果邮件附件过大,我们可以将其存储在对象存储(S3)中。
•
邮件处理工作进程会进行初步检查,随后将邮件转发至存储、缓存、对象存储以及实时服务器。
•
离线用户在重新上线后,可通过 HTTP API 获取其新邮件。
步骤3:设计深度剖析
接下来,我们深入探讨其中的几个组件。
Metadata database
以下是电子邮件元数据的一些特点:
•
邮件头通常较小且访问频繁
•
邮件正文大小从短到长不等,但通常只被读取一次
•
大多数邮件操作都局限于单个用户——例如获取邮件、标记为已读、搜索。
•
数据的时效性会影响数据使用。用户通常只阅读近期的邮件
•
数据具有极高的可靠性要求,任何数据丢失都不可接受。
在Gmail或Outlook这样的规模下,数据库通常会进行定制开发,以降低每秒输入/输出操作次数(IOPS)。
让我们来考虑一下有哪些数据库选项:
•
关系型数据库——我们可以为表头和正文建立索引,但这类数据库通常针对小规模数据块进行了优化。
•
分布式对象存储——这可能是备份存储的一个不错选择,但无法高效支持搜索、标记已读等功能。
•
NoSQL——Google BigTable 被 Gmail 使用,但并未开源。
基于上述分析,现有解决方案中似乎很少有能够完全满足我们需求的。在面试场景下,设计一套全新的分布式数据库方案并不现实,但有必要提及一些关键特性:
•
单列大小可达个位数MB
•
强数据一致性
•
旨在减少磁盘I/O
•
高可用且容错
•
应能轻松实现增量备份
这是一个名为“system-design-notes/01. Scaling at main · liquidslr/system-design-notes”的GitHub仓库页面。上下文。 user_id
让我们定义这些表:
•
主键由分区键(用于数据分布)和聚簇键(用于数据排序)组成
•
我们需要支持的查询——获取某用户的全部文件夹、显示某个文件夹中的所有邮件、创建/获取/删除邮件、获取已读/未读状态、获取对话线程(附加功能)
以下为表格的图例:
以下是文件夹表:
邮件表:
•
email_id 是一个 timeuuid,可用于按邮件创建时间戳进行排序
附件存储在一张单独的表中,通过文件名进行标识:
在传统的关系型数据库中,支持获取已读/未读邮件非常容易,但在Cassandra中却无法实现,因为不允许对非分区键或非聚簇键进行过滤。一种变通方案是先获取某个文件夹中的所有邮件,再在内存中进行筛选,但这种方法对于规模较大的应用并不适用。
我们可以将电子邮件表进行反规范化,拆分为已读邮件表和未读邮件表:
为了支持对话线程,我们可以添加一些头部信息,由邮件客户端解析并用于重建对话线程:
代码块
Plain Text
最后,我们将为我们的分布式数据库牺牲可用性,以换取一致性,因为这对本问题而言是一项硬性要求。
因此,在发生故障转移或网络分区时,受影响的用户将暂时无法执行同步或更新操作。
Email deliverability
搭建一台用于发送邮件的服务器并不难,但要让邮件顺利送达收件人的收件箱却很困难,这是因为垃圾邮件防护算法的存在。
如果我们只是新建一台邮件服务器并开始通过它发送邮件,我们的邮件很可能会被误判为垃圾邮件。
我们可以采取以下措施来避免这种情况:
•
专用IP- 发送邮件时请使用专用IP,否则收件方的邮件服务器将不会信任你。
•
对邮件进行分类——避免将营销邮件从同一服务器发送,以防重要邮件被误判为垃圾邮件
•
逐步激活您的IP地址以在各大邮件服务商处建立良好的信誉。新IP的激活通常需要2至6周时间
•
及时封禁垃圾邮件发送者以免损害您的信誉
•
反馈处理- 与ISP建立反馈机制,实时监控投诉率,并快速封禁垃圾账号。
•
电子邮件身份验证— 采用常见的防钓鱼技术,如发件人策略框架、域名密钥识别邮件等。
你不必记住所有这些内容。只需知道,搭建一台优秀的邮件服务器需要丰富的领域知识。
Search
搜索包括基于邮件内容的全文检索,以及基于发件人、收件人、主题、未读等条件的更高级查询。
电子邮件搜索的一个特点是,它仅限于用户本地使用,且写操作远多于读操作,因为每次操作都需要重新建立索引,但用户很少使用搜索标签页。
让我们比较一下谷歌搜索与电子邮件搜索:
为了实现这一搜索功能,一种方案是使用Elasticsearch集群。我们可以使用user_id作为分区键,将数据分组到同一节点下:
通过 Kafka 实现操作的异步化,以将各服务与重新索引流程解耦。而数据的实际检索则是同步进行的。
Elasticsearch是最受欢迎的搜索引擎数据库之一,能够很好地支持电子邮件的全文搜索。
或者,我们也可以尝试开发一套自定义的搜索解决方案,以满足我们的特定需求。
设计这样一个系统超出了本项目的范围。在构建该系统时,核心挑战之一是如何针对写密集型工作负载进行优化。
为此,我们可以采用日志结构合并树(LSM)来组织磁盘上的索引数据。写入路径仅针对顺序写入进行了优化。这一技术广泛应用于Cassandra、BigTable和RocksDB等系统中。
其核心思想是:在内存中存储数据,直至达到预设的阈值,随后在下一层(磁盘)进行合并:
两种方法之间的主要权衡:
•
Elasticsearch 在一定程度上具有可扩展性,而自定义搜索引擎则可以根据邮件场景进行精细化调优,从而实现更出色的扩展能力。
•
Elasticsearch 是一项我们需要独立维护的服务,与元数据存储并存。定制化的解决方案也可以直接作为数据存储层。
•
Elasticsearch 是一款现成的解决方案,而自定义搜索引擎则需要投入大量工程资源才能构建。
Scalability and availability
由于单个用户的操作不会与其他用户发生冲突,因此大多数组件都可以独立扩展。
为确保高可用性,我们还可以采用多数据中心架构,并在发生故障时实现主从切换:
步骤4:总结
其他讨论要点:
•
容错性- 系统的许多组件都可能失效。值得探讨的是我们如何应对节点故障。
•
合规性- 鉴于欧洲的GDPR法规,个人敏感信息需要以合理的方式进行存储。
•
安全- 邮件加密、防钓鱼、安全浏览等。
•
优化- 例如防止同一附件被不同用户多次发送而重复。