第9章:设计网络爬虫
简介
网络爬虫,也称为蜘蛛或机器人,用于发现并采集网页内容,如网页、图片和视频。本章重点探讨如何设计一款可扩展的网络爬虫,以用于搜索引擎索引。
Applications of Web Crawlers
搜索引擎索引:收集网页以构建可搜索的索引(例如Googlebot)。
网络存档:为未来使用而保存网络数据(例如美国国会图书馆)。
网络挖掘:从网页数据中提取知识(例如,对股东报告进行财务分析)。
网页监控:检测版权或商标侵权行为。
Design Challenges
一个优秀的网络爬虫必须解决:
•
可扩展性:通过并行化处理数十亿个页面。
•
健壮性:应对不良HTML、程序崩溃及恶意链接。
•
礼貌性:避免以过多请求压垮服务器。
•
可扩展性:以最小的改动支持新的内容类型。
步骤1:理解问题
Requirements
每月爬取10亿个网页(每秒400页,峰值800 QPS)。
收集仅含HTML的内容.
跟踪新增和更新的页面。
忽略重复内容。
存储爬取数据长达5年,所需存储空间约30 PB。
步骤2:概要设计
Components
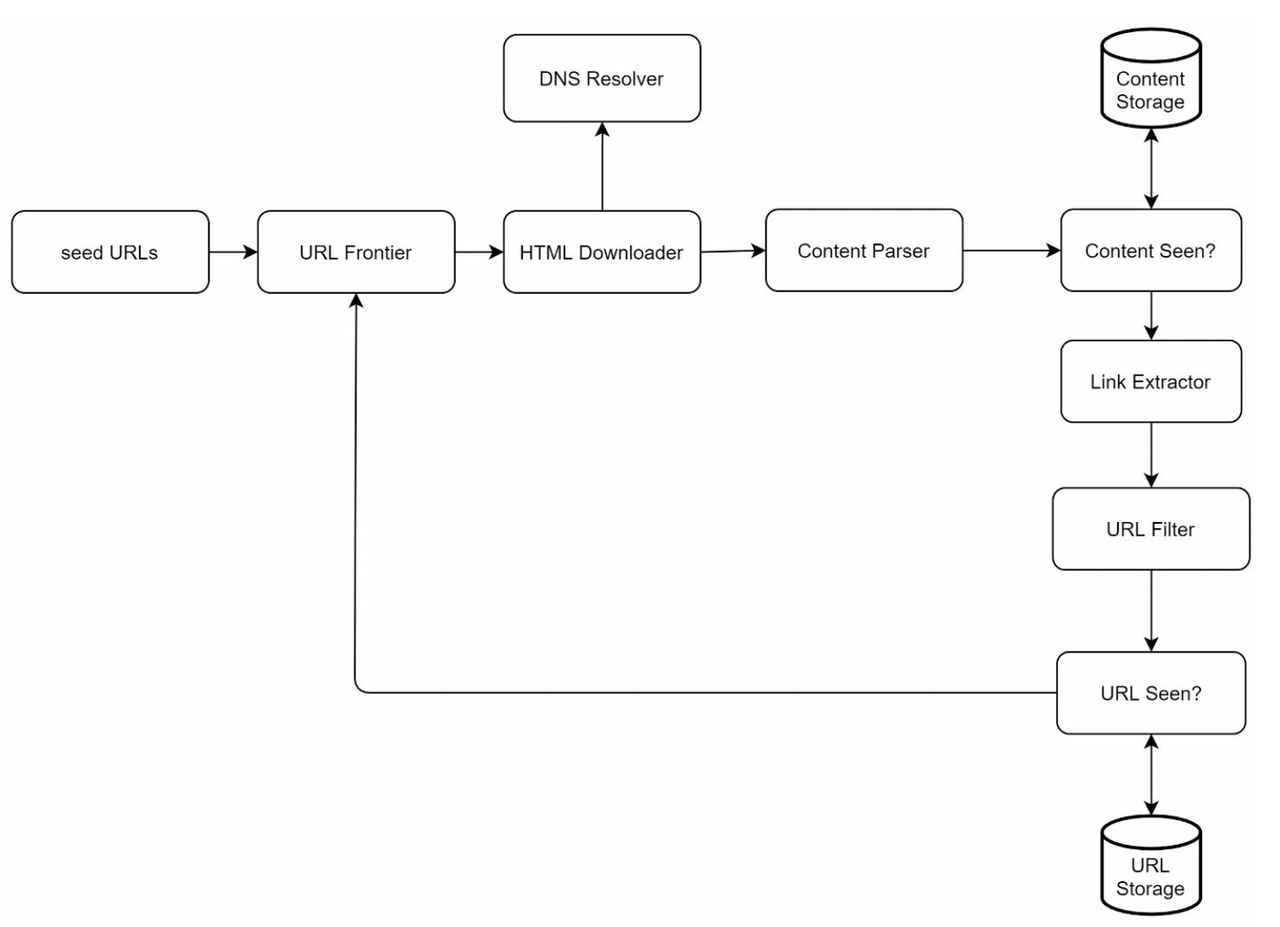
种子URL:爬虫的起始点。
◦
需要进行筛选,作为爬虫遍历尽可能多链接的良好起点。
◦
可以根据不同热门网站的地域性,或按主题进行划分。
◦
策略:按局部性或主题分类(例如,体育、医疗)。
URL 前沿:存储待下载的 URL。
◦
实现为一个FIFO队列.
HTML下载器:从URL Frontier提供的URL中下载网页。
DNS解析器:将URL转换为IP地址。
内容解析器:对网页进行验证与解析。
◦
丢弃格式错误的页面。
是否已查看内容?:通过哈希比较检测重复内容(比较两页网页的哈希值)。
内容存储:将HTML页面存储在磁盘上(热门内容则存入内存以降低延迟)。
URL提取器:从解析后的页面中提取新链接。
URL过滤器:排除被列入黑名单或存在错误的URL。
已访问的URL?用于跟踪已访问的URL,以避免重复。
URL存储:用于存储已访问过的URL。
Workflow
将种子URL添加到URL前沿。
HTML下载器通过DNS解析器获取URL并解析其对应的IP地址。
内容解析器对内容进行校验,并将其传递给“内容是否已查看?”组件。
如果内容是新的,通过URL提取器提取链接。
筛选并将唯一链接添加到URL前沿。
步骤3:深入剖析关键组件
DFS/BFS
•
网络可以被视为一个有向图,其中网页是节点,超链接(URL)则是边。
•
BFS通常用于图的遍历,因为其深度可能非常深,因此DFS并不理想。
•
标准的广度优先搜索并未考虑URL的优先级,因为并非每个页面的质量和重要性都相同。
URL Frontier
•
礼貌性:
◦
确保同一主机在同一时间仅处理一个请求。在两个下载任务之间添加延迟。
◦
使用主机名到队列与工作线程(下载)的映射。
◦
每个下载线程都拥有独立的FIFO队列,且仅从该队列中下载URL。
◦
队列路由器:确保每个队列(b1、b2、…、bn)仅包含来自同一主机的URL。
◦
映射表:它将每个主机映射到一个队列。
◦
队列选择器:每个工作线程都对应一个先进先出(FIFO)队列,且仅从该队列中下载 URL。队列的选择逻辑由队列选择器负责实现。
◦
工作线程1至N。一个工作线程从同一主机依次下载网页。两个下载任务之间可以添加延迟。
•
优先级:
•
新鲜度:根据更新历史或重要性进行重新爬取。
HTML Downloader
•
遵守robots.txt协议:尊重robots.txt文件中的规则。
•
性能优化:
a.
使用多台服务器进行分布式爬取。
b.
使用DNS缓存以避免重复查询。
c.
按地理区域分布爬取服务器,以提升下载速度。
d.
设置较短的超时时间,以规避响应缓慢或无响应的服务器。
Robustness
一致性哈希:在服务器间有效分配负载。
错误处理:防止异常导致系统崩溃。
数据校验:确保内容完整性。
Extensibility
•
为新增内容类型添加模块(例如,PNG下载器、网页监控器)。
•
示例:插入一个模块,用于监测网页内容是否存在版权侵权行为。
Avoiding Problematic Content
重复内容:通过哈希校验进行检测。
爬虫陷阱:采用URL长度限制等技术避免无限循环。
数据噪声:过滤广告、垃圾信息等无关内容。
步骤4:总结
Key Takeaways
网络爬虫必须在可扩展性、健壮性、礼貌性和可扩展性之间取得平衡。
礼貌性可以防止服务器过载,而优先级则确保重要页面被优先抓取。
高效的存储与错误处理对于应对大规模爬取至关重要。
Additional Considerations
•
服务端渲染:处理由 JavaScript 或 AJAX 生成的动态内容。
•
反垃圾措施:排除低质量或无关的页面。
•
数据库分片:通过复制与分片来扩展数据层。
•
水平扩展:使用无状态服务器,高效扩展爬取任务。
•
分析:收集并分析数据,以获取洞察。